近年、企業の機密保持やランニングコストの抜本的抑制を目的に、オープンソースの大規模言語モデル(LLM)を自社インフラや手元の開発機で動かす「ローカルLLM運用」が急速に定着しています。そのローカルLLM運用の事実上の標準エンジンとして世界中で採用されているのが「Ollama(オラマ)」です。
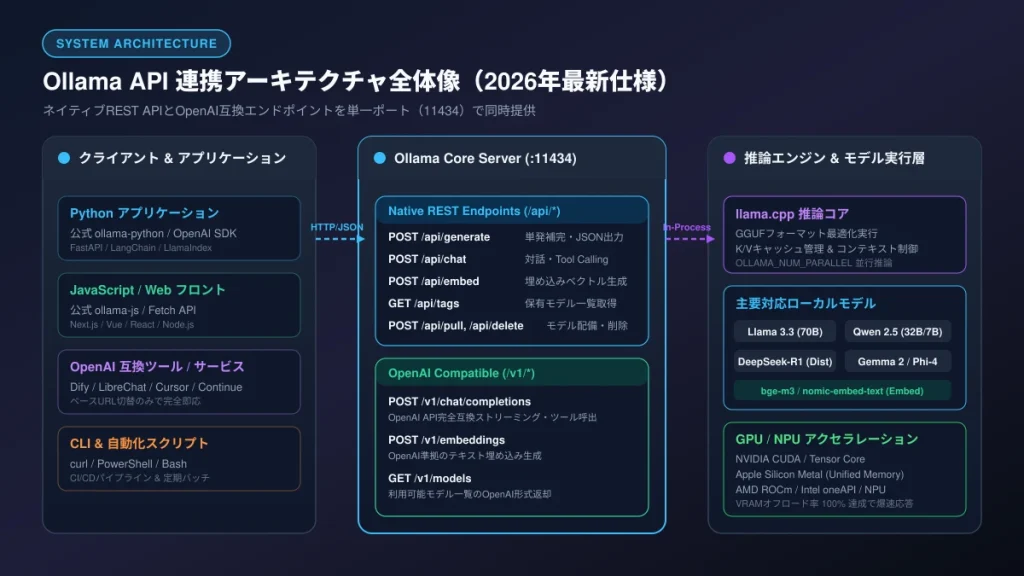
Ollamaの真の価値は、CLIでの単なる対話にとどまりません。バックグラウンドで起動する高性能なローカルHTTPサーバーと充実したREST API群を通じて、Python、JavaScript、Goなどの独自アプリケーションや社内システム、自律型AIエージェントにローカルLLMを自在に組み込める点にあります。さらにOllamaは、独自のエンドポイント(/api/*)だけでなく、OpenAI APIと完全な互換性を持つエンドポイント(/v1/*)を標準で提供しており、既存のLangChainやLlamaIndex、OpenAI SDKを用いたコードのベースURLを差し替えるだけで、完全無料・完全閉域でのLLM推論環境を即座に実現できます。
本記事では、2026年最新仕様のOllama APIについて、基本的な通信アーキテクチャから主要エンドポイント(generate、chat、embed、モデル管理)の完全仕様、Python・JavaScriptによる実践的な実装コード(Pydantic構造化出力やTool Callingを含む)、そして本番運用に欠かせないパフォーマンス最適化(keep_alive/並行数)やリバースプロキシセキュリティまで、開発者が現場で直面する疑問や課題を余すところなく徹底解説します。
Ollama APIの基本概念と2大通信プロトコル(ネイティブREST vs OpenAI互換)
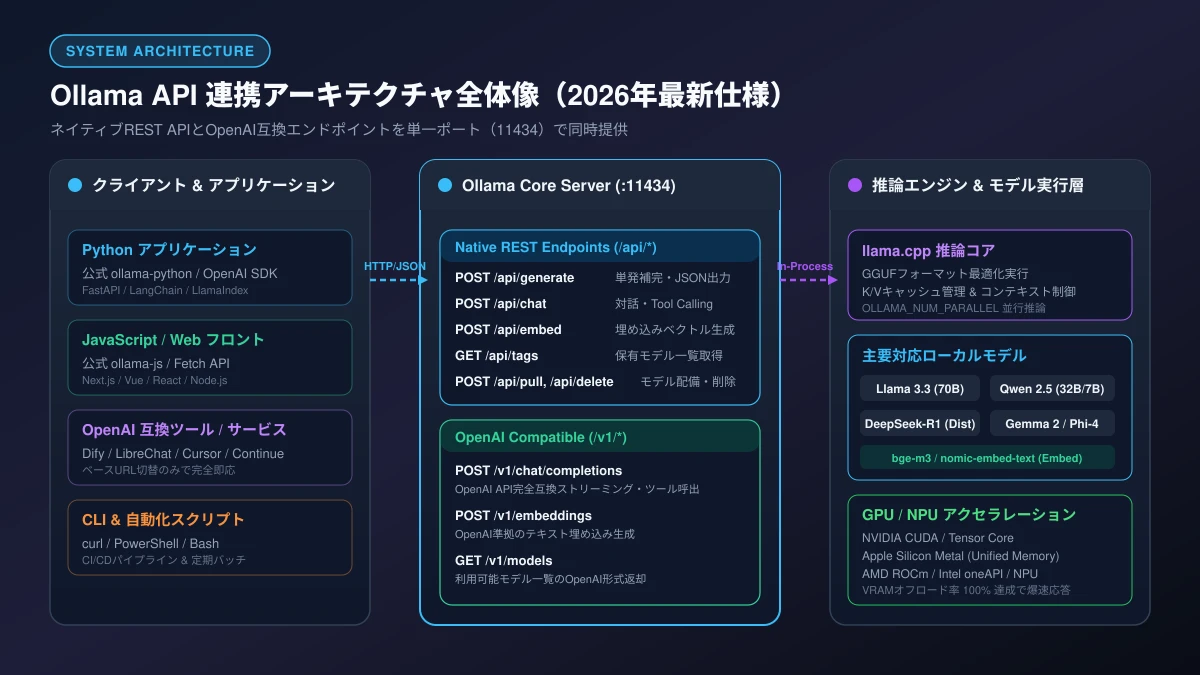
Ollamaは単なるLLM実行バイナリではなく、起動と同時にローカルホスト(デフォルトポート: 11434)でHTTPリクエストを待ち受けるフル機能のRESTful APIサーバーとして機能します。開発者は手元のマシンやオンプレミスサーバーにOllamaを常駐させておくだけで、あらゆるプログラミング言語から安全かつ低遅延に大規模言語モデルを制御できます。
- Ollama APIの動作原理:ローカルRESTサーバーとポート11434
- ネイティブAPI(/api/*)とOpenAI互換(/v1/*)の違いと使い分け
- ストリーミングレスポンス(NDJSON/SSE)の仕組みと低遅延表示
- API利用の前提環境:Ollama起動と事前モデル配備
Ollama APIの動作原理:ローカルRESTサーバーとポート11434
Ollamaをインストールして起動すると、バックグラウンドデーモンが立ち上がり、デフォルトで 127.0.0.1:11434(ローカルホストのポート11434)をリッスンします。内部的には超高速なC++推論コアである llama.cpp が組み込まれており、受け取ったHTTPリクエストをプロセス内メモリでダイレクトに推論パイプラインへ受け渡します。
このアーキテクチャにより、ネットワークの外部通信オーバーヘッドが一切発生せず、リクエスト送信から最初の1トークン生成(TTFT: Time To First Token)までのレイテンシを極限まで短縮できます。また、すべての通信がローカルマシン(または社内閉域網)内で完結するため、機密コードや顧客データ、個人情報が社外の外部クラウドサーバーに漏洩するリスクを物理的に遮断できるのが最大の強みです。
ポート設定や外部からのアクセス許可方法については、環境変数 OLLAMA_HOST で柔軟に変更可能です(詳細はH2-5で後述)。
ネイティブAPI(/api/*)とOpenAI互換(/v1/*)の違いと使い分け
Ollama APIを導入する際、最初に把握すべき最も重要な概念が「ネイティブAPI」と「OpenAI互換API」の2つのプロトコル体系です。Ollamaは同一のポート(11434)上で、この両方のパス体系を同時に提供しています。
| 項目 | ネイティブAPI(/api/*) |
OpenAI互換API(/v1/*) |
|---|---|---|
| 主要パス | /api/generate, /api/chat, /api/embed, /api/tags |
/v1/chat/completions, /v1/embeddings, /v1/models |
| クライアントSDK | 公式 ollama-python, ollama-js, cURL |
公式 openai SDK, LangChain, LlamaIndex, Dify |
| ストリーミング形式 | NDJSON(Newline Delimited JSON) | SSE(Server-Sent Events: data: ...) |
| 独自機能の対応 | ◎ Modelfile作成、動的Pull/Delete、詳細推論統計 | △ 推論機能のみ対応(管理機能は非対応) |
| 移行コスト | Ollama専用設計が必要 | ◎ base_url の書き換えのみ(ゼロコード変更) |
新規にOllamaの機能をフル活用した自社アプリを組む場合や、モデルの遠隔ロード・Pydantic構造化JSON出力を多用する場合は「ネイティブAPI」を推奨します。一方で、既にOpenAIのAPIを使って組まれている社内システムや、『Dify×Ollama連携』などのサードパーティGUIツールに組み込む場合は「OpenAI互換API」を利用するのが最も手軽で安全です。
ストリーミングレスポンス(NDJSON/SSE)の仕組みと低遅延表示
LLMの出力テキストは、全体の生成が完了するまでに数秒から数十秒の時間を要することが一般的です。ユーザーに快適なUI体験(UX)を提供するためには、生成されたトークンから1文字ずつリアルタイムに画面へ描画する「ストリーミング」が不可欠です。
OllamaのネイティブAPI(/api/generate, /api/chat)では、デフォルトでストリーミングが有効("stream": true)になっており、レスポンスは「NDJSON(改行区切りJSON)」形式で1行ずつチャンクとして返却されます。クライアント側はHTTPコネクションを切断することなく、改行コードを受信するたびにJSONとしてパースして画面に逐次反映します。
一方、/v1/chat/completions 経由で "stream": true を指定した場合は、OpenAI仕様に準拠した「SSE(Server-Sent Events)」形式(data: {"choices": [{"delta": {"content": "..."}}]}
)で返却されるため、OpenAI互換の既存フロントエンドライブラリでも何ら手を加えることなくそのままストリーミングが動作します。
API利用の前提環境:Ollama起動と事前モデル配備
Ollama APIを利用するには、大前提としてローカル環境にOllamaが正常にインストールされ、APIで呼び出す対象のLLMモデルが手元にプルされている必要があります。
ターミナルで以下のコマンドを実行し、デーモンが稼働しているかを確認します。
# サーバー稼働確認(ヘルスチェック)
curl http://localhost:11434/

# 出力結果: "Ollama is running" が返れば準備完了
まだ推論対象のモデルが存在しない場合は、CLIコマンドでモデルをローカルキャッシュにダウンロードしておきます。日本語性能が高く推論効率に優れた qwen2.5:7b や、Meta社の最新 llama3.3:70b がおすすめです。
# 推論用モデルをダウンロード
ollama pull qwen2.5:7b

# 埋め込み(Embedding/RAG)用モデルをダウンロード
ollama pull bge-m3CLIの基本コマンド体系や詳細なオプションについては、関連記事『Ollamaコマンド完全ガイド』や『Ollamaおすすめモデル一覧』も併せてご参照ください。
主要エンドポイント完全仕様:generate・chat・embed・モデル管理
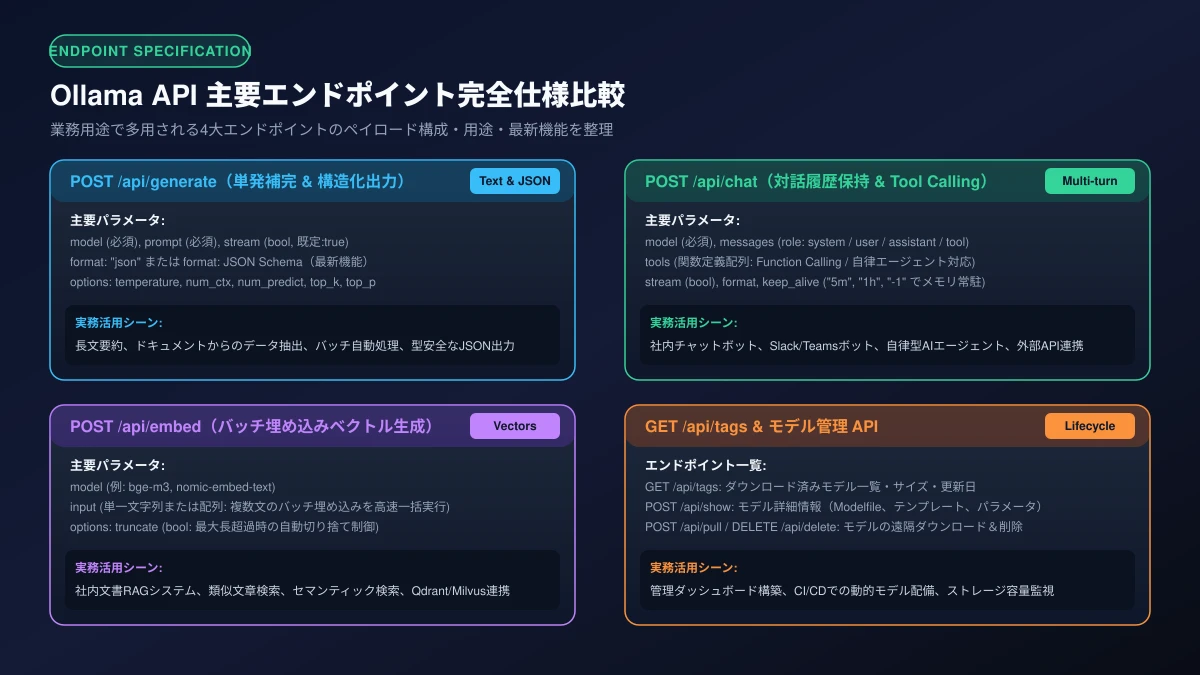
OllamaネイティブAPIのコアとなる4大エンドポイントのHTTPメソッド、リクエストJSONペイロードの構造、主要オプション、および返却されるレスポンス仕様を詳細に解剖します。
- テキスト補完:/api/generate の主要パラメータとストリーミング制御
- 対話&関数呼び出し:/api/chat のメッセージ履歴とTool Calling
- ベクトル埋め込み:/api/embed による高密度エンベディングとRAG連携
- モデル管理:/api/tags, /api/show, /api/pull, /api/delete の制御
テキスト補完:/api/generate の主要パラメータとストリーミング制御
POST /api/generate は、渡されたプロンプトに対してテキスト補完(文章生成)を行う最もプリミティブなエンドポイントです。ドキュメントの要約、分類、データ変換、翻訳などのバッチ処理に最適です。
curl http://localhost:11434/api/generate -d '{
  "model": "qwen2.5:7b",
  "prompt": "なぜ空は青いのですか?小学生にもわかるように1文で説明してください。",
  "stream": false,
  "options": {
    "temperature": 0.3,
    "num_predict": 100
  }
}'
主要なリクエストパラメータは以下の通りです:
model(string, 必須): 使用するモデル名(例:"qwen2.5:7b","llama3.3")。prompt(string, 必須): LLMに渡すプロンプト文字列。stream(boolean, 任意):trueでNDJSONストリーミング、falseで生成完了後に一括返却。format(string / object, 任意):"json"を指定するとJSON出力を強制。さらに2026年最新バージョンでは JSON Schemaオブジェクト を直接渡すことで、指定した型定義に完全準拠した構造化出力(Structured Outputs)が可能です。system(string, 任意): モデルの挙動を方向付けるシステムプロンプト。options(object, 任意):temperature(創造性: 0.0〜1.0)、num_ctx(コンテキスト窓サイズ: 例 8192)、num_predict(最大生成トークン数)などのハイパーパラメータ。
stream: false 時のレスポンスには、生成されたテキスト(response)に加え、総評価トークン数(eval_count)や推論時間(eval_duration)など詳細なパフォーマンスメトリクスが含まれて返却されます。
対話&関数呼び出し:/api/chat のメッセージ履歴とTool Calling
POST /api/chat は、チャットボットや対話型アシスタントを構築するためのエンドポイントです。過去の会話履歴(messages 配列)を保持したままリクエストを送信できるほか、外部関数を呼び出す「Tool Calling(Function Calling)」をネイティブサポートしています。
curl http://localhost:11434/api/chat -d '{
  "model": "qwen2.5:7b",
  "messages": [
    {"role": "system", "content": "あなたは親切なAIアシスタントです。"},
    {"role": "user", "content": "東京の現在の天気を調べてください。"},
    {"role": "assistant", "content": "天気を調べるためにツールを呼び出します。",
      "tool_calls": [
        {
          "function": {
            "name": "get_current_weather",
            "arguments": {"location": "Tokyo"}
          }
        }
      ]
    },
    {"role": "tool", "content": "{"temperature": 22, "condition": "晴れ"}"}
  ],
  "stream": false
}'
messages 配列内の各要素は、role(system, user, assistant, tool)と content を持ちます。tools パラメータに関数定義スキーマ(JSON Schema)を渡すことで、LLMは必要な引数を自動的に抽出し、自律型AIエージェントの意思決定エンジンとして機能します。
ベクトル埋め込み:/api/embed による高密度エンベディングとRAG連携
RAG(検索拡張生成)システムや社内文書のセマンティック検索を構築する上で欠かせないのが、テキストを高次元ベクトルに変換する埋め込みAPIです。従来の /api/embeddings に代わり、最新のOllamaでは複数テキストの一括高速処理に対応した POST /api/embed が標準提供されています。
curl http://localhost:11434/api/embed -d '{
  "model": "bge-m3",
  "input": [
    "ローカルLLMを安全に社内導入する手順",
    "Ollama APIを用いたPythonバックエンド開発"
  ],
  "truncate": true
}'
レスポンスの embeddings フィールドには、各入力文に対応する浮動小数点数配列(ベクトル)が返却されます。これを Qdrant、Chroma、pgvector(PostgreSQL)などのベクトルデータベースに登録することで、ミリ秒単位での高精度な類似文章検索が実現します。詳細なDB連携については『MCP × PostgreSQL完全攻略ガイド』もご活用ください。
モデル管理:/api/tags, /api/show, /api/pull, /api/delete の制御
Ollama APIは推論だけでなく、ホストマシン上のモデルライフサイクル全体をプログラムから遠隔管理するエンドポイントを備えています。
GET /api/tags: ホストマシン上にダウンロード済みのモデル一覧、サイズ、ハッシュ値、更新日を取得します。社内管理ダッシュボードなどで利用可能モデルを一覧表示する際に必須です。POST /api/show: 指定したモデルの詳細情報(パラメータ数、Modelfile内容、コンテキスト長、システムテンプレート)を取得します。POST /api/pull: 公式レジストリから新しいモデルをバックグラウンドでダウンロードします。進捗状況(ダウンロード済みバイト数・総バイト数)がNDJSONストリームで逐次通知されます。DELETE /api/delete: 不要になったモデルをディスクから削除し、ストレージ容量を即座に解放します。
独自のModelfileからモデルを自動ビルドしたい場合は、関連記事『ollama createコマンド完全攻略』の手順がそのままAPIでも応用できます。
PythonによるOllama API実装完全ガイド(公式SDK・OpenAI SDK・Pydantic構造化出力)
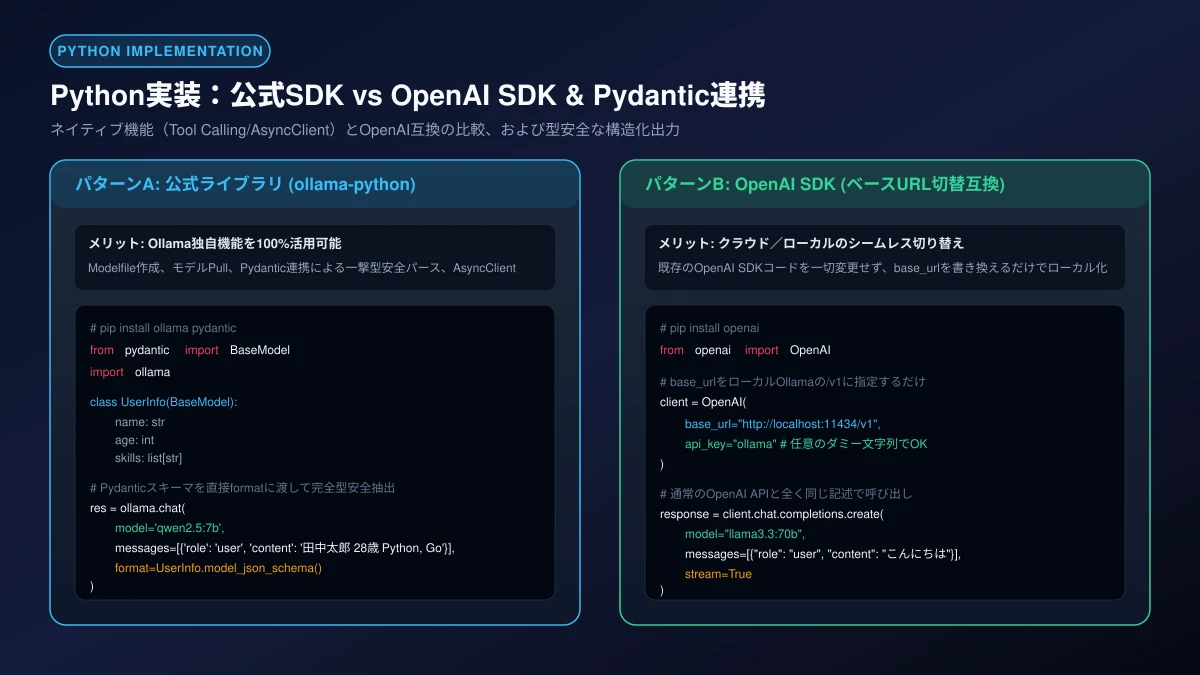
PythonはAI/LLM開発におけるデファクトスタンダード言語です。Ollama APIをPythonから呼び出す場合、「公式 ollama-python ライブラリ」を使用する方法と、「OpenAI公式 SDK」を流用する方法の2大アプローチが存在します。それぞれの実装コードと、実務で極めて需要の高い「Pydanticを用いた型安全な構造化JSON出力」を解説します。
- 公式ライブラリ ollama-python の導入と Client / AsyncClient 活用法
- Pythonでのストリーミングテキスト出力とプログレス表示の実装
- PydanticとJSON Schemaを用いた完全型安全な構造化出力の実現
- OpenAI Python SDKの base_url 切り替えによるゼロコード変更移行
公式ライブラリ ollama-python の導入と Client / AsyncClient 活用法
Ollama公式がメンテナンスしているPythonライブラリ ollama は、ネイティブAPIの全機能を直感的なPythonインターフェースでラップしています。FastAPIなどの非同期Webフレームワークと親和性の高い AsyncClient も標準装備されています。
pip install ollama同期呼び出し(ollama.chat)と非同期呼び出し(AsyncClient)の最小実装コードは以下の通りです。
import asyncio
from ollama import Client, AsyncClient

# 1. 同期クライアントの基本使用法
def run_sync():
    client = Client(host='http://localhost:11434')
    response = client.chat(
        model='qwen2.5:7b',
        messages=[{'role': 'user', 'content': 'Pythonのデコレータとは何ですか?簡潔に解説してください。'}]
    )
    print("【同期応答】:")
    print(response['message']['content'])

# 2. 非同期クライアント(FastAPI等のバックエンド向け)
async def run_async():
    async_client = AsyncClient(host='http://localhost:11434')
    response = await async_client.chat(
        model='qwen2.5:7b',
        messages=[{'role': 'user', 'content': '非同期処理のメリットを3つ箇条書きで教えてください。'}]
    )
    print("
【非同期応答】:")
    print(response['message']['content'])

if __name__ == "__main__":
    run_sync()
    asyncio.run(run_async())
Client(host='...') を省略した場合は、自動的に環境変数 OLLAMA_HOST または http://127.0.0.1:11434 が参照されます。
Pythonでのストリーミングテキスト出力とプログレス表示の実装
コマンドラインツールや対話型シェルを開発する際、トークン生成に合わせてリアルタイムに文字を出力するには stream=True を指定します。
import sys
import ollama

def stream_chat():
    stream = ollama.chat(
        model='qwen2.5:7b',
        messages=[{'role': 'user', 'content': 'マイクロサービスアーキテクチャのメリットとデメリットを詳しく教えてください。'}],
        stream=True
    )

    print("AIの回答: ", end="", flush=True)
    for chunk in stream:
        content = chunk['message']['content']
        sys.stdout.write(content)
        sys.stdout.flush()
    print()

if __name__ == "__main__":
    stream_chat()
stream=True を渡すと、戻り値はジェネレータ(Generator)となり、for chunk in stream ループで即座に生成トークンを取得できます。これにより、全体の生成に時間がかかる長文回答でも、ユーザーを待たせることなく即時フィードバックを提供できます。
PydanticとJSON Schemaを用いた完全型安全な構造化出力の実現
近年の実務AI開発において最も強力な機能の一つが、「構造化出力(Structured Outputs)」です。Ollama 0.5以降では、Pydanticのモデルスキーマを format 引数に渡すことで、LLMの出力が指定したJSONスキーマに100%厳密に一致することを保証します。
import json
from pydantic import BaseModel, Field
import ollama

# 抽出したいデータの型定義
class TechnologyEvaluation(BaseModel):
    name: str = Field(description="技術やツールの名称")
    category: str = Field(description="カテゴリ(言語/フレームワーク/データベース等)")
    strengths: list[str] = Field(description="主要な強み・長所リスト")
    weaknesses: list[str] = Field(description="主要な弱み・課題リスト")
    suitability_score: int = Field(description="実務導入おすすめスコア(1〜100)")

prompt = '''以下のテキストから技術評価データを抽出し、JSON形式で整理してください。
「FastAPIはPythonの近代的なWebフレームワークで、型ヒントと非同期処理(async/await)により
非常に高いパフォーマンスを誇る。学習コストも比較的低いが、大規模エンタープライズでの
設計ノウハウやエコシステムの歴史はDjangoほど深くない。実務での採用価値は非常に高い。」'''

response = ollama.chat(
    model='qwen2.5:7b',
    messages=[{'role': 'user', 'content': prompt}],
    format=TechnologyEvaluation.model_json_schema(), # PydanticのJSON Schemaを直接渡す
    options={'temperature': 0.1} # 確実性を高めるため低めの温度を設定
)

# レスポンスのJSON文字列を直接Pydanticモデルに流し込みバリデーション
raw_json = response['message']['content']
data = TechnologyEvaluation.model_validate_json(raw_json)

print("【パース成功 - 型安全なPythonオブジェクト】:")
print(f"技術名: {data.name} ({data.category})")
print(f"スコア: {data.suitability_score}/100")
print(f"強み: {', '.join(data.strengths)}")
print(f"弱み: {', '.join(data.weaknesses)}")正規表現や手作業での文字列クリーニングが一切不要となり、データ抽出パイプラインやRPA連携の堅牢性が劇的に向上します。『Ollama×Qwen 2.5完全攻略』で紹介しているモデルと組み合わせることで、日本語のニュアンスも極めて高精度に構造化可能です。
OpenAI Python SDKの base_url 切り替えによるゼロコード変更移行
既にOpenAIの openai パッケージを使用して開発された既存システムをローカルOllamaに移行する場合、コードの書き換えは実質「2行(base_urlとapi_key)」で完了します。
from openai import OpenAI

# base_url をローカルOllamaの/v1に指定するだけ
client = OpenAI(
    base_url="http://localhost:11434/v1",
    api_key="ollama" # OpenAI SDKのバリデーションを通過させるための任意のダミー値
)

completion = client.chat.completions.create(
    model="qwen2.5:7b",
    messages=[
        {"role": "system", "content": "あなたは優秀なエンジニアです。"},
        {"role": "user", "content": "Dockerコンテナのメモリ制限方法を教えてください。"}
    ],
    temperature=0.7
)

print(completion.choices[0].message.content)
環境変数の OPENAI_BASE_URL="http://localhost:11434/v1" を設定するだけで、ソースコードを1行も改変せずに社内ツール全体を完全ローカル化することも可能です。
JavaScript / TypeScriptによるフロントエンド&Node.js連携
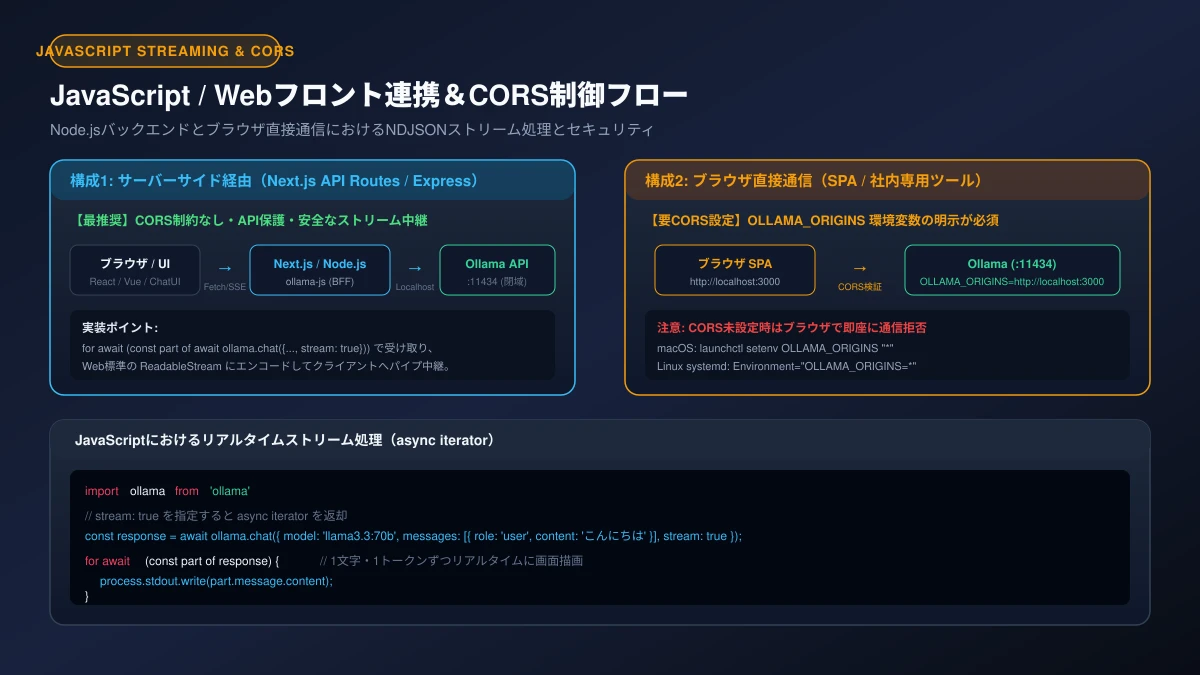
Webアプリケーションのフロントエンド(React/Next.js/Vue)やNode.jsバックエンドからOllama APIを呼び出す手順を解説します。公式 ollama-js パッケージの使い方、リアルタイムなストリーミング処理、そしてWebブラウザから直接通信する際に必ず直面する「CORS(Cross-Origin Resource Sharing)の壁」の突破法を体系化しました。
- 公式 ollama-js のセットアップとNode.js / ブラウザ環境での利用法
- async iterator と ReadableStream によるリアルタイム逐次描画
- format: “json” と Zod を組み合わせたフロントエンドデータ連携
- ブラウザ直通信で必須となる CORS(OLLAMA_ORIGINS)の安全な設定手順
公式 ollama-js のセットアップとNode.js / ブラウザ環境での利用法
JavaScript/TypeScript環境では、公式npmパッケージ ollama(ブラウザ環境向けの ollama/browser も同梱)を使用します。
npm install ollamaNode.js環境での最もシンプルなチャット呼び出しコードは以下の通りです。
import ollama from 'ollama';

async function main() {
  const response = await ollama.chat({
    model: 'qwen2.5:7b',
    messages: [{ role: 'user', content: 'TypeScriptの型パズルとは何ですか?' }],
  });
  console.log(response.message.content);
}

main();リモートホストや特定ポートのOllamaを指定したい場合は、new Ollama({ host: 'http://192.168.1.100:11434' }) のようにインスタンス化して利用できます。デスクトップGUI環境との連携については『OllamaおすすめGUI完全比較』も参考にしてください。
async iterator と ReadableStream によるリアルタイム逐次描画
ollama-js で stream: true を指定すると、戻り値は AsyncIterable(非同期イテレータ)となります。for await...of 構文を用いて、届いたチャンクから即座に画面へ追記描画できます。
import ollama from 'ollama';

async function streamResponse() {
  const response = await ollama.chat({
    model: 'qwen2.5:7b',
    messages: [{ role: 'user', content: 'Next.js App Routerの設計思想を解説してください。' }],
    stream: true,
  });

  for await (const part of response) {
    process.stdout.write(part.message.content);
  }
  console.log();
}

streamResponse();
Next.jsのAPI Route(Route Handler)で中継する場合は、この非同期イテレータをWeb標準の ReadableStream に変換して返却することで、Vercel AI SDK等と完全に協調動作させることが可能です。
format: “json” と Zod を組み合わせたフロントエンドデータ連携
フロントエンドでフォーム入力の自動補完やタスク分解AIを組む際、TypeScriptの世界で定番のバリデーションライブラリ Zod と組み合わせることで、完全型安全なUIデータバインディングが実現します。
import ollama from 'ollama';
import { z } from 'zod';

const TaskSchema = z.object({
  title: z.string(),
  priority: z.enum(['low', 'medium', 'high']),
  estimatedMinutes: z.number(),
  subtasks: z.array(z.string()),
});

type Task = z.infer;

async function generateStructuredTask(goal: string): Promise {
  const response = await ollama.chat({
    model: 'qwen2.5:7b',
    messages: [
      { role: 'system', content: '目標を分解し、指定されたJSON構造で出力してください。' },
      { role: 'user', content: goal },
    ],
    format: 'json',
  });

  const raw = JSON.parse(response.message.content);
  return TaskSchema.parse(raw); // Zodで実行時バリデーション
}
ブラウザ直通信で必須となる CORS(OLLAMA_ORIGINS)の安全な設定手順
ReactやVueで作成したブラウザSPAから、バックエンドサーバーを介さずに直接 http://localhost:11434 へFetchリクエストを送る場合、ブラウザのセキュリティ機構(CORS)によって通信が即座にブロックされます。
これを許可するには、Ollamaサービス起動時の環境変数 OLLAMA_ORIGINS にアクセス元のオリジンを指定する必要があります。
| OS / 環境 | CORS許可設定コマンド・手順 |
|---|---|
| macOS (GUIアプリ) | ターミナルで launchctl setenv OLLAMA_ORIGINS "http://localhost:3000,http://127.0.0.1:3000" を実行後、Ollamaアプリを再起動 |
| Linux (systemd) | systemctl edit ollama.service を開き、[Service] セクションに Environment="OLLAMA_ORIGINS=*" を追記してリロード |
| Windows | システム環境変数に変数名 OLLAMA_ORIGINS、値 http://localhost:3000 を追加してタスクトレイからOllama再起動 |
| Docker | コンテナ起動オプションに -e OLLAMA_ORIGINS="*" を追加 |
※開発環境以外で "*"(全オリジン許可)を指定すると、悪意あるWebサイトからローカルのOllamaが不正利用される恐れがあるため、本番・社内LAN環境では必ず特定のオリジン(例: "https://ai-internal.company.com")を明示的に指定してください。
実務・本番運用のためのパフォーマンス最適化とセキュリティガバナンス
Ollama APIを個人開発の検証用途から、チーム開発や社内本番業務システムへとスケールアップする際には、サーバーリソースの枯渇を防ぐ最適化設定と、強固なアクセス制限・認証設計が必須となります。
- OLLAMA_KEEP_ALIVE と OLLAMA_NUM_PARALLEL による応答速度とスループット最適化
- num_ctx と num_gpu パラメータによるVRAM消費と文脈長のバランス調整
- Nginx / Caddy リバースプロキシによる HTTPS 化と API キー認証の実装
- 接続エラー・タイムアウト・CORS拒否のトラブルシューティング完全対処法
OLLAMA_KEEP_ALIVE と OLLAMA_NUM_PARALLEL による応答速度とスループット最適化
Ollamaは推論リクエストが完了した後、デフォルトで5分間モデルをVRAM(GPUメモリ)上に保持(常駐)し、その後自動的にアンロードしてメモリをOSに返却します。しかし、高頻度でAPIが叩かれる環境では、モデルの再ロード(ディスクからVRAMへの読み込み)が頻繁に発生し、初回応答の遅延(数秒〜数十秒のオーバーヘッド)に繋がります。
これを防ぐため、サーバー起動環境変数またはAPIリクエストパラメータで keep_alive を制御します。
# サーバー環境変数で恒久的にメモリ常駐させる場合(Linux systemd例)
Environment="OLLAMA_KEEP_ALIVE=-1" # -1 で無期限常駐(サーバー停止まで解放しない)

# またはリクエストごとに指定
curl http://localhost:11434/api/generate -d '{
  "model": "qwen2.5:7b",
  "prompt": "Hello",
  "keep_alive": "1h"
}'
さらに、社内複数ユーザーからの同時リクエストを処理するためには、並行推論数 OLLAMA_NUM_PARALLEL を引き上げます(既定値: 1 または 4)。VRAM容量に余裕があるGPU(RTX 4090やA100等)であれば、OLLAMA_NUM_PARALLEL=4 や OLLAMA_MAX_LOADED_MODELS=2 を設定することで、複数モデルの同時ロードや並行推論のスループットが飛躍的に向上します。
num_ctx と num_gpu パラメータによるVRAM消費と文脈長のバランス調整
Ollamaのデフォルトコンテキスト窓サイズ(文脈長)は、一般的に 2048トークン に設定されています。長文の社内ドキュメント要約やRAG用途ではコンテキストが不足するため、num_ctx オプションで拡大する必要があります。
# 8K(8192トークン)や 16K(16384トークン)へ拡張
response = ollama.chat(
    model='qwen2.5:7b',
    messages=[{'role': 'user', 'content': large_document_prompt}],
    options={
        'num_ctx': 8192,  # コンテキスト長を8Kに拡大
        'num_gpu': 99     # すべてのレイヤーをGPUにオフロード
    }
)ただし、コンテキスト窓を拡大すると、モデル自体のサイズに加えてK/Vキャッシュ(Key-Value Cache)が消費するVRAM容量が急激に増大します。VRAMが枯渇すると一部のレイヤーがシステムRAM(CPU)へオフロードされ、推論速度が1/10以下に激減するため、利用マシンのVRAM残量と相談しながら最適な num_ctx を選定することが極めて重要です。
Nginx / Caddy リバースプロキシによる HTTPS 化と API キー認証の実装
Ollama本体には、ユーザー認証やAPIキー検証、SSL/TLS(HTTPS)暗号化の機能が意図的に組み込まれていません。社内LANや外部から安全にOllama APIを利用するには、前段に Nginx や Caddy などのリバースプロキシを配置し、セキュリティゲートウェイを構築するのが業界標準のベストプラクティスです。
以下は、Nginxを用いて Bearer トークン認証(APIキー)とHTTPS通信を強制する設定例です。
# /etc/nginx/conf.d/ollama.conf
server {
    listen 443 ssl http2;
    server_name ollama.internal.company.com;

    ssl_certificate     /etc/ssl/certs/internal.crt;
    ssl_certificate_key /etc/ssl/certs/internal.key;

    # 簡易Bearerトークン検証
    set $auth_token "Bearer sk-my-secure-company-token-2026";

    location / {
        if ($http_authorization != $auth_token) {
            return 401 '{"error": "Unauthorized: Invalid API Key"}';
        }

        proxy_pass http://127.0.0.1:11434;
        proxy_http_version 1.1;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection 'upgrade';
        proxy_set_header Host $host;

        # ストリーミングが途切れないようバッファリングを無効化
        proxy_buffering off;
        proxy_cache off;
        proxy_read_timeout 600s;
    }
}
proxy_buffering off; を忘れると、Nginxがレスポンス全体を受信するまでキャッシュしてしまい、Ollamaのストリーミング表示が効かなくなるため注意してください。また、VS Codeやエディタ側の連携については『GitHub Copilot×MCP完全ガイド』や『mcp.json徹底解説』も参考になります。
接続エラー・タイムアウト・CORS拒否のトラブルシューティング完全対処法
API連携時にエンジニアが遭遇しやすい3大トラブルと、その即効解決策をまとめました。
| エラー事象 | 主な原因 | 解決策 |
|---|---|---|
ECONNREFUSED 127.0.0.1:11434 |
Ollamaデーモンが未起動、またはクラッシュしている | ollama serve または systemctl status ollama で稼働状態を確認し再起動 |
Blocked by CORS policy |
Webフロントからのオリジンが未許可 | OLLAMA_ORIGINS="http://localhost:3000" を設定してサービス再起動 |
Gateway Timeout (504) / Read Timeout |
巨大モデル初回ロード時、またはGPUオフロード失敗による推論詰まり | クライアント側タイムアウトを600秒以上に設定し、OLLAMA_KEEP_ALIVE=-1 で常駐化 |
Model not found (404) |
指定したタグやモデルが未プル、またはタグ名のタイポ | curl http://localhost:11434/api/tags で一覧を確認し、正確な名前を指定 |
まとめ
Ollama APIは、単なるローカルでのLLM実行環境を超え、機密性・低遅延・ゼロコスト運用を同時に達成する「自律型AI・LLM基盤の強力な選択肢」として進化を遂げています。
ネイティブREST API(/api/generate, /api/chat, /api/embed)によるPydantic構造化出力やTool Calling、そしてOpenAI互換エンドポイント(/v1/*)による既存ライブラリからのスムーズな移行性を理解し、keep_alive やリバースプロキシを活用することで、堅牢な業務レベルのAIシステムを構築できます。
まずは手元の開発機で ollama run や簡単なPythonスクリプトからAPI連携を試し、次世代のローカルAI駆動開発をスタートさせましょう。
社内AI導入・ローカルLLM環境構築に関するご相談はこちら
自社専用の閉域LLMサーバー構築、Ollama APIと社内システムの連携開発、セキュアなAIエージェント設計でお困りの際は、ぜひお気軽にお問い合わせください。