(最終更新日: 2026年08月28日)
「社外秘の機密データや顧客情報を扱うため、外部クラウドにデータを送信しない完全ローカル環境でAIアプリを構築したい」とお考えではありませんか?
2026年最新のオープンモデル(Llama 3.3、Qwen 2.5、DeepSeek-R1)の進化により、ローカルLLM実行基盤『Ollama』とノーコード開発基盤『Dify』を組み合わせることで、商用クラウド級のAI環境を自社内に完全閉域網で構築できるようになりました。
API従量課金ゼロの完全固定費運用が可能になり、社内規定マニュアルやソースコードを安全に検索・要約するセキュアな社内RAG環境をノーコードで素早く立ち上げられます。
本記事では、DifyとOllamaの連携アーキテクチャから、Dockerネットワーク(host.docker.internal)接続設定、VRAMハードウェア要件、実務チャットアプリ構築、エンタープライズガバナンスまでプロの視点で徹底解説します。
この記事を読めば、外部通信ゼロの安全で高性能な自社専用ローカルAI基盤を最短ルートで運用できるようになります!
DifyとOllamaの役割の違いと全体像をサクッと把握する
当セクションでは、DifyとOllamaのそれぞれの役割と連携アーキテクチャの全体像を解説します。
両者の強みを正しく理解することで、無駄のないローカルAI開発環境を設計できるからです。
- Difyとは?:LLMアプリ開発の“土台”になるノーコード+LLMOpsプラットフォーム
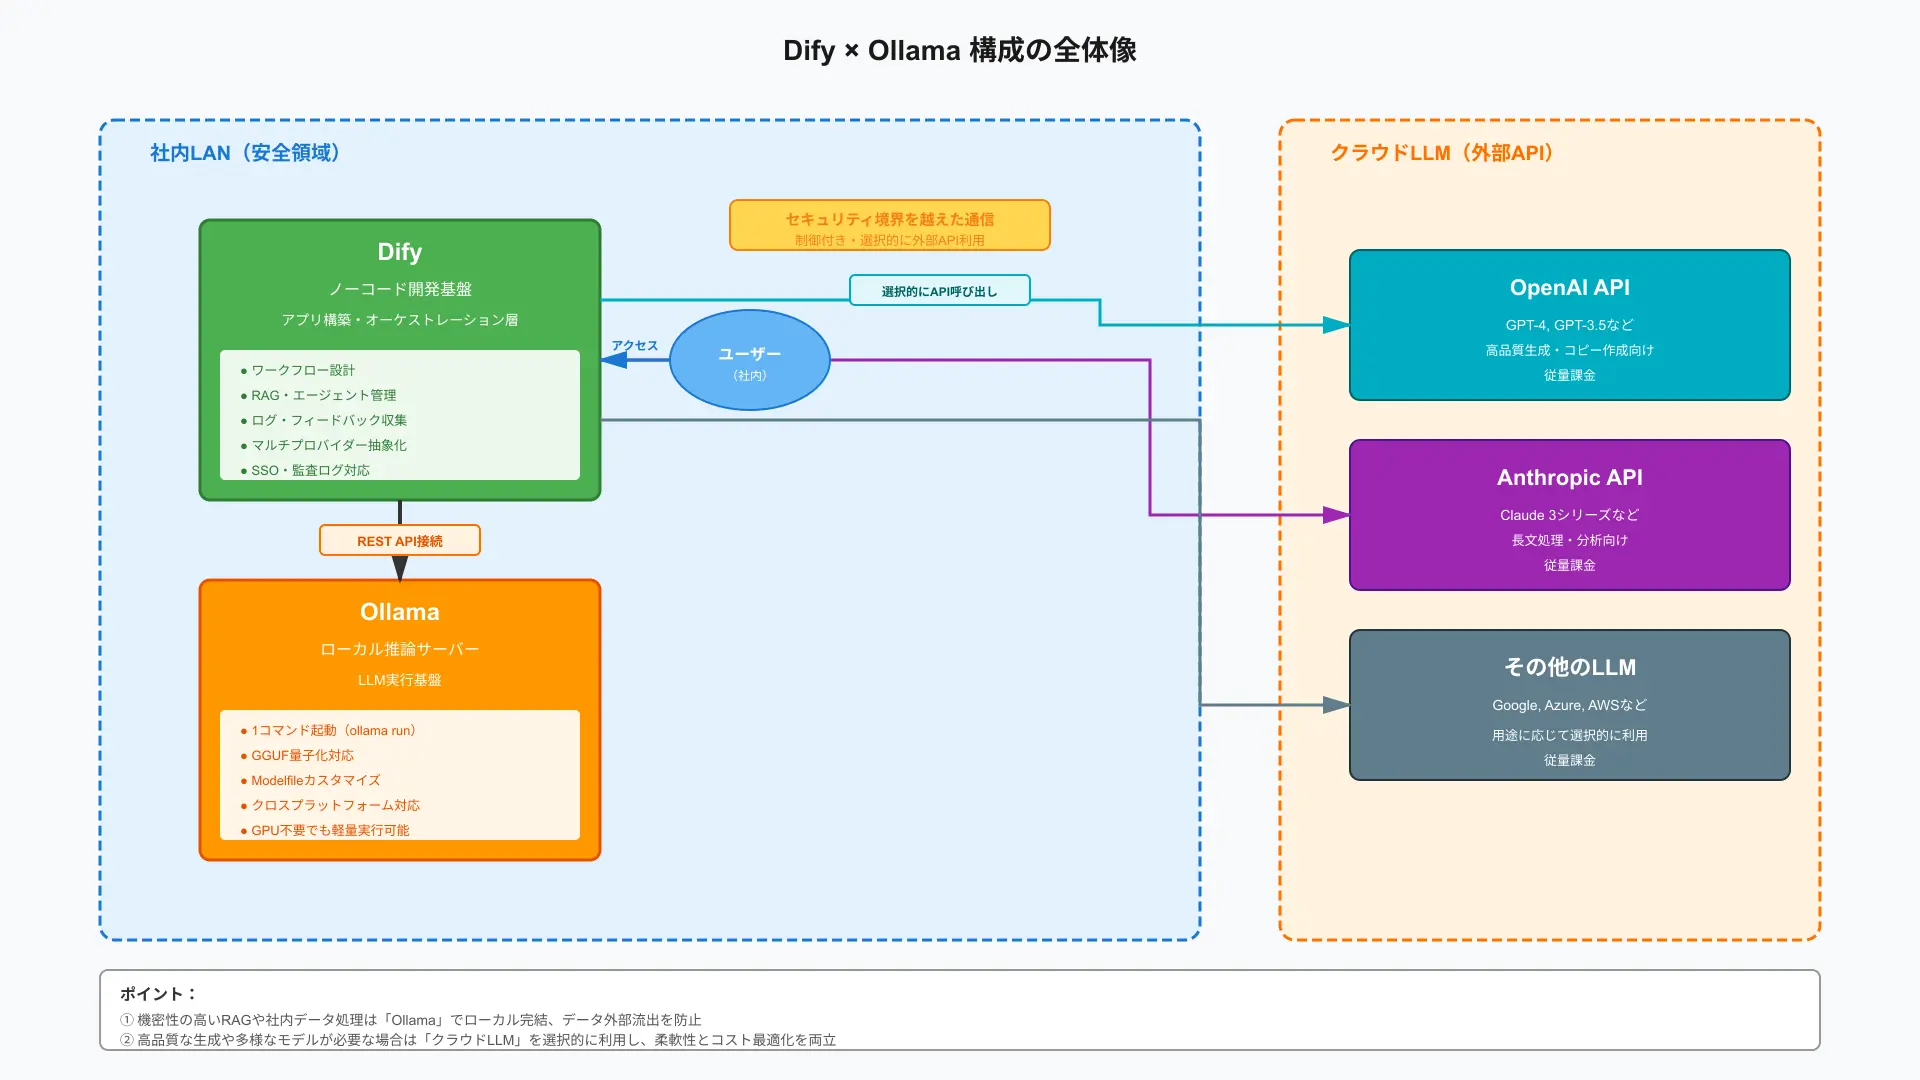
- Ollamaとは?:Mac/Windows/LinuxでLLMを“1コマンド起動”できるローカル基盤
- Dify×Ollama構成の位置づけ:クラウドLLMだけの構成とどう違う?
Difyとは?:LLMアプリ開発の“土台”になるノーコード+LLMOpsプラットフォーム
Difyはプロンプト設計、RAGナレッジ検索、ワークフロー作成、ログ監査を一元管理できるBaaS基盤です。
直感的なWeb画面から誰でもAIアプリを組み立てられ、数クリックでAPIエンドポイントとして公開できます。
バックエンド開発の工数を大幅に削減し、非エンジニアとエンジニアが一体となった迅速なAI活用環境を提供します。
Ollamaとは?:Mac/Windows/LinuxでLLMを“1コマンド起動”できるローカル基盤
Ollamaはllama.cppをベースにした軽量なローカルLLM実行エンジンで、ターミナルから1コマンドでモデルを起動できます。
GPUのVRAM管理や量子化モデルのロードを自動で最適化し、REST API経由でモデルを外部へ公開します。
開発者は複雑なインフラ設定を意識することなく、手元のマシンや自社サーバー上で即座に最先端オープンLLMを動員できます。
Dify×Ollama構成の位置づけ:クラウドLLMだけの構成とどう違う?
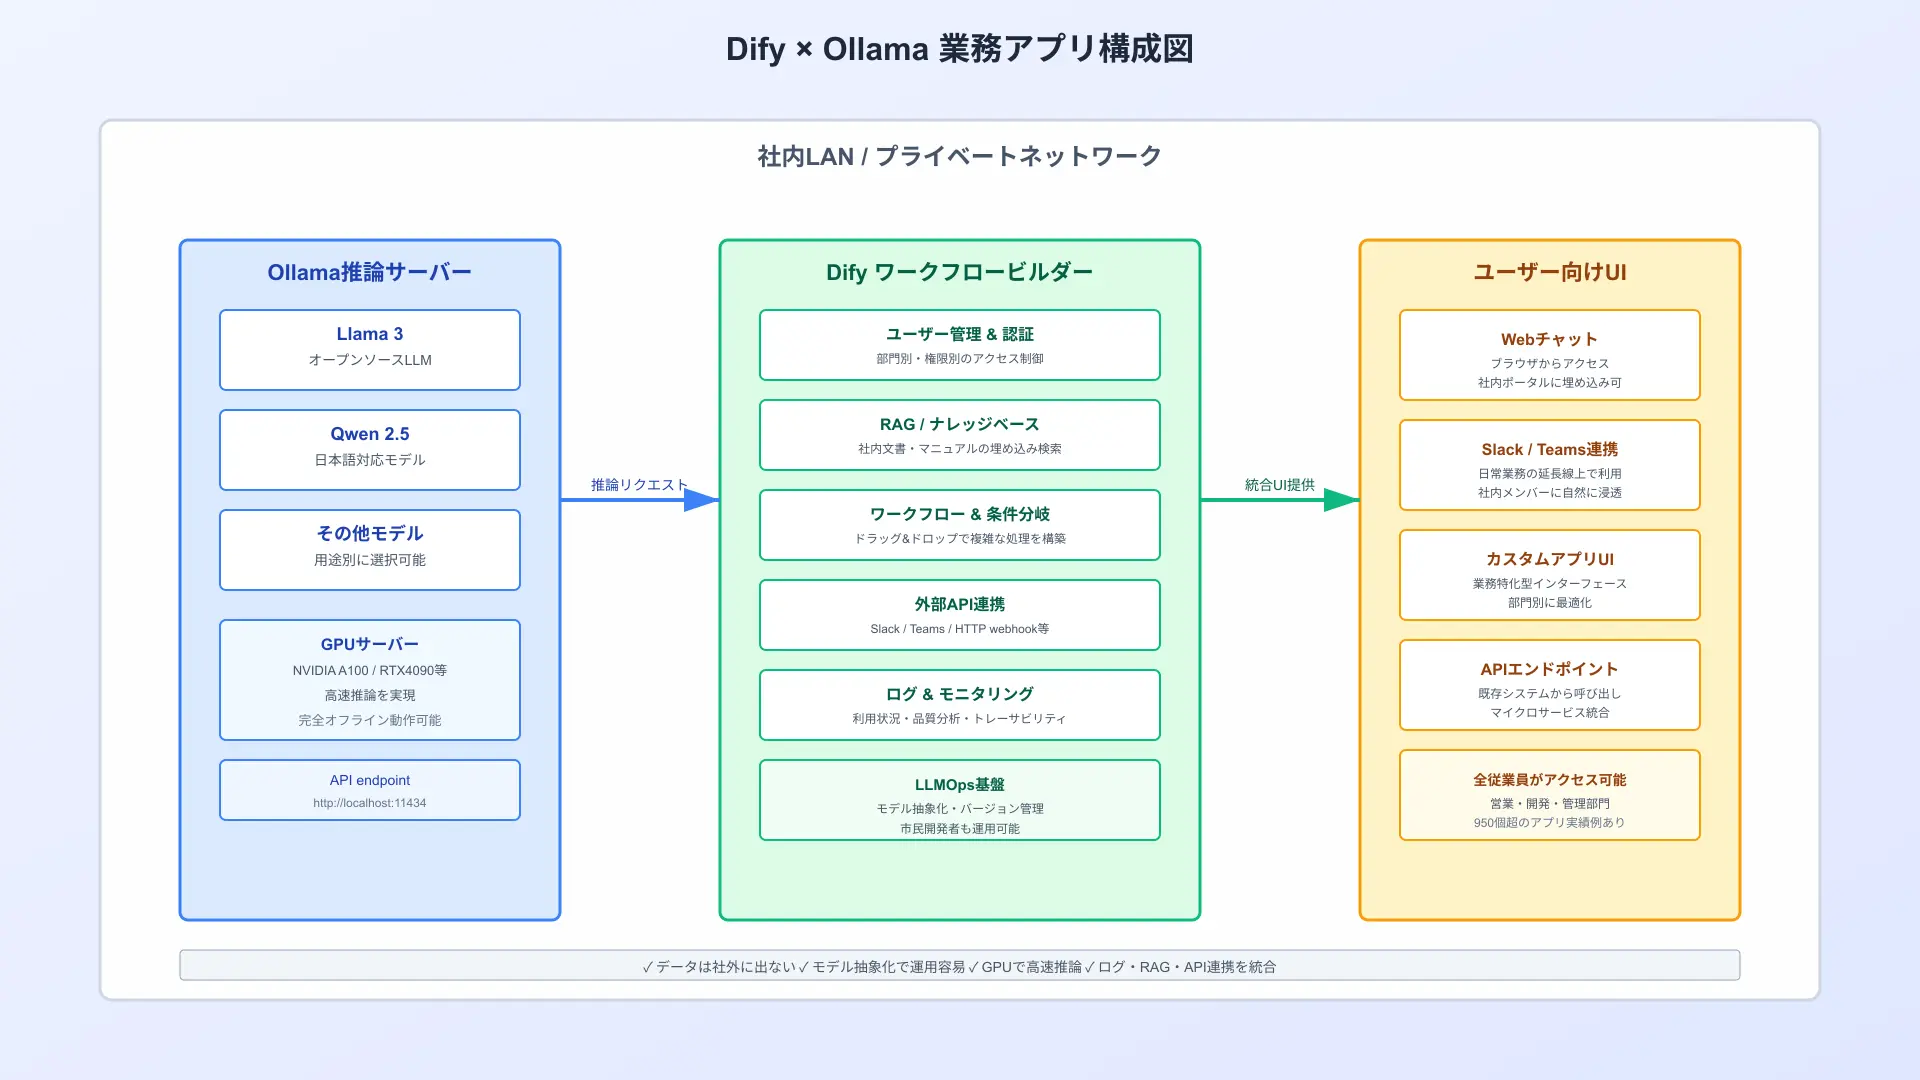
クラウドLLMが従量課金と外部通信を前提とするのに対し、Dify×Ollamaはすべての処理をローカル完結させます。
機密データが社外に出るリスクを物理的に遮断しながら、Difyの高度なRAG機能やワークフローをそのまま享受できます。
セキュリティと利便性を両立させた、最も安全で費用対効果の高いオンプレミスAIアーキテクチャを確立できます。
Dify×Ollamaをつなぐと何が嬉しいのか?メリットと注意点
当セクションでは、DifyとOllamaを組み合わせる実務上のメリットと導入時の注意点を解説します。
利点と制約の両面を把握しておくことで、適切なプロジェクト判断が下せるようになるからです。
- ローカルLLMを“ちゃんとした業務アプリ”に昇格させられる
- データを外に出さずに使える安心感:機密情報・社外秘ドキュメントとの相性
- コスト構造:API課金の変動費 vs ローカルGPUの固定費
- デメリット・注意点:セットアップと運用は“ゼロ知識で勝手に動く”わけではない
ローカルLLMを“ちゃんとした業務アプリ”に昇格させられる
ターミナル上の対話にとどまっていたローカルLLMに、洗練されたWebチャットUIとRAG検索を付与できます。
社内ドキュメントのアップロードやプロンプトテンプレートの共有がGUI上で完結します。
専門知識のない一般社員でも日常業務で迷わず活用できる、本格的なエンタープライズ社内AIアプリへと昇華させられます。
データを外に出さずに使える安心感:機密情報・社外秘ドキュメントとの相性
金融機関や医療機関、製造業の研究開発部門など、外部クラウドが一切禁止されている現場でも安全に導入できます。
プロンプトや社内文書がインターネット上へ流出するリスクが原理的にゼロになります。
企業の厳格な情報管理規定をクリアし、コンプライアンスを完全に遵守した社内DXを力強く加速させられます。
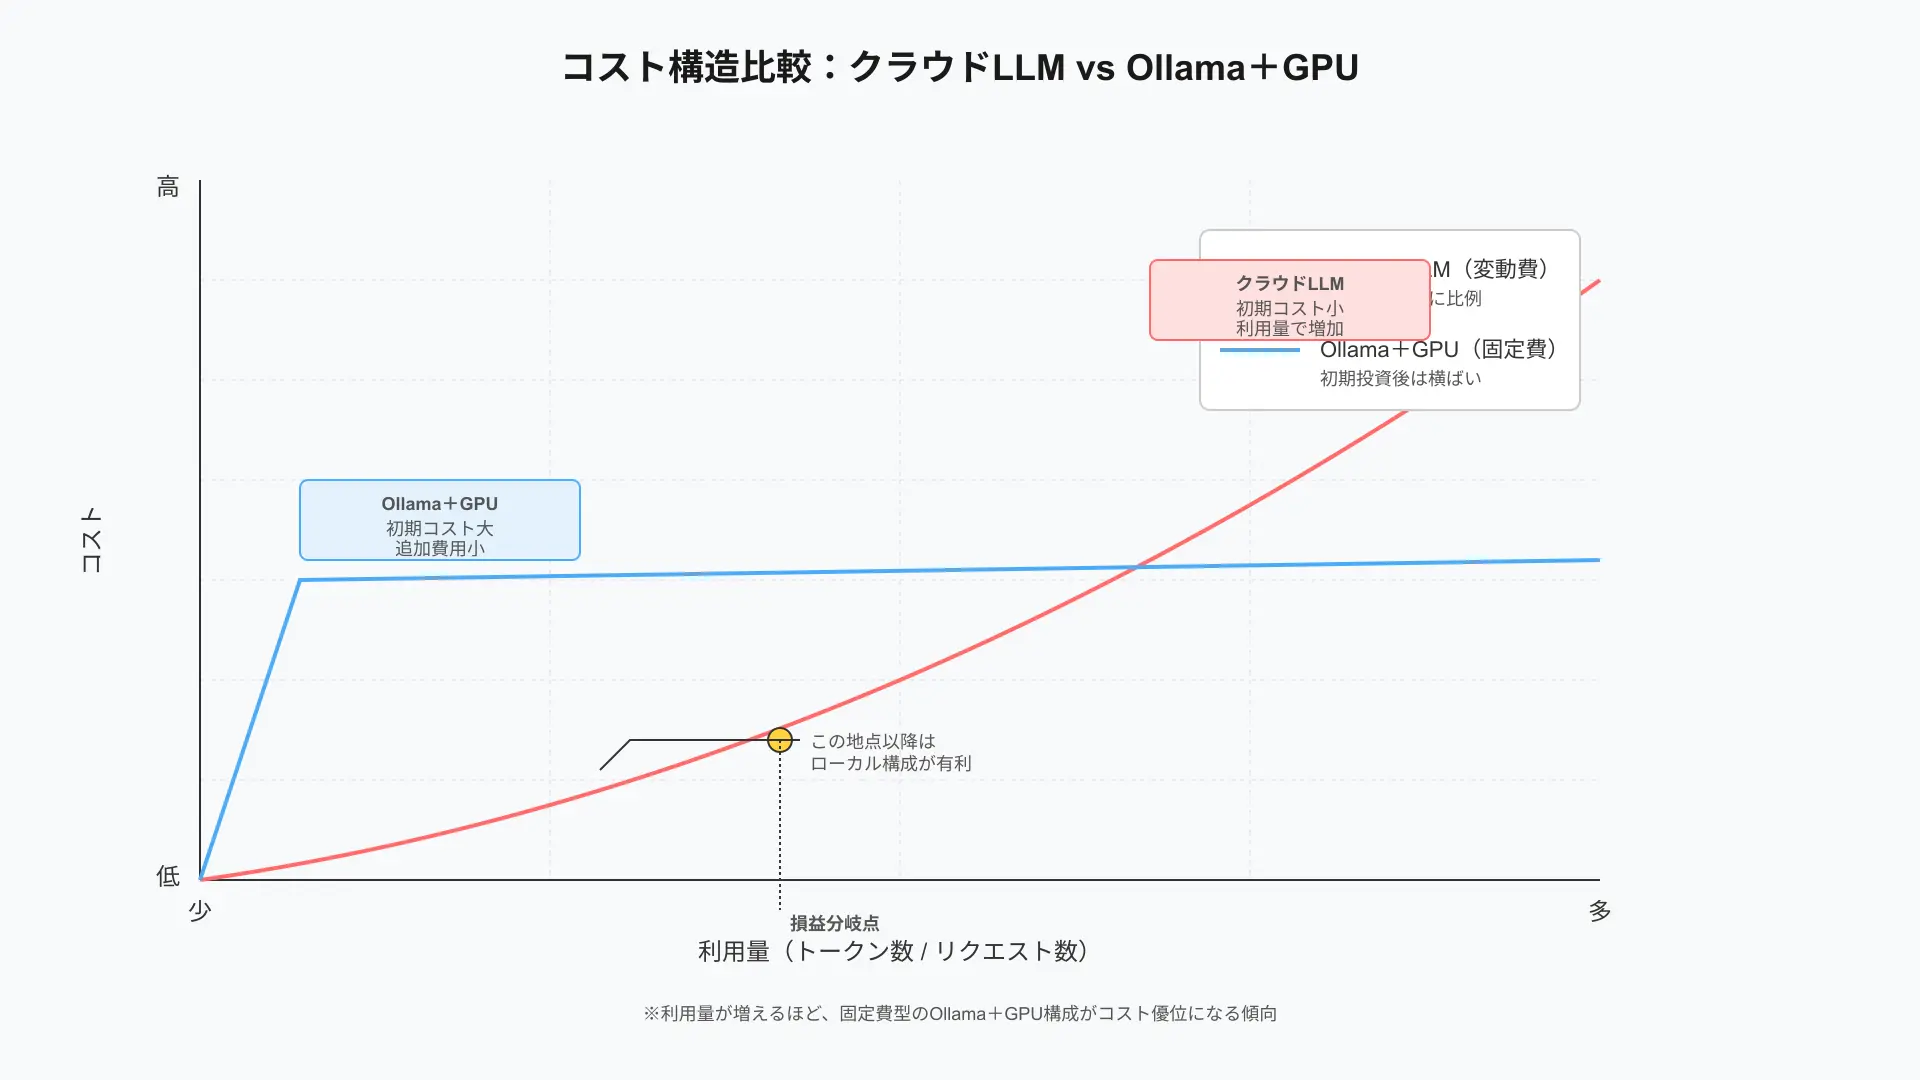
コスト構造:API課金の変動費 vs ローカルGPUの固定費
クラウドAPIは利用頻度に応じて毎月の請求額が変動しますが、ローカル環境はハードウェア代と電気代のみの固定費です。
社員数百人が毎日大量のテキスト要約や検索クエリを投げても、追加費用が一切発生しません。
大量の定型業務バッチ処理を実行するほど、クラウドAPI対比で劇的なコスト削減効果を発揮します。
デメリット・注意点:セットアップと運用は“ゼロ知識で勝手に動く”わけではない
Dockerのネットワーク設定やVRAM容量の管理など、一定のインフラ知識が求められます。
また、パラメータ数の小さな軽量モデルでは、超巨大なフロンティアモデルと比べて推論精度に限界があります。
実務で求められるタスクの難易度を見極め、適切なモデルサイズとハードウェア構成を事前に選定することが不可欠です。
【環境別】Dify×Ollamaは自分のPCで現実的に動かせる?スペックとモデル選定の目安
当セクションでは、マシンスペック別の動作可能なモデルサイズと推奨ハードウェア構成を解説します。
手持ちのマシンで快適に動作する最適な組み合わせを判断できるようになるからです。
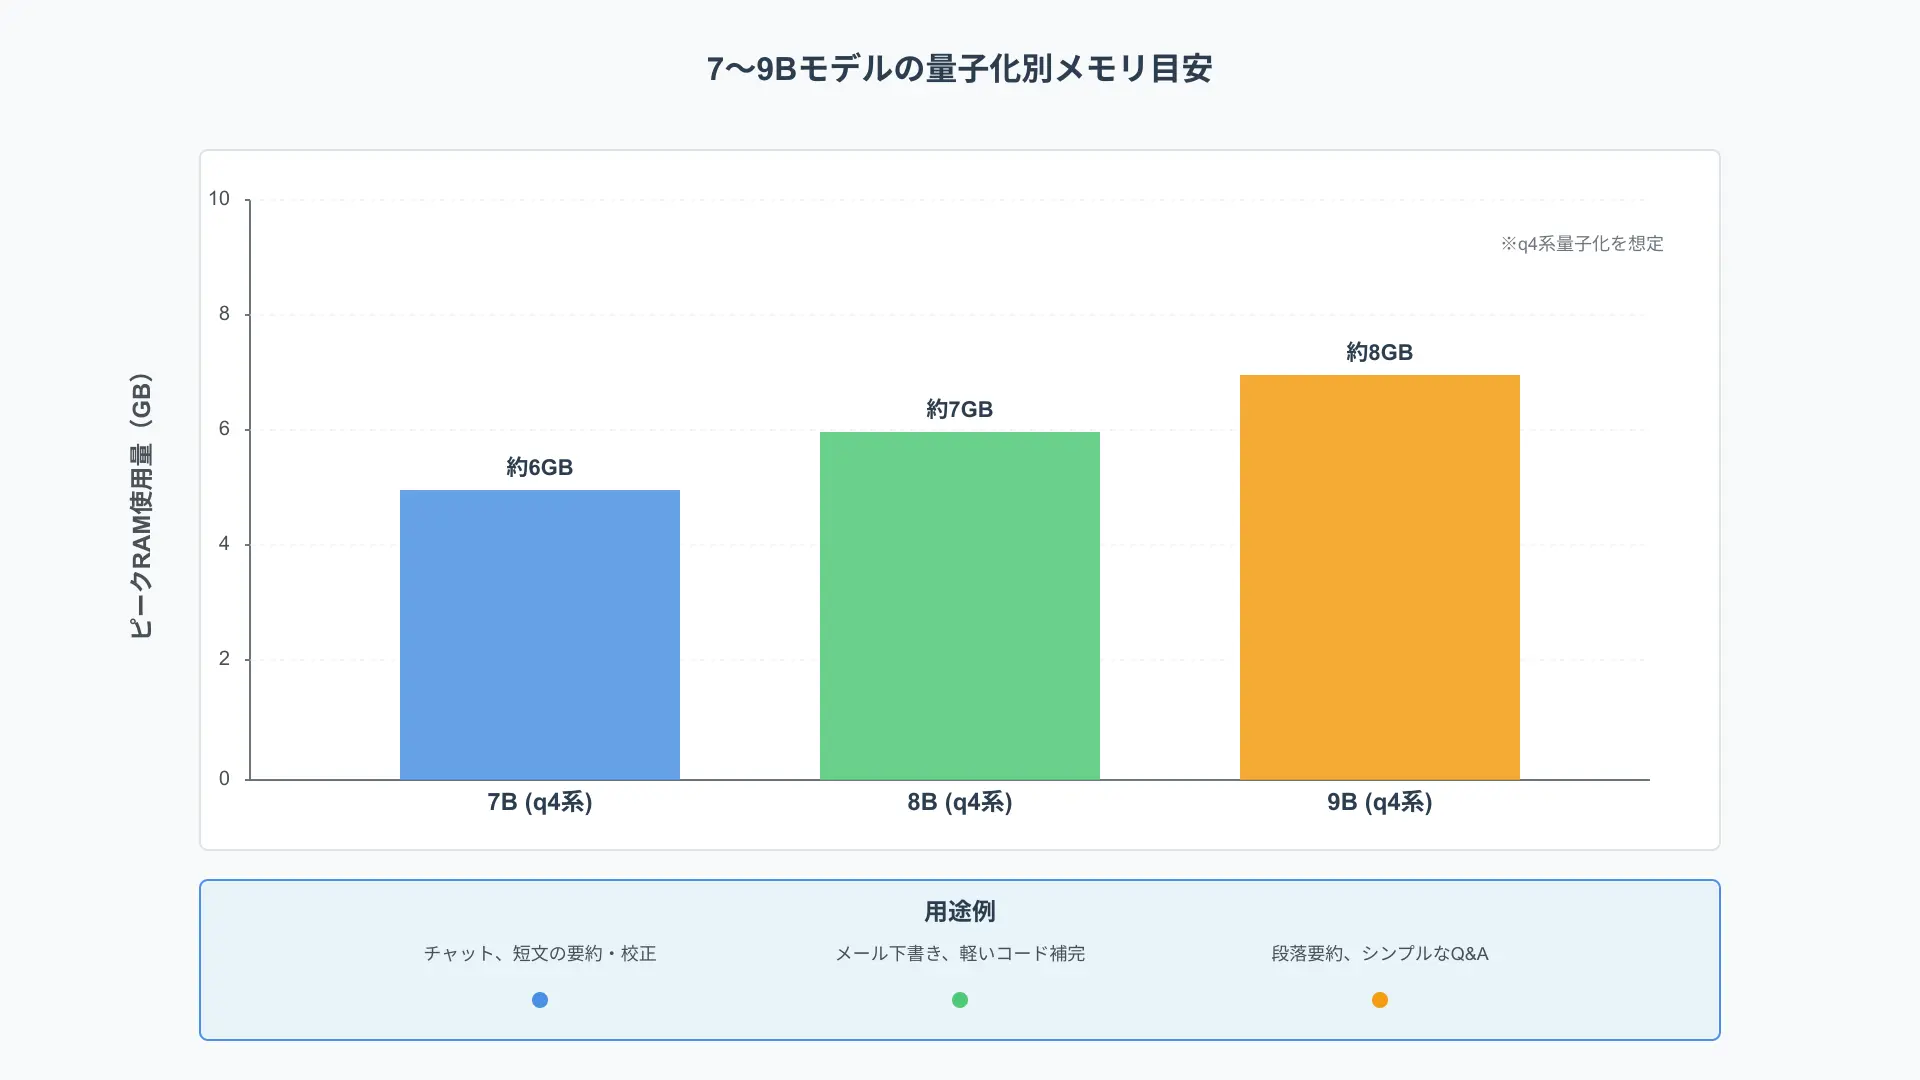
- GPUなしノートPC(RAM16GB前後)の場合:軽量7〜9Bモデルで“試す・学ぶ”用途に
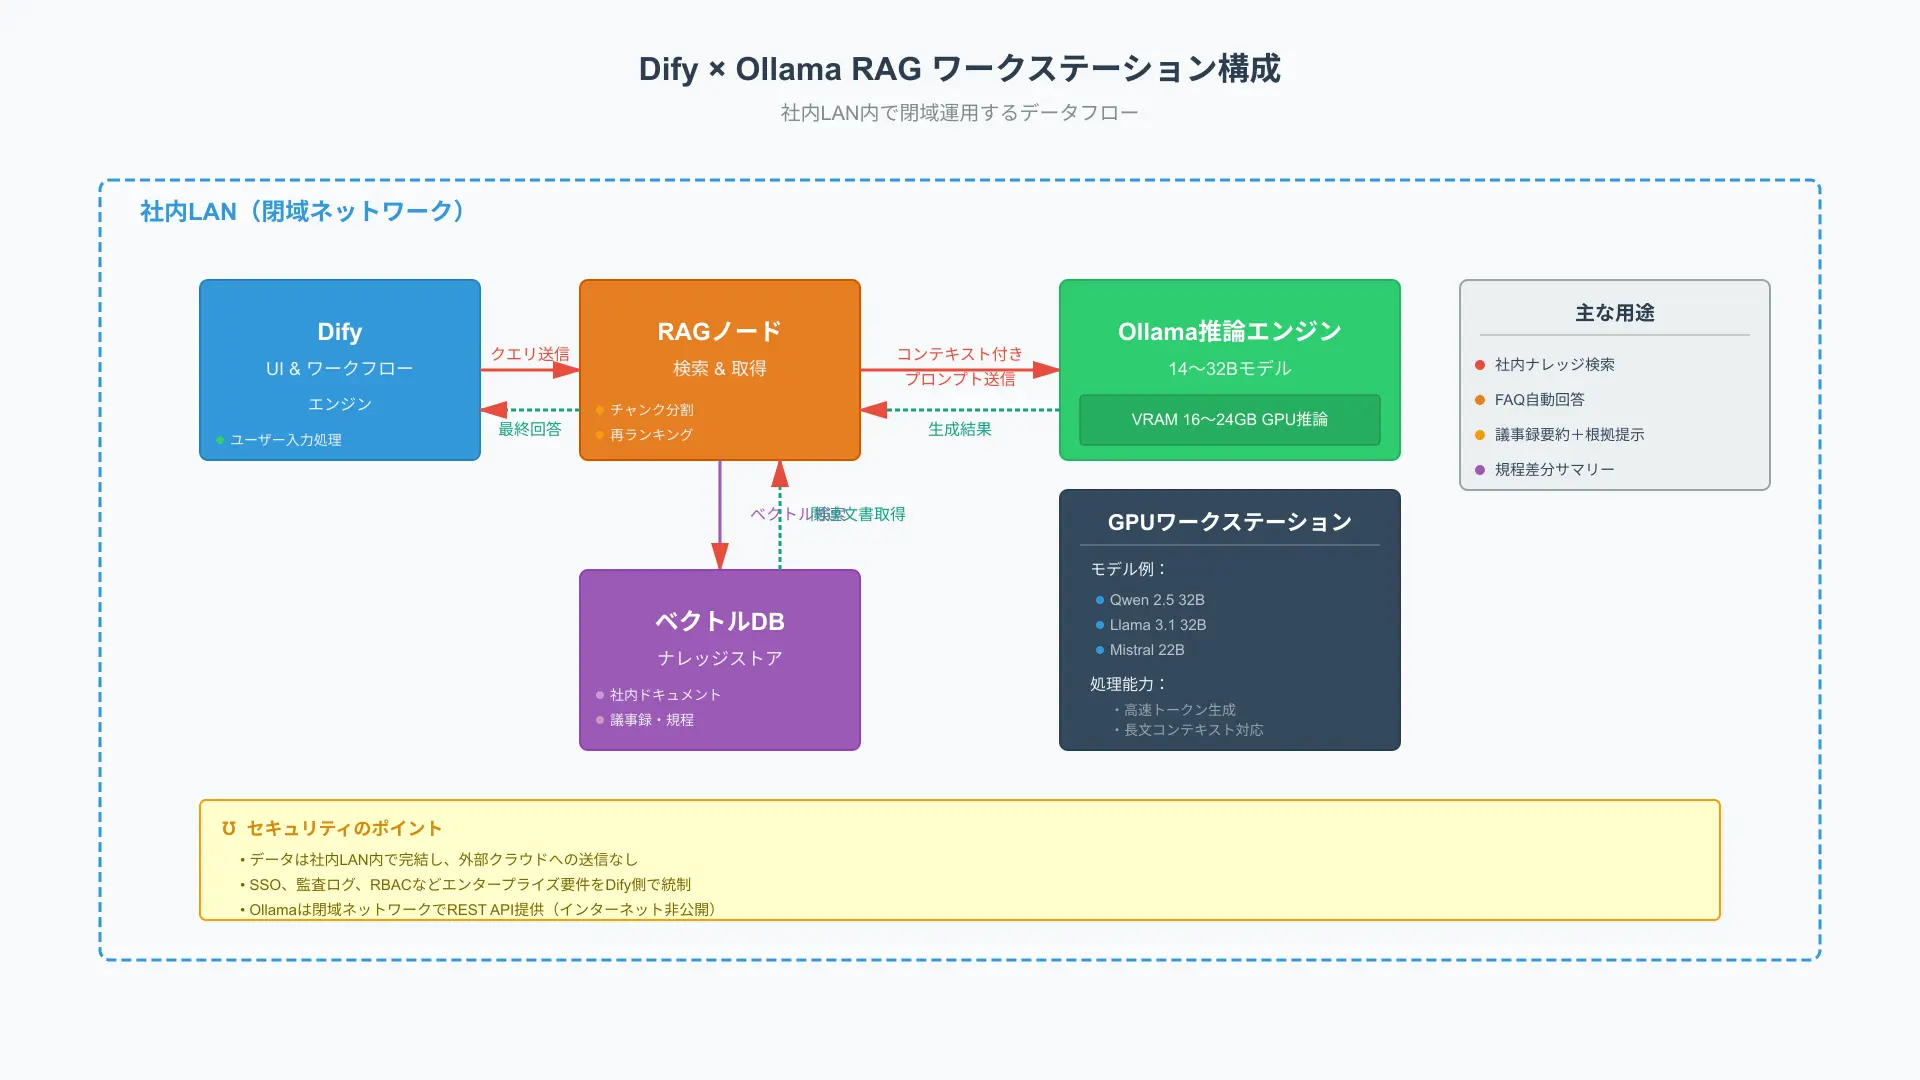
- GPU付きワークステーション(例:VRAM 16〜24GB)の場合:RAG付き社内検索も視野に
- オンプレ推論サーバー(A100/H100など)の場合:クラウド級の全社AI基盤も構築可能
GPUなしノートPC(RAM16GB前後)の場合:軽量7〜9Bモデルで“試す・学ぶ”用途に
CPU推論(またはApple Siliconのユニファイドメモリ)を活用し、Llama 3.2 (3B) や Qwen 2.5 (7B) などの軽量モデルを動かします。
レスポンス速度は毎秒数トークン程度ですが、動作検証やPoCの第一歩として十分に役立ちます。
高額な専用ハードウェアを購入することなく、手元の一般的なビジネスPCで即座にローカルAIの検証をスタートできます。
GPU付きワークステーション(例:VRAM 16〜24GB)の場合:RAG付き社内検索も視野に
RTX 4090やM3/M4 Max Mac(36GB〜64GB)環境では、Qwen 2.5 (14B/32B) や DeepSeek-R1蒸留モデルが高速に動作します。
毎秒30〜50トークンの滑らかな生成速度で、社内PDFを参照した高精度なRAG回答が得られます。
部門内のチームメンバー数十人で共有してもストレスのない、実用的なローカルAI業務サーバーを構築できます。
オンプレ推論サーバー(A100/H100など)の場合:クラウド級の全社AI基盤も構築可能
データセンター内の専用GPUサーバーを用いれば、70Bクラスの巨大オープンモデルを複数同時に稼働させられます。
社内数百〜数千人からの並行リクエストを高速に捌き、複雑な推論タスクや長文解析も難なくこなします。
クラウドと同等以上の知能水準を保ちながら、完全なデータ主権を社内に掌握する究極のエンタープライズ基盤が完成します。
ステップバイステップ:OllamaのインストールとDifyからの接続設定
当セクションでは、OllamaのセットアップからDifyへのモデル登録までの接続手順を解説します。
設定の落とし穴を回避し、最短ルートで疎通確認を完了できるようになるからです。
- ステップ0:構成方針の決定(同一マシンか、別サーバーか)
- ステップ1:Ollamaのインストールとモデル取得(Mac/Windows/Linux)
- ステップ2:OllamaをDifyからアクセス可能にする(host.docker.internal / OLLAMA_HOST設定)
- ステップ3:Dify側でOllamaモデルを登録する
- ステップ4:疎通確認とよくあるエラーの対処法
ステップ0:構成方針の決定(同一マシンか、別サーバーか)
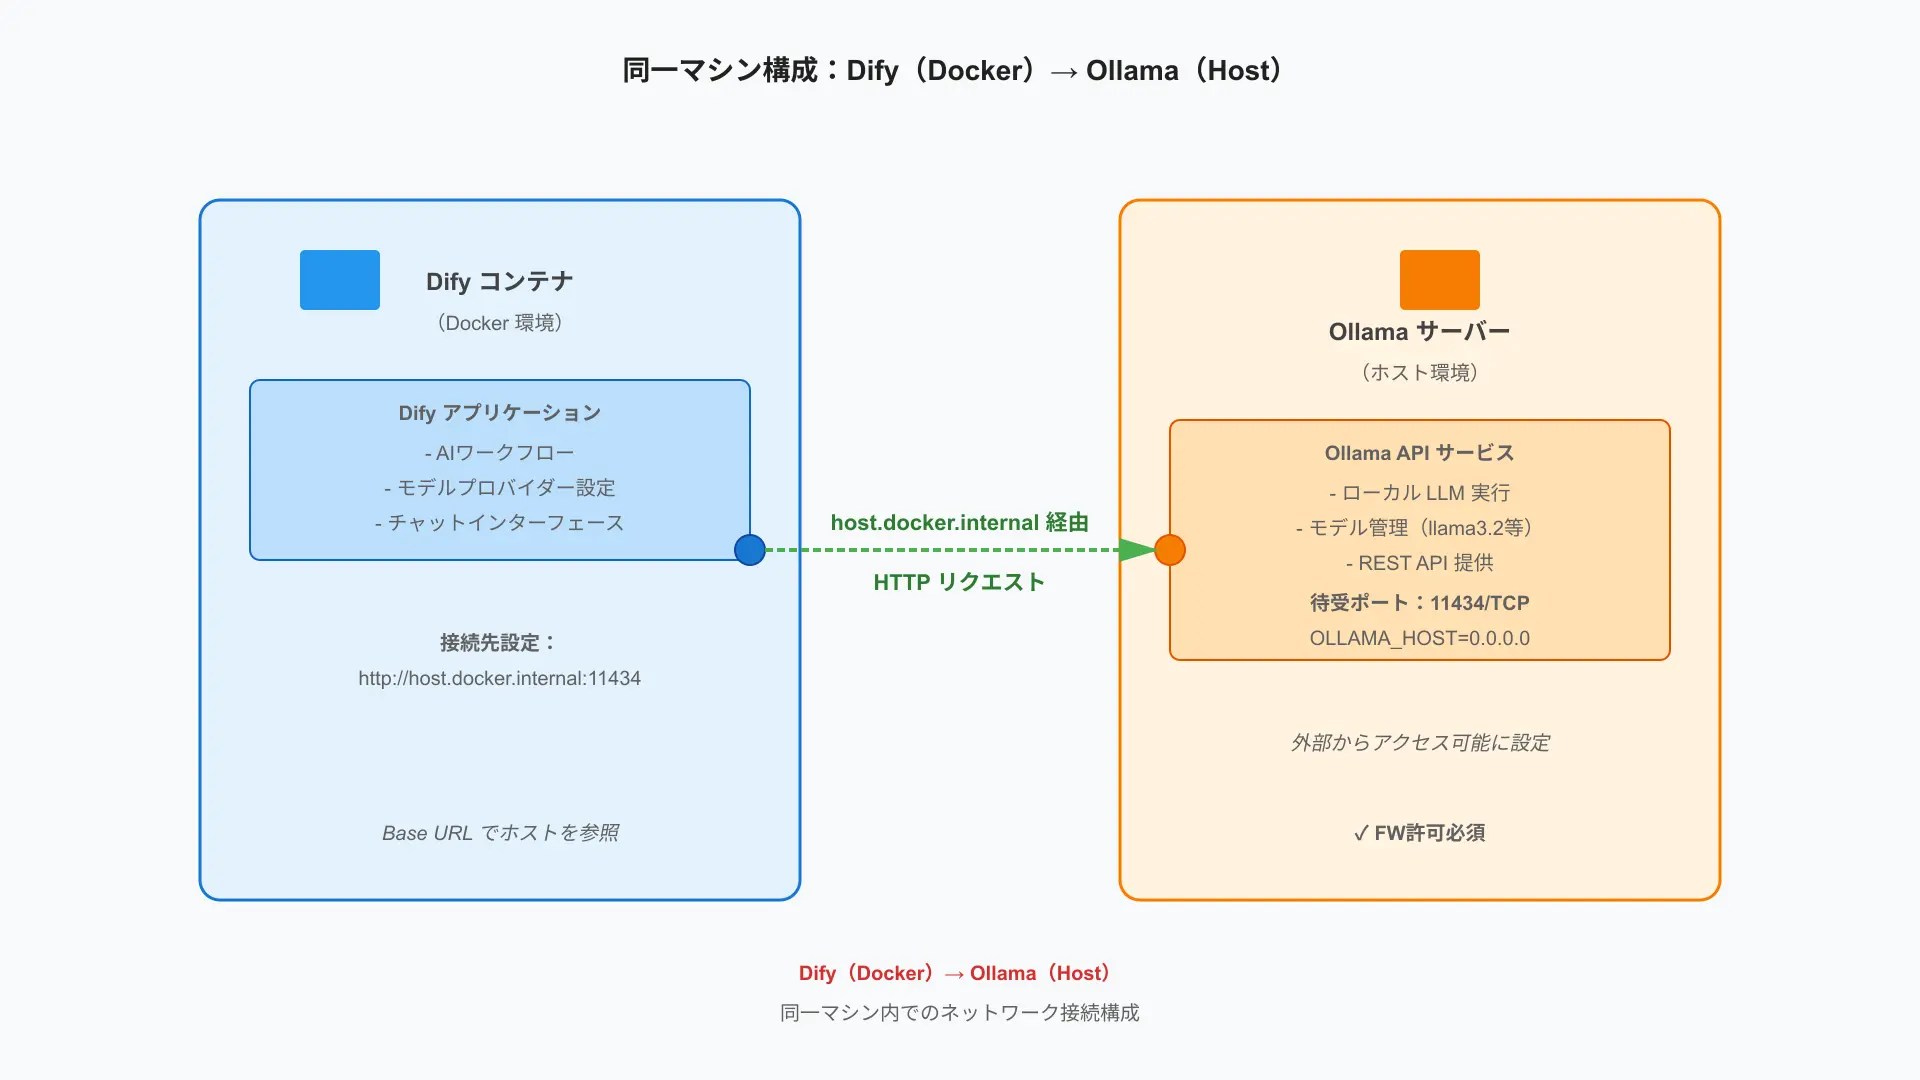
Dify(Docker)とOllamaを同じPC内で動かすか、別々のGPUサーバーに分けて動かすかを決定します。
同一マシンの場合はDockerネットワーク経由でのホスト間通信設定が必要となります。
自社のハードウェアリソースに合わせて、無理のない通信構成とネットワーク経路を事前に設計します。
ステップ1:Ollamaのインストールとモデル取得(Mac/Windows/Linux)
公式サイトからインストーラーをダウンロードし、起動後にターミナルからモデルをダウンロードします。
「ollama pull qwen2.5」や「ollama pull deepseek-r1」を実行するだけでモデルの取得が完了します。
必要なモデルがローカルにキャッシュされ、即座にREST API経由での推論待受状態に入ります。
ステップ2:OllamaをDifyからアクセス可能にする(host.docker.internal / OLLAMA_HOST設定)
Linux環境では、Difyのdocker-compose.yml内のapi・workerサービスに「extra_hosts: [“host.docker.internal:host-gateway”]」を追記します。
また、Ollama側の環境変数に「OLLAMA_HOST=0.0.0.0:11434」と「OLLAMA_ORIGINS=”*”」を設定して全通信を許可します。
コンテナ内部からホストマシンのOllamaへ向かう通信経路を開通させ、接続拒否エラーを確実に解消できます。
ステップ3:Dify側でOllamaモデルを登録する
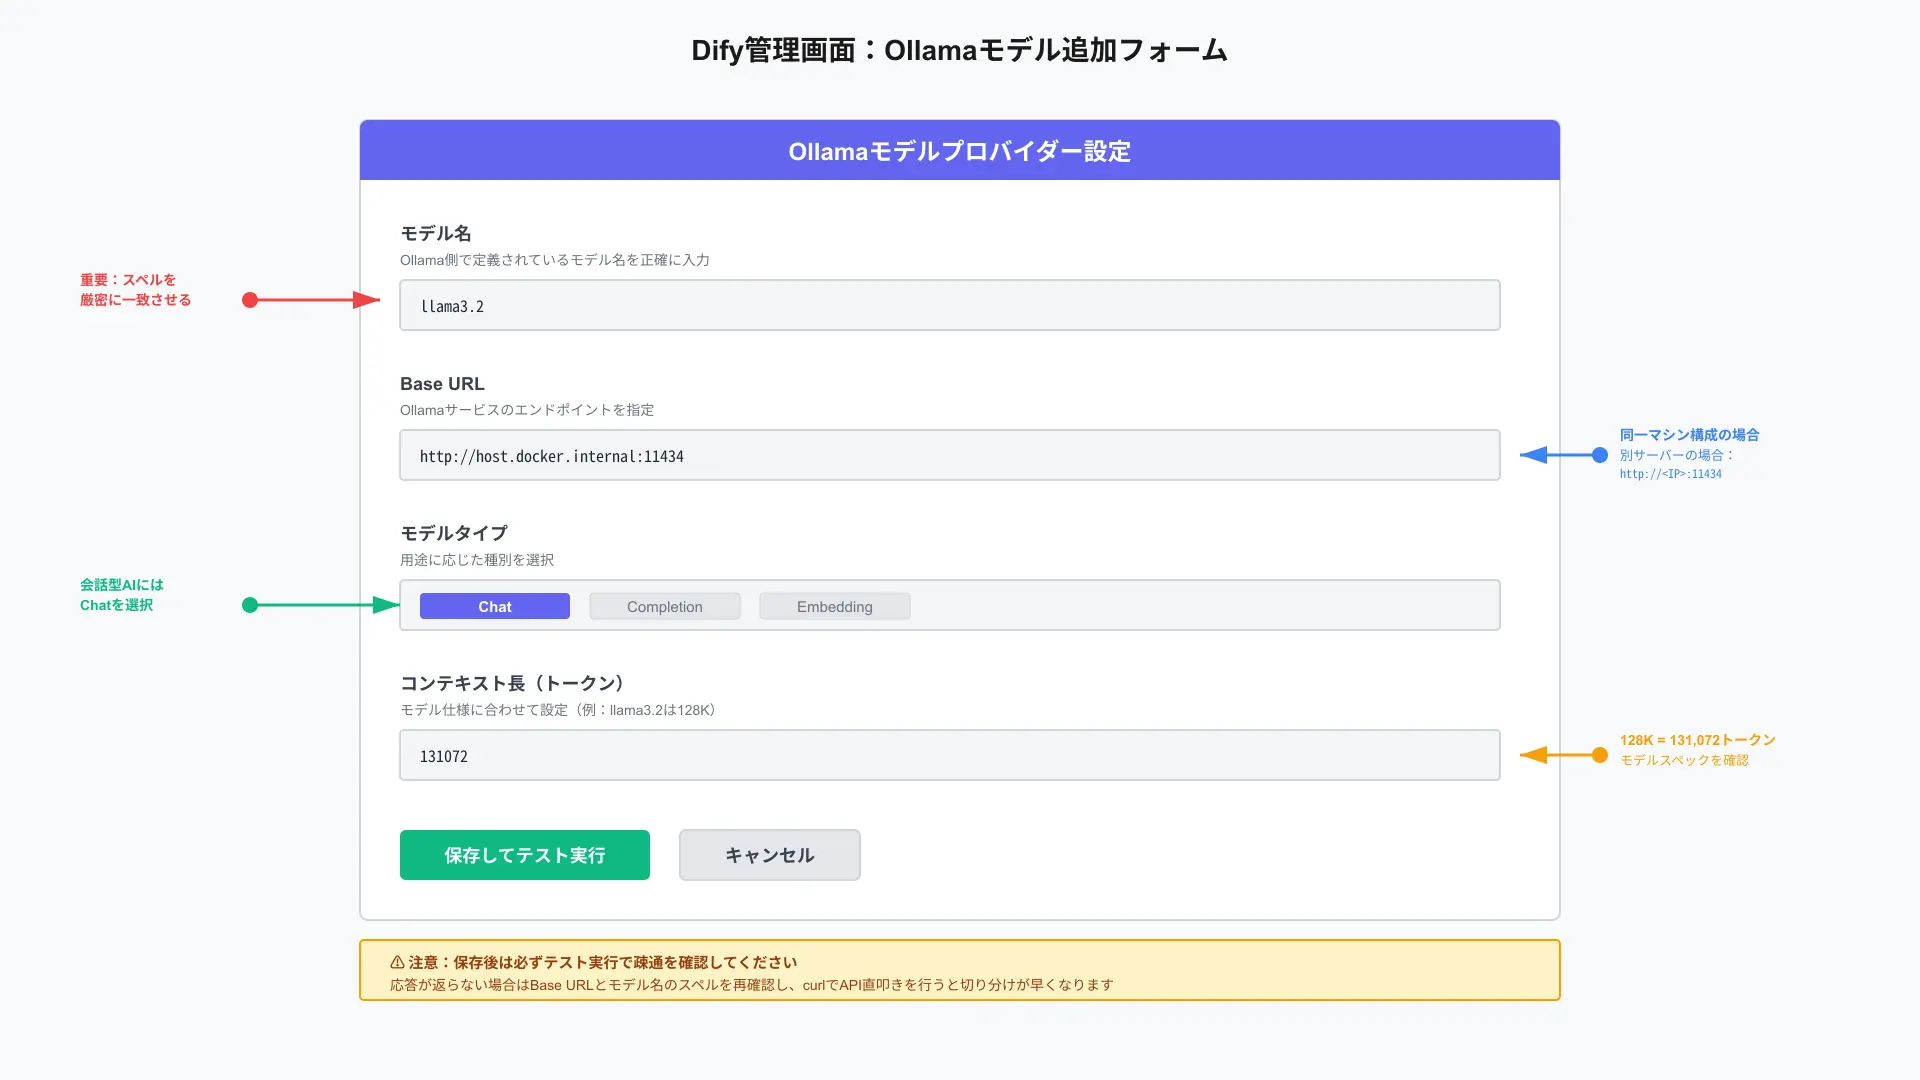
Dify管理画面の「設定」→「モデルプロバイダー」から「Ollama」のカードを選択します。
モデル名にpullした名称(例: qwen2.5)、Base URLに「http://host.docker.internal:11434」を入力します。
保存ボタンをクリックするだけで、Dify内の全アプリからローカルモデルが自由に選択可能になります。
ステップ4:疎通確認とよくあるエラーの対処法
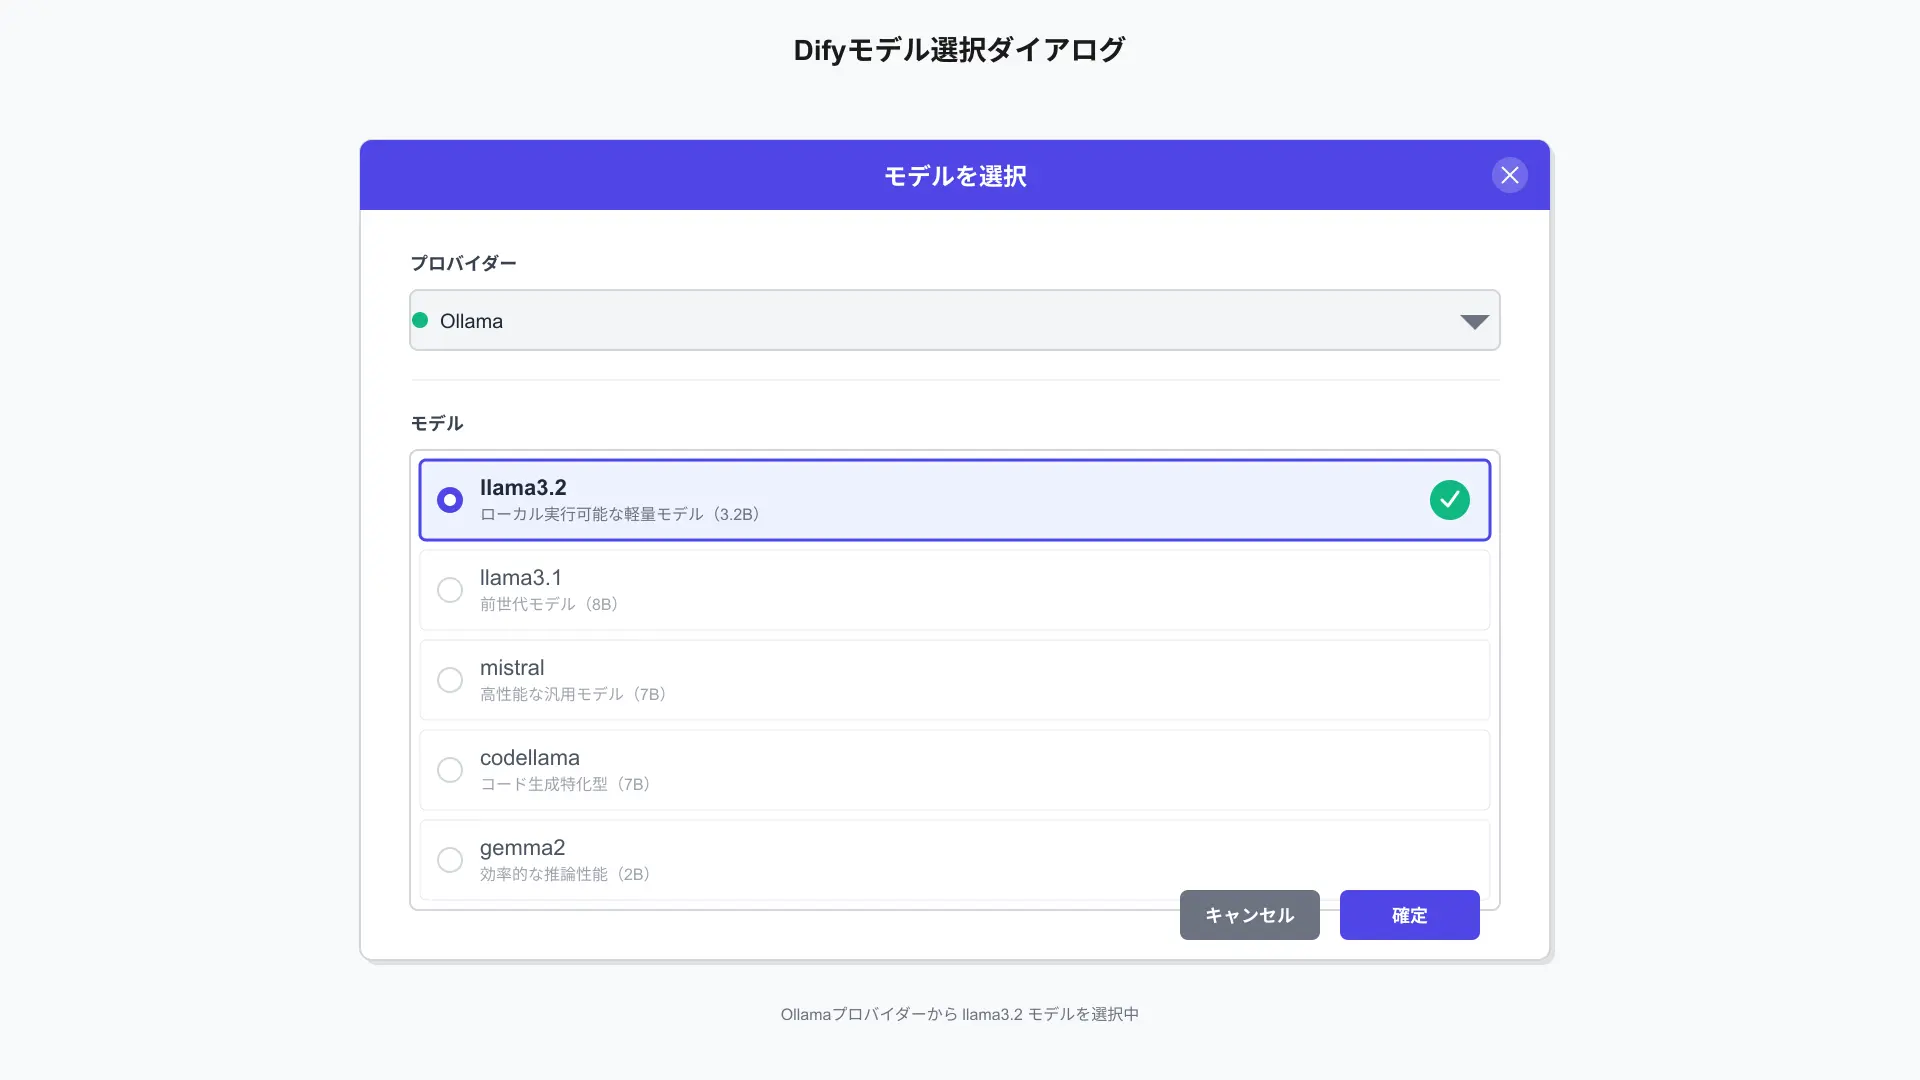
設定画面で接続テストを行い、グリーンのチェックマークが表示されることを確認します。
エラーが出る場合は、ファイアウォール設定やOllamaプロセスの起動状態、URLの打ち間違いをチェックします。
適切なトラブルシューティングを行うことで、安定したローカル推論パイプラインを確実に構築できます。
最初の一歩:Dify×Ollamaでローカル問合せチャットアプリを作る
当セクションでは、接続したOllamaを用いて実際にDify上でAIアプリを作成する手順を解説します。
テンプレートから数分で実用的なチャットアプリやRAGを立ち上げられるようになるからです。
シンプルなチャットアプリを作成(テンプレから5分で試す)
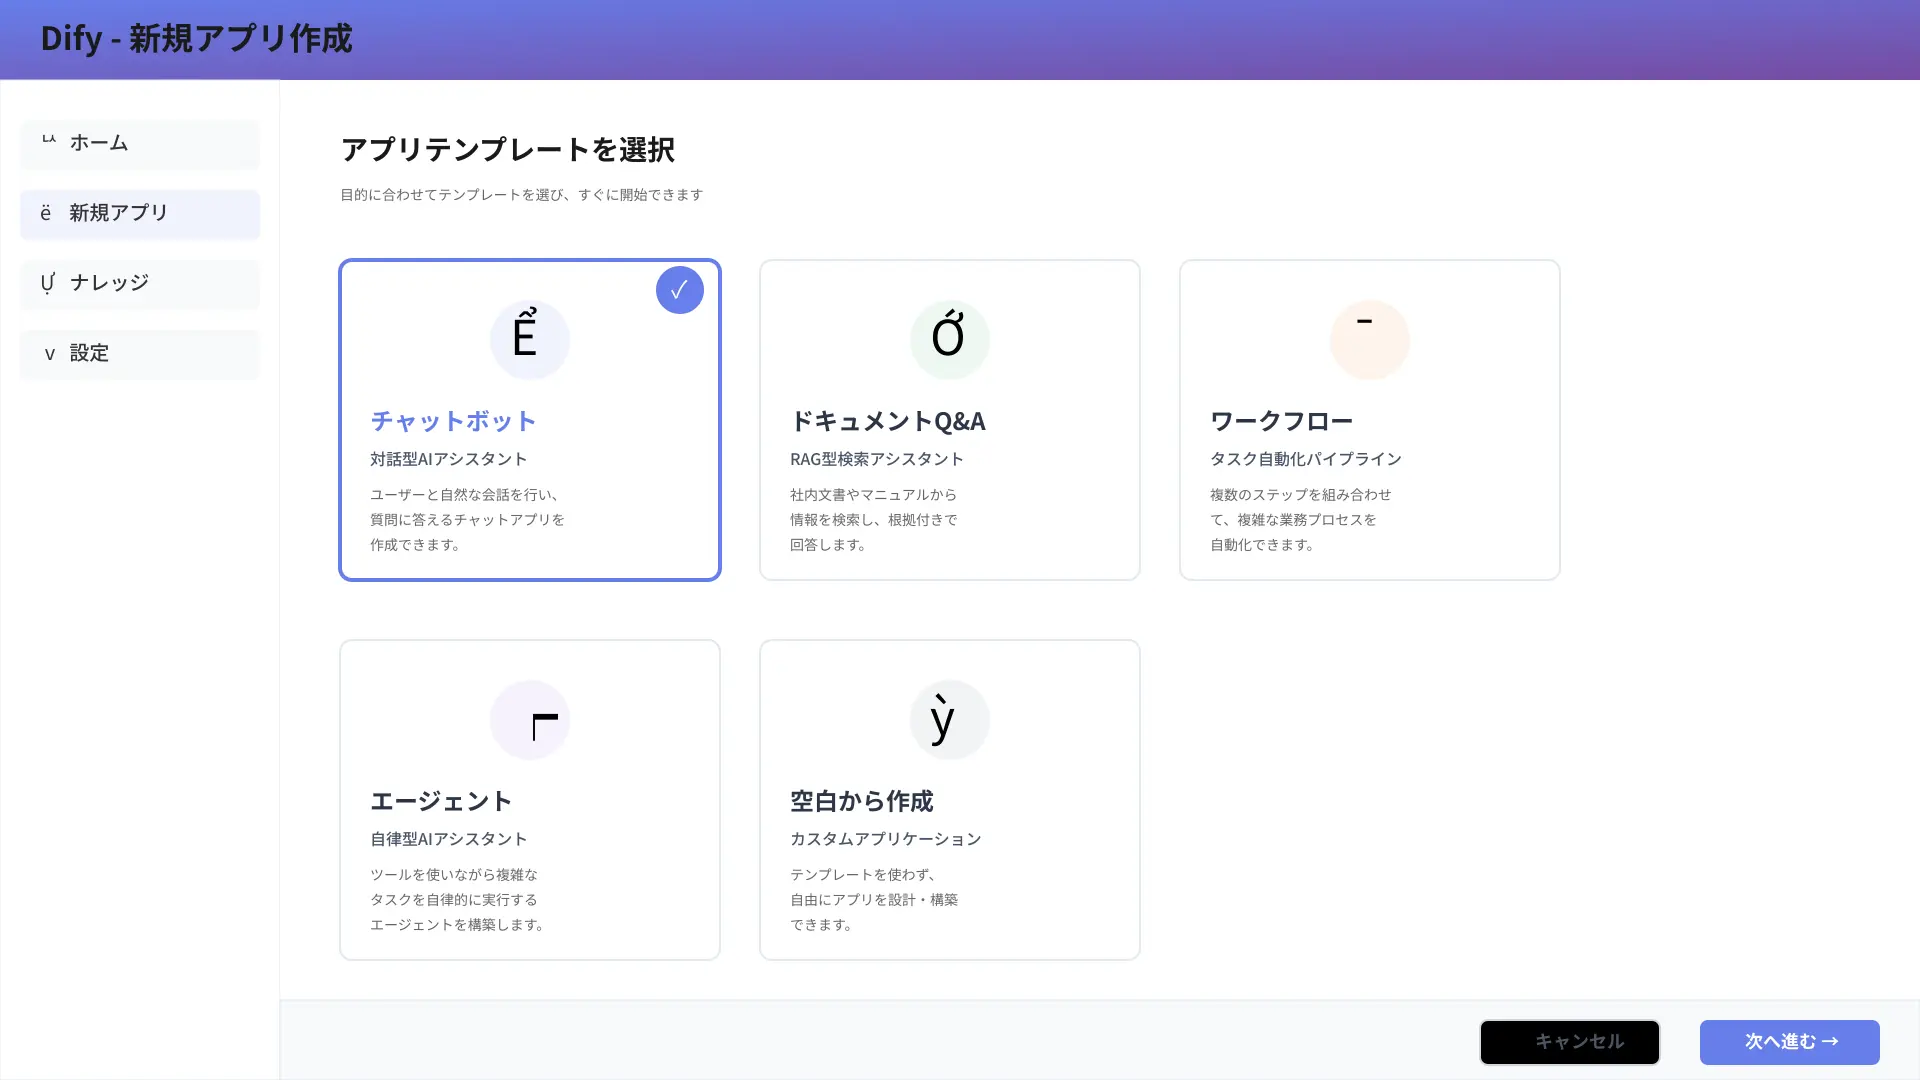
「アプリを作成」からチャットボットテンプレートを選択し、モデルに登録したOllamaモデルを指定します。
システムプロンプトに「あなたは優秀な社内アシスタントです」などの役割を記述して公開します。
わずか数分の操作で、社内向けに即座に公開・共有できるローカルAIチャットが完成します。
RAG(社内PDFやマニュアル)を使ったドキュメントQAのミニ構成
「ナレッジ」メニューから社内のPDFやテキストファイルをアップロードし、データセットを作成します。
EmbeddingモデルにもOllamaの「nomic-embed-text」を指定することで、ベクター検索も完全ローカル化できます。
社外秘の業務マニュアルに基づき、正確な根拠ドキュメントを引用しながら回答するセキュアなQAシステムが手に入ります。
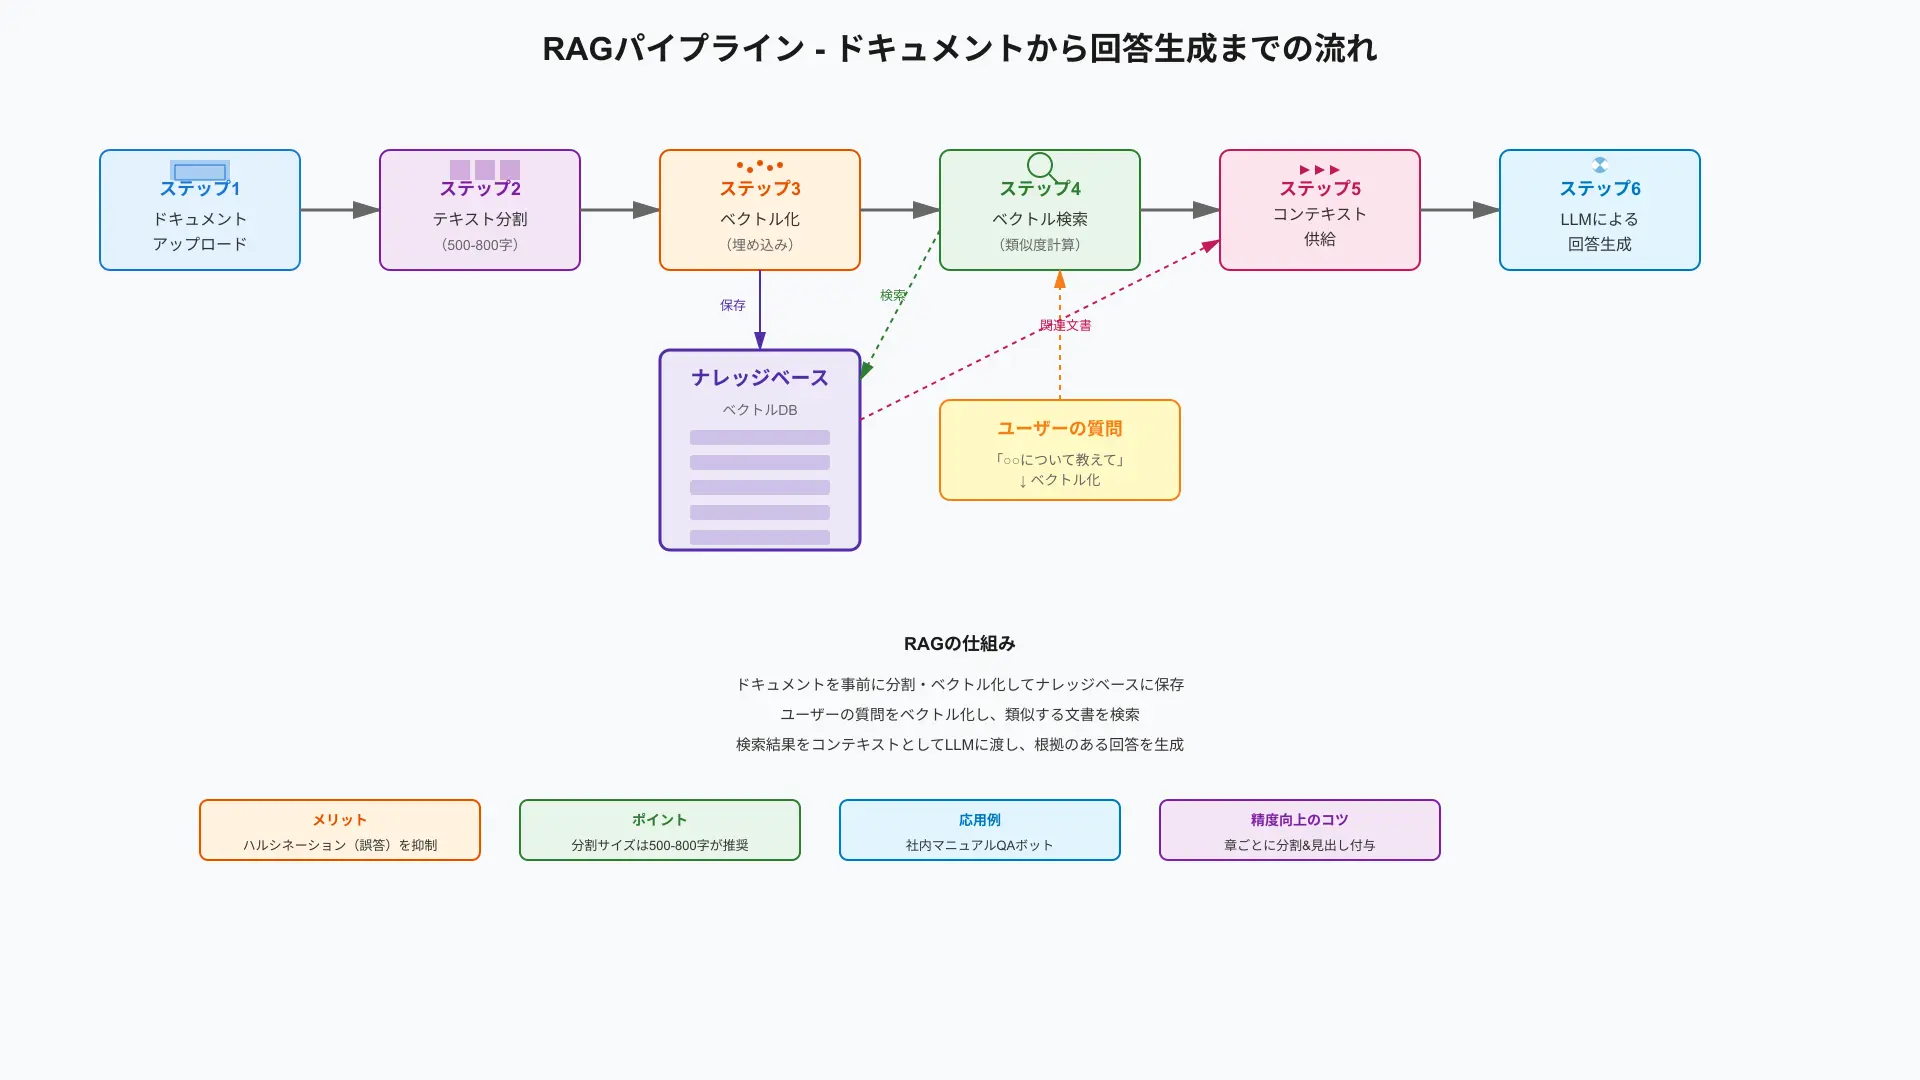
簡単なワークフロー/ツール連携の例
ワークフローキャンバス上で、HTTPリクエストノードやPythonコードノードをローカルLLMと接続します。
社内データベースからのデータ取得と、ローカルLLMによる要約処理を自動で連動させます。
複雑なバックオフィス業務を完全に自動化し、人的工数を劇的に削減する業務フローを視覚的に構築できます。
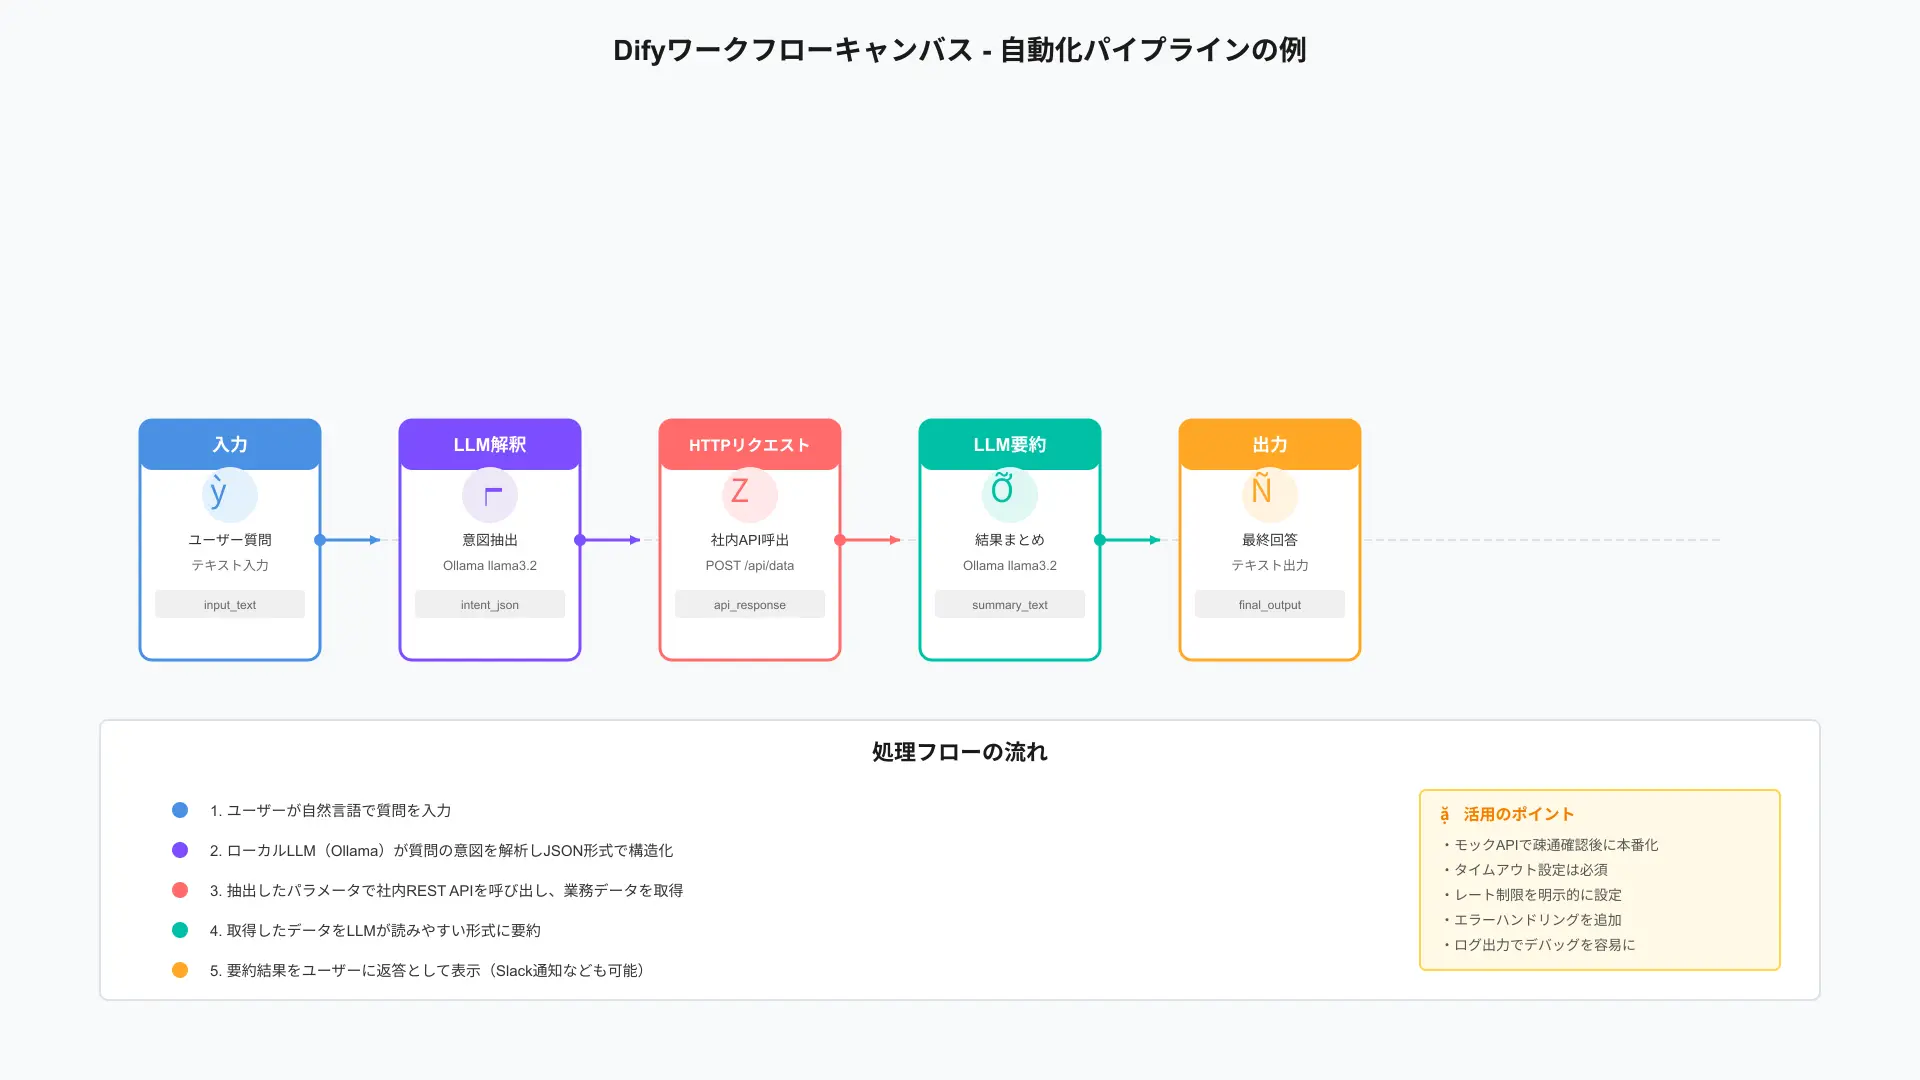
Dify×Ollamaはどんなユースケースで“刺さる”のか?
当セクションでは、ローカルLLM構成が絶大な効果を発揮する代表的なユースケースを解説します。
自社の業務課題に対する具体的な適用イメージを掴めるようになるからです。
- 社内チャットボット/ナレッジ検索:機密情報を含む問い合わせ対応に
- クライアント別の“プライベートAIアシスタント”(制作会社・コンサル向け)
- 定型レポート・議事録要約・マニュアル整備など、文章業務の自動化
- コスト最適化のための“モデル使い分け”戦略
社内チャットボット/ナレッジ検索:機密情報を含む問い合わせ対応に
就業規則、人事評価シート、未公開製品の仕様書など、最高機密データを検索対象に含められます。
従業員が気兼ねなく社内情報を質問でき、情報探索のロスタイムをゼロに圧縮します。
情報漏洩リスクを一切冒すことなく、全社的な業務生産性を飛躍的に高める社内AI基盤を実現できます。
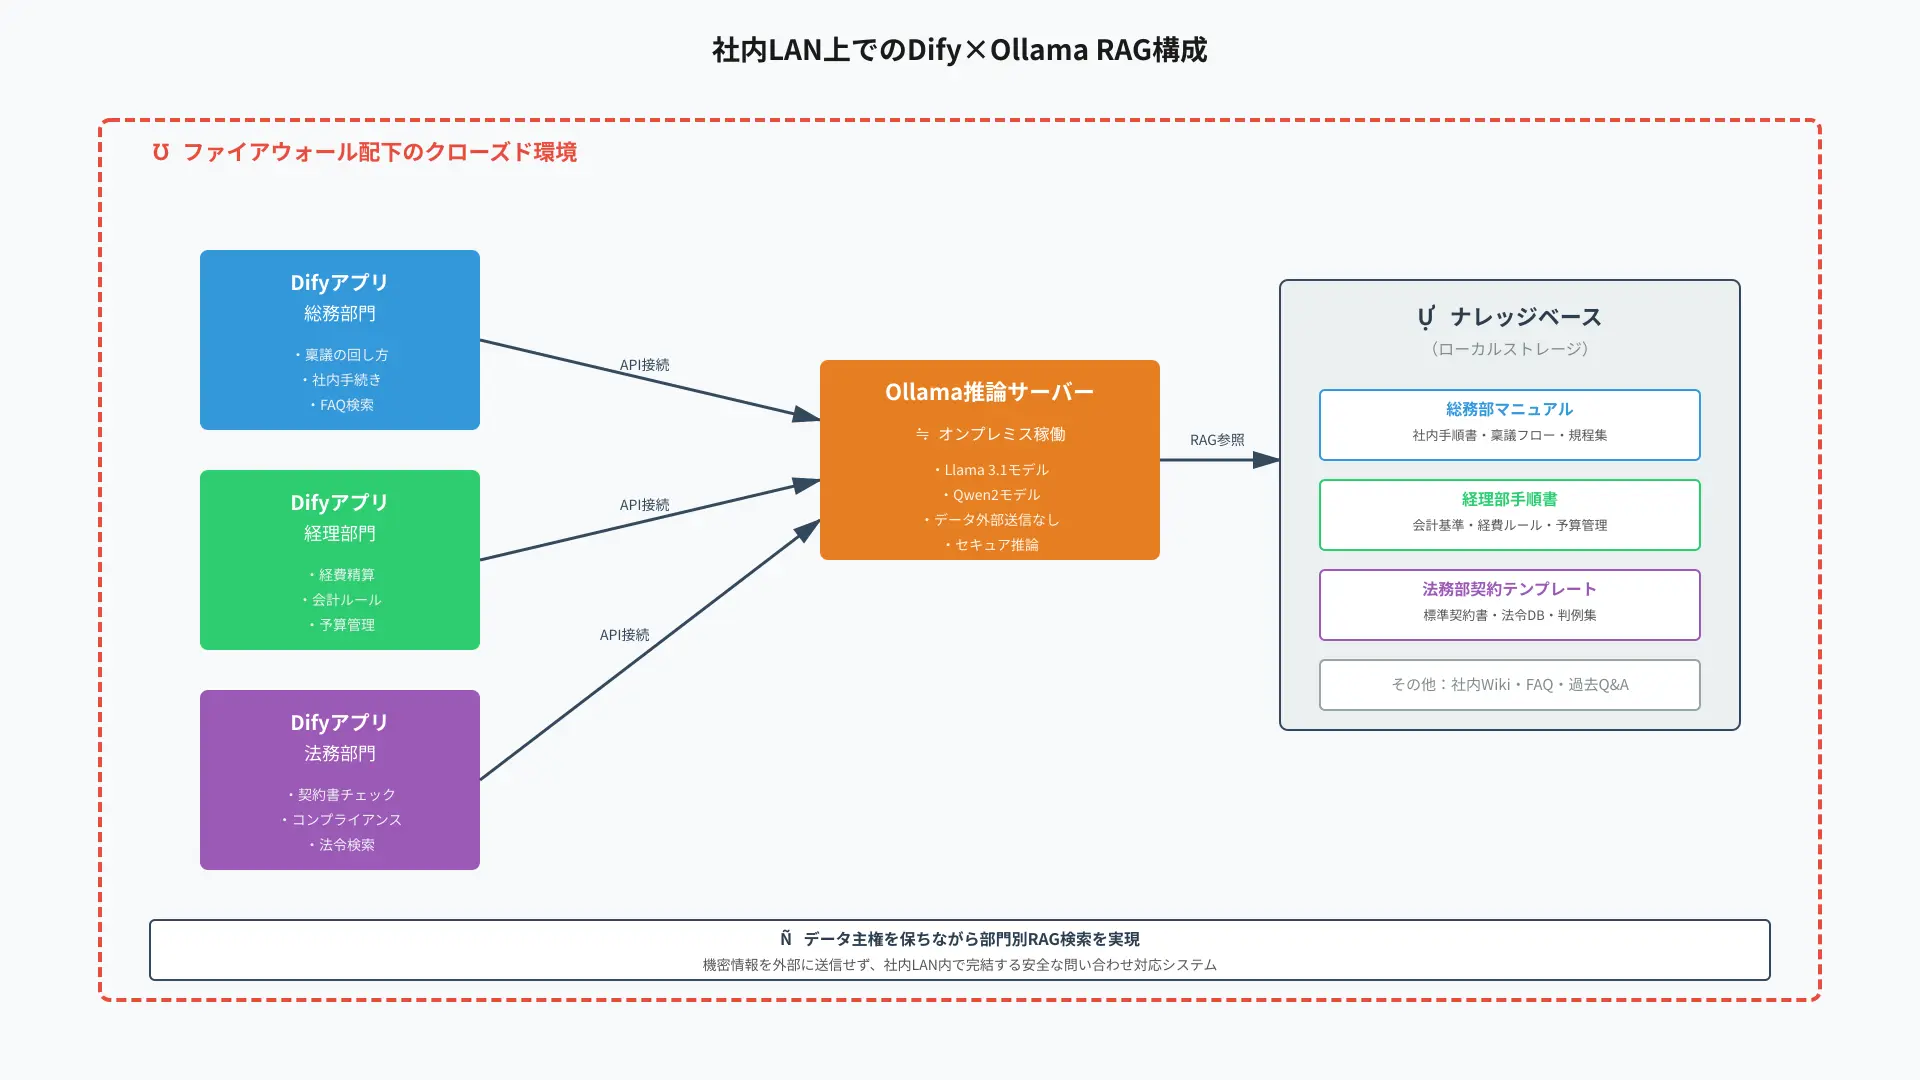
クライアント別の“プライベートAIアシスタント”(制作会社・コンサル向け)
顧客ごとに専用のローカル環境を立ち上げ、顧客データを完全に隔離した状態でAI支援を提供します。
NDA(秘密保持契約)の厳しいエンタープライズ顧客に対しても、自信を持ってAIソリューションを提案できます。
顧客からの信頼を強固に獲得し、他社と明確に差別化された高付加価値なサービス展開が可能になります。
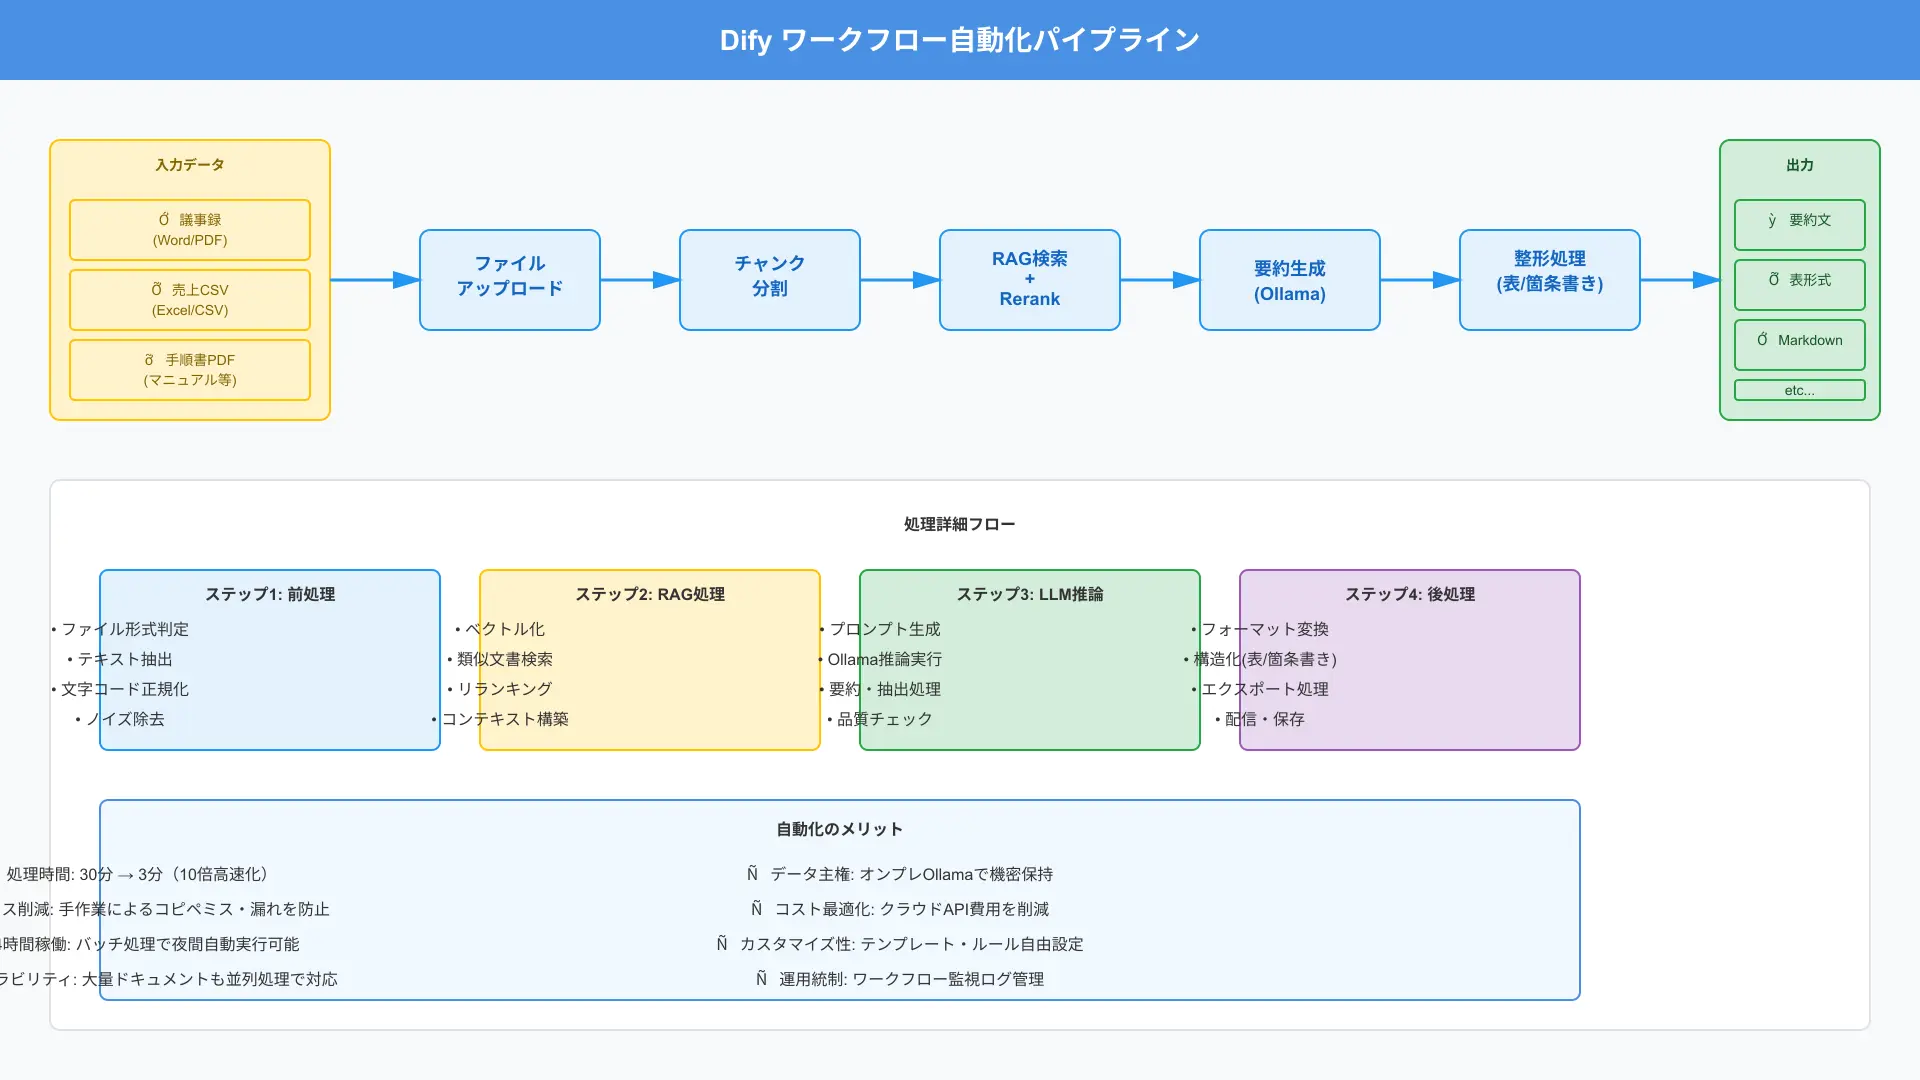
定型レポート・議事録要約・マニュアル整備など、文章業務の自動化
毎日の営業日報の集計や、会議音声の文字起こしテキストの要約バッチを夜間に自動実行します。
APIトークン代を一切気にすることなく、数万文字におよぶ長文データを思う存分処理させられます。
日常のルーティンワークから社員を解放し、創造的で付加価値の高いコア業務へ時間をシフトさせられます。
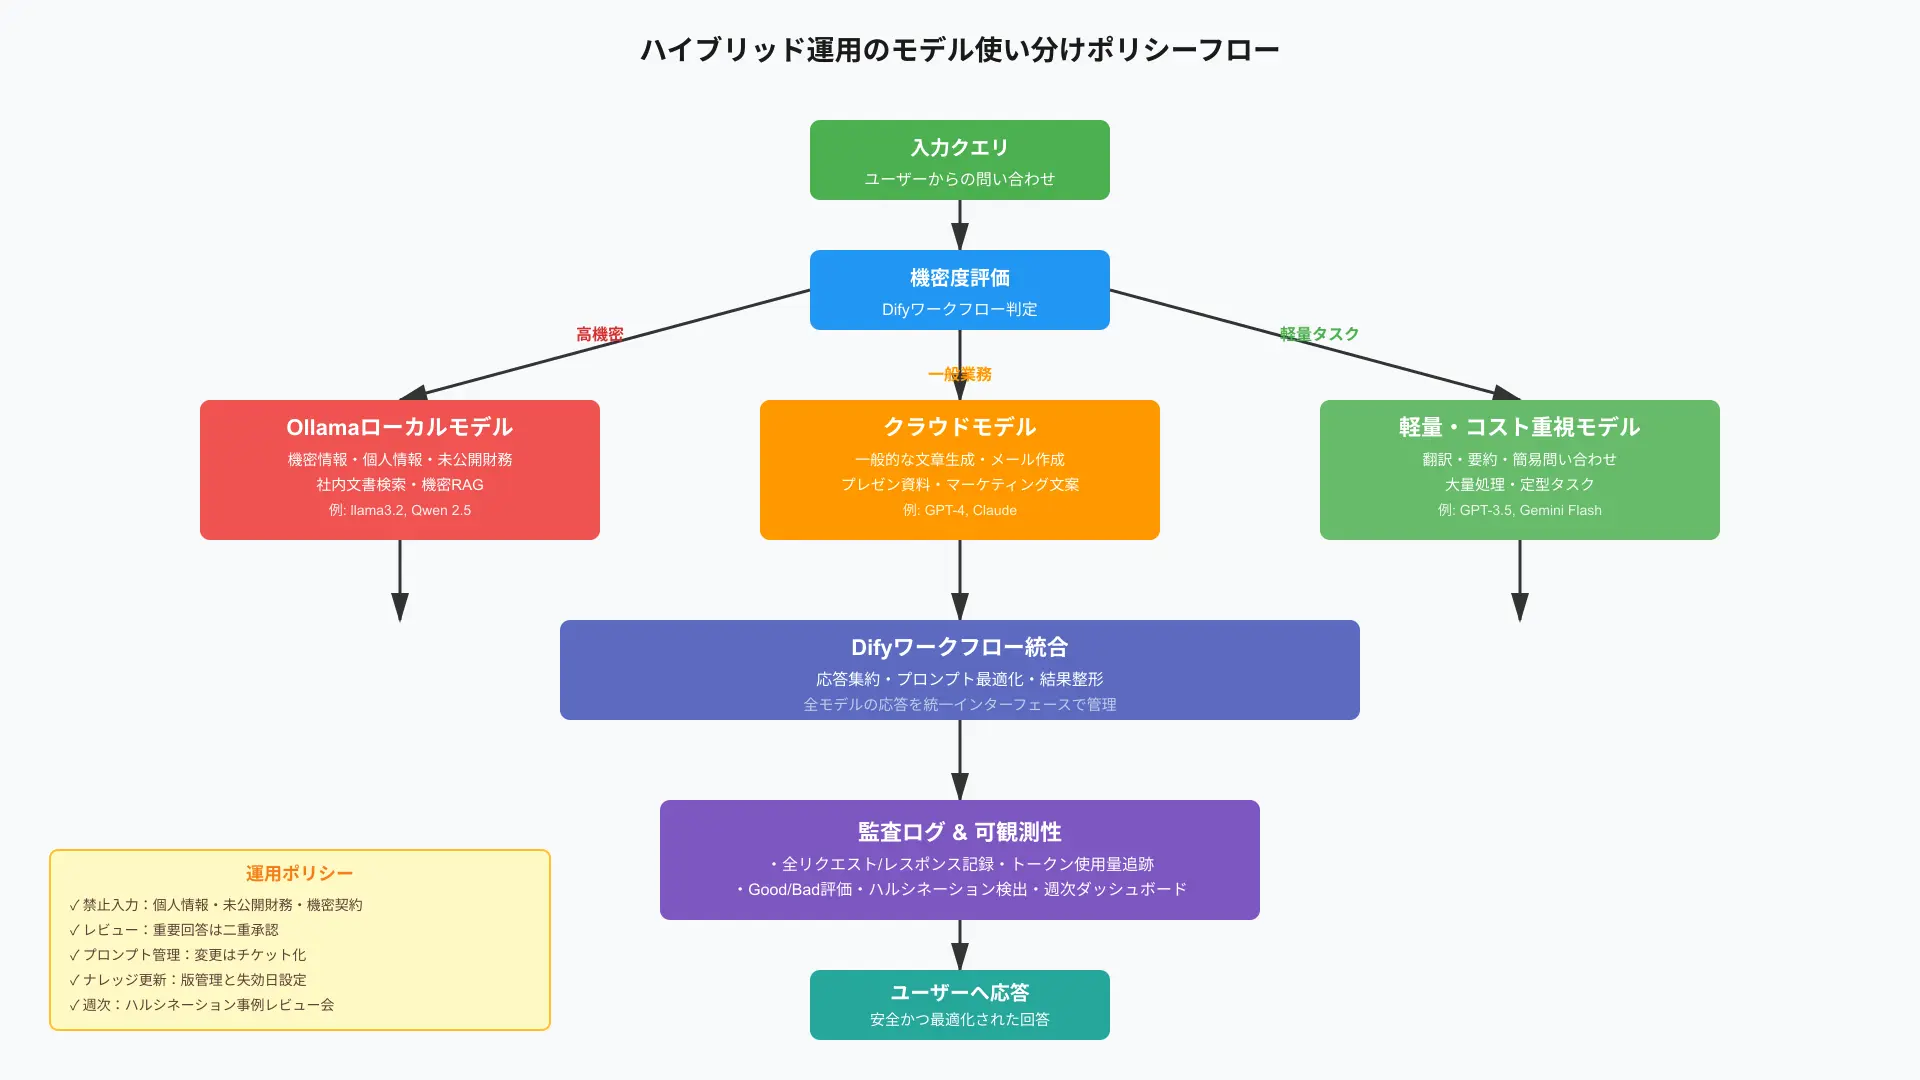
コスト最適化のための“モデル使い分け”戦略
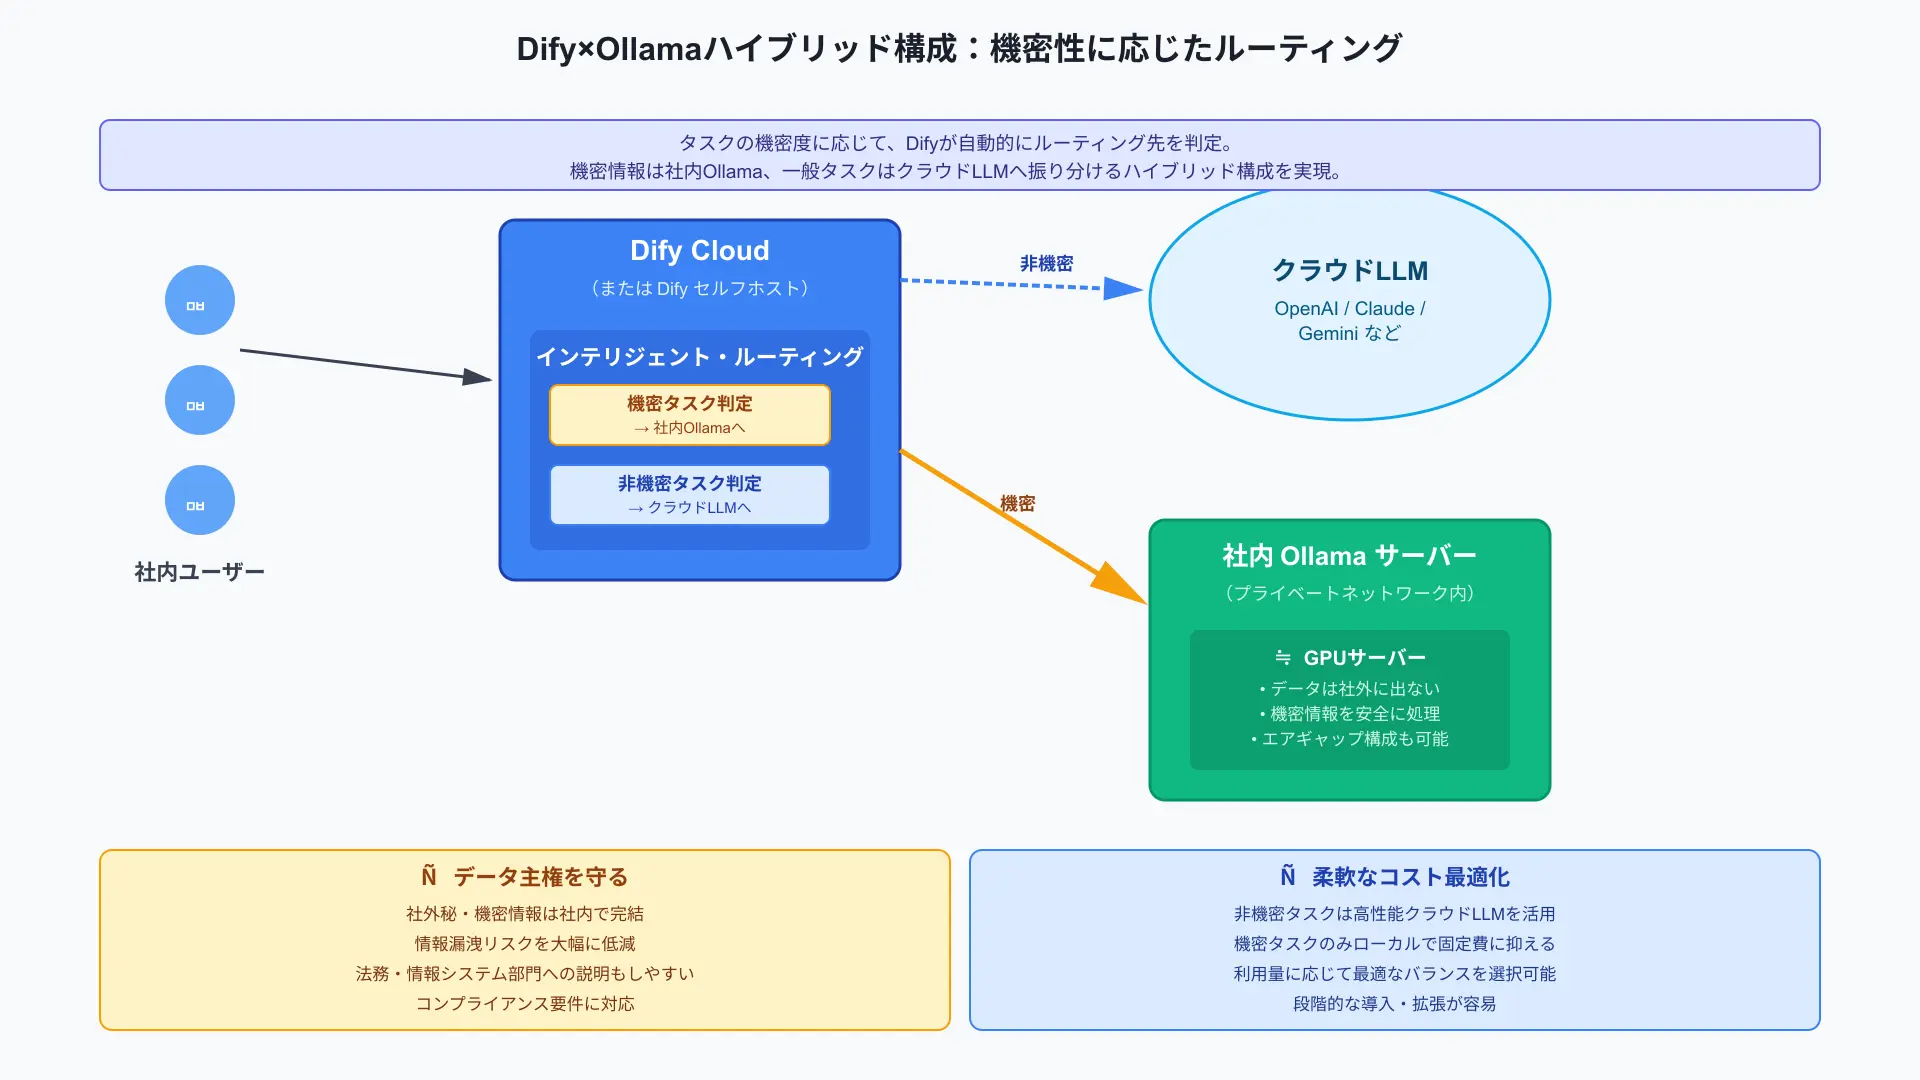
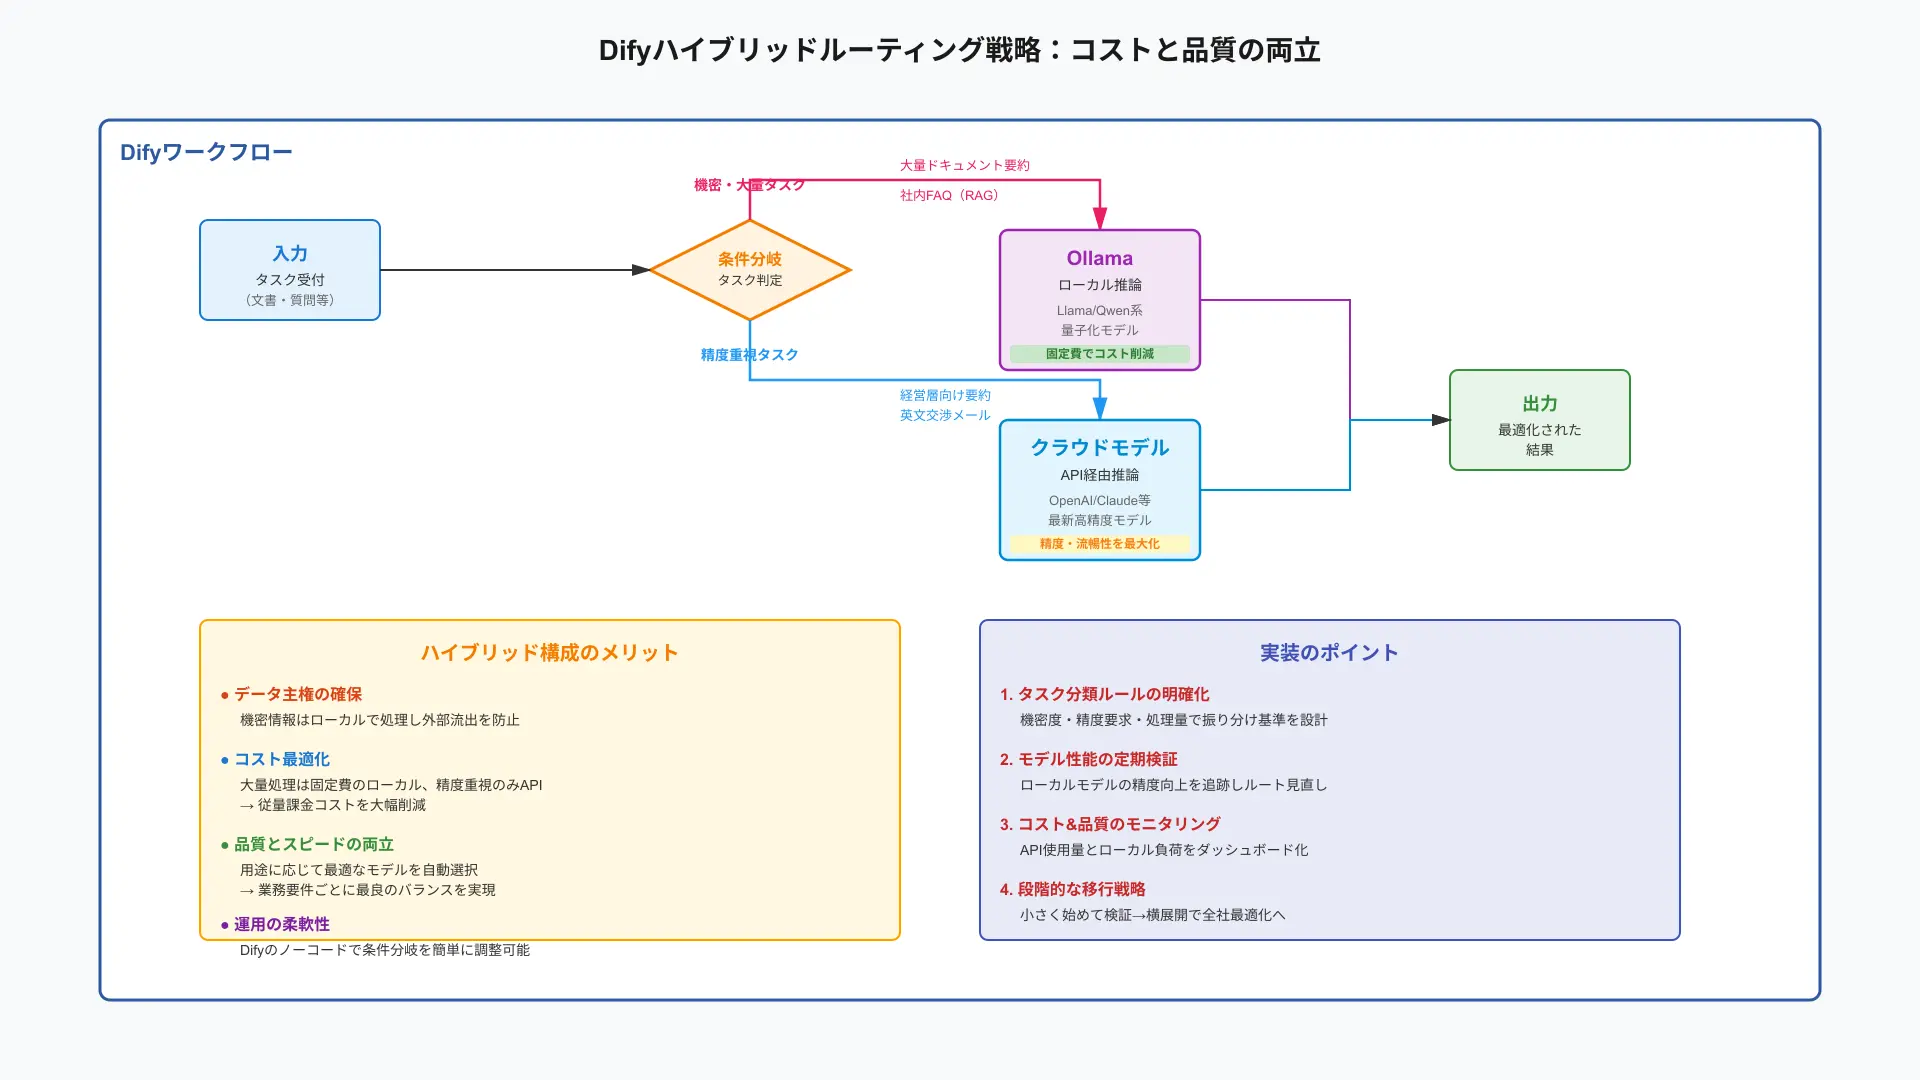
一般的な一次回答や簡単な分類タスクにはローカルのOllamaを割り当て、超高度な推論時のみClaude等を呼び出します。
Difyの条件分岐ノードを活用し、タスクの難易度に応じてリクエストを自動ルーティングします。
クラウドAPIの消費量を8割以上削減しながら、システム全体の知能水準と経済性を極限まで両立できます。
Dify×Ollamaと他の選択肢(Dify×OpenAI、LangFlow×Ollama等)の比較
当セクションでは、他のAI構築アプローチとの機能・コスト・運用の違いを比較解説します。
自社の要件に最も合致した技術スタックを客観的に選定できるようになるからです。
- Dify×Ollama vs Dify×OpenAI API:セキュリティ・コスト・導入スピードのトレードオフ
- Dify vs LangFlow/Flowise:ノーコードLLMツールとしてどこが違う?
- ローカルLLMにこだわらない構成(完全クラウド)を選ぶべきケース
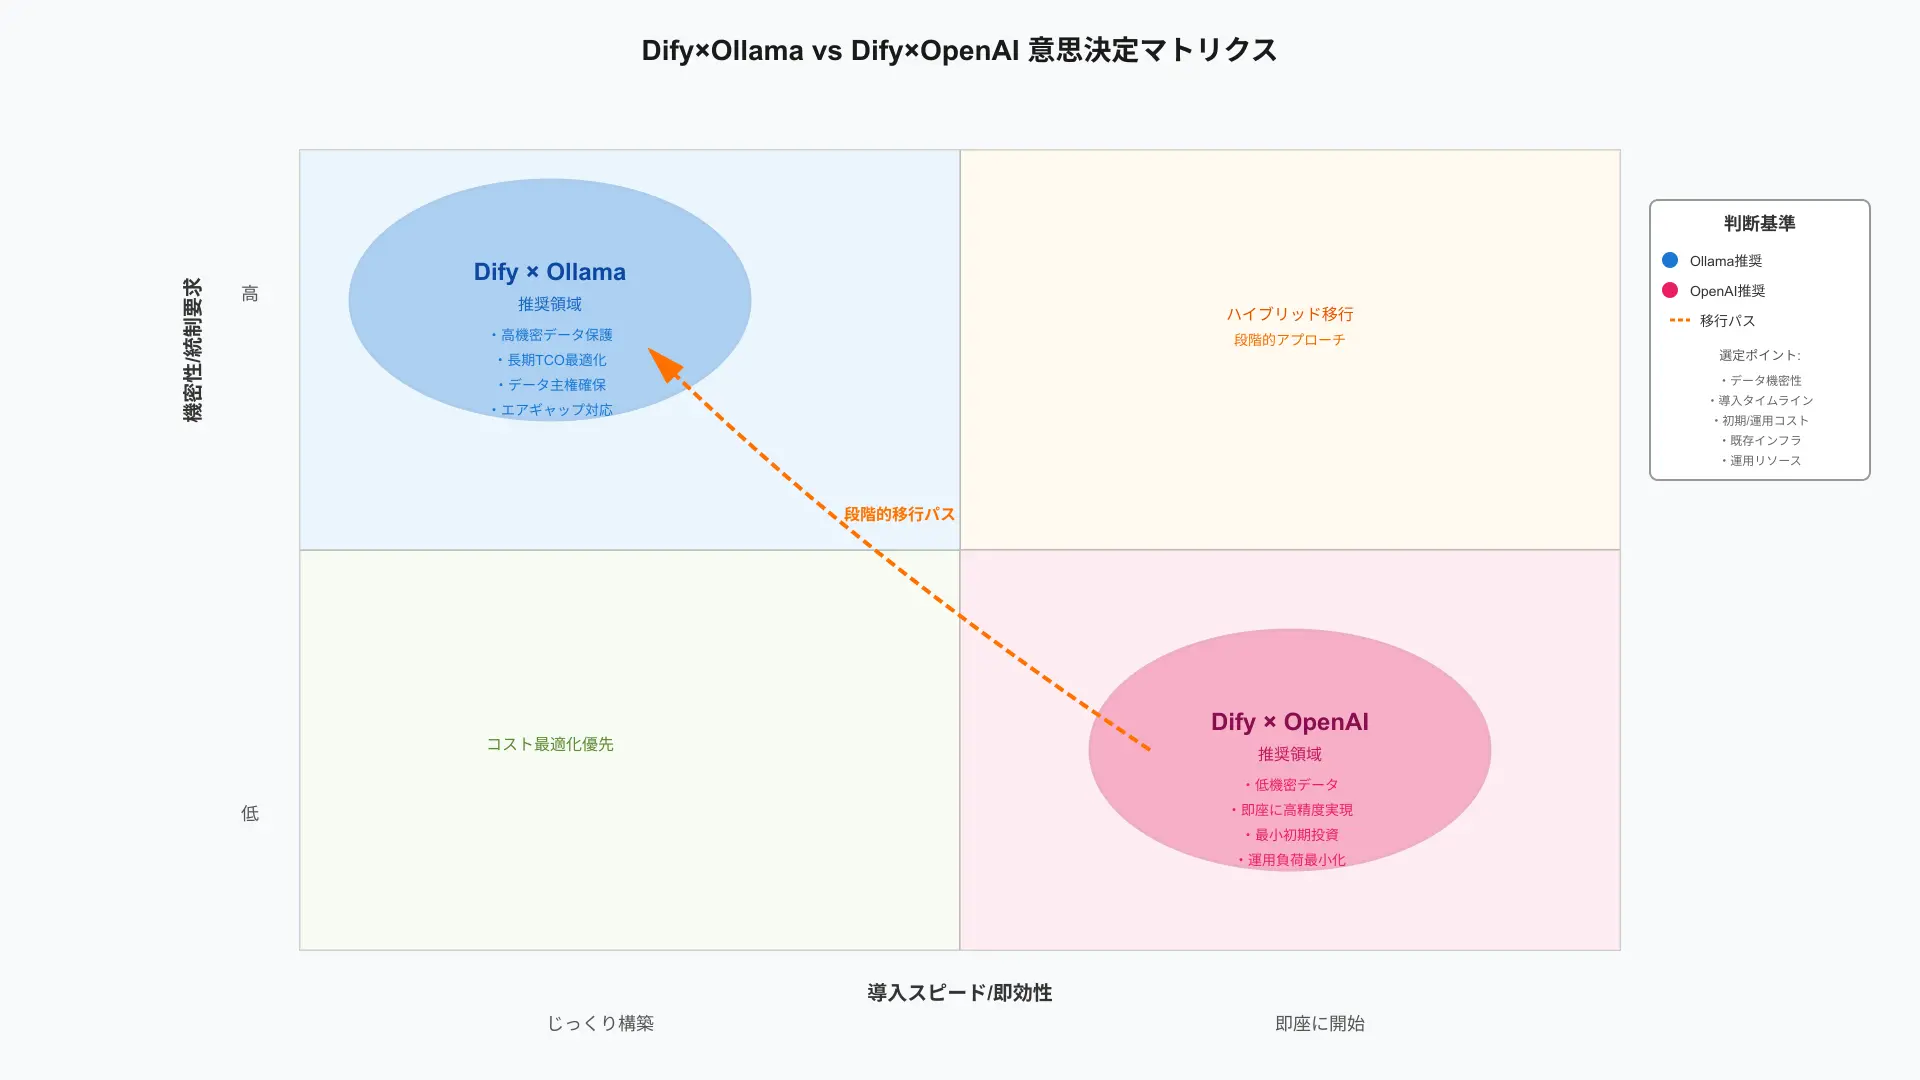
Dify×Ollama vs Dify×OpenAI API:セキュリティ・コスト・導入スピードのトレードオフ
Dify×OpenAIは即座に最高峰の知能を利用できますが、従量課金とクラウド通信が発生します。
Dify×Ollamaはハードウェア管理の手間があるものの、完全なデータ主権と固定費運用を実現します。
セキュリティポリシーと予算構造を照らし合わせ、自社にとって最適なトレードオフを選択しましょう。
Dify vs LangFlow/Flowise:ノーコードLLMツールとしてどこが違う?
LangFlowやFlowiseは開発者向けのプロトタイピングに特化しているのに対し、Difyは本番運用のLLMOpsに強みを持ちます。
エンドユーザー向けUIの自動生成、ログ分析、チーム権限管理が最初から完成されています。
開発から全社展開までをスムーズに一本化し、組織的なAI運用プラットフォームとして活用できます。
ローカルLLMにこだわらない構成(完全クラウド)を選ぶべきケース
公開情報の検索や、最先端フロンティアモデルの卓越した多言語能力が必須となるプロジェクトです。
また、社内にGPUサーバーを保守するエンジニアリソースが全く存在しない場合もクラウド版が推奨されます。
無理にローカル化を強行するのではなく、プロジェクトの性質に応じた現実的なアーキテクチャを選択しましょう。
商用利用時に押さえておきたいライセンスとガバナンスのポイント
当セクションでは、企業でローカルLLMを商用運用する際の法的・組織的留意点を解説します。
ライセンス違反やセキュリティインシデントを未然に防ぎ、健全な運用を維持できるからです。
Difyの提供形態と料金プラン:Cloud vs セルフホスト
Difyのオープンソース版(Community)は無料でセルフホスト可能ですが、ロゴ変更やSSO連携には制限があります。
大規模な全社展開や商用SaaSのバックエンドとして組み込む場合はEnterpriseライセンスを検討します。
自社のビジネスモデルに合わせて、適切なライセンス契約を締結して安全に運用しましょう。
Ollama自体は無料でも“モデルごとのライセンス”には要注意
Ollamaソフトウェア自体はMITライセンスですが、動作させるモデル(Llama、Qwen、DeepSeek等)ごとに規約が異なります。
月間アクティブユーザー数による制限や、商用利用時のクレジット表示義務などを必ず確認します。
各モデルの利用規約(License Agreement)を精査し、法務リスクを完全にクリアしたクリーンな運用を徹底します。
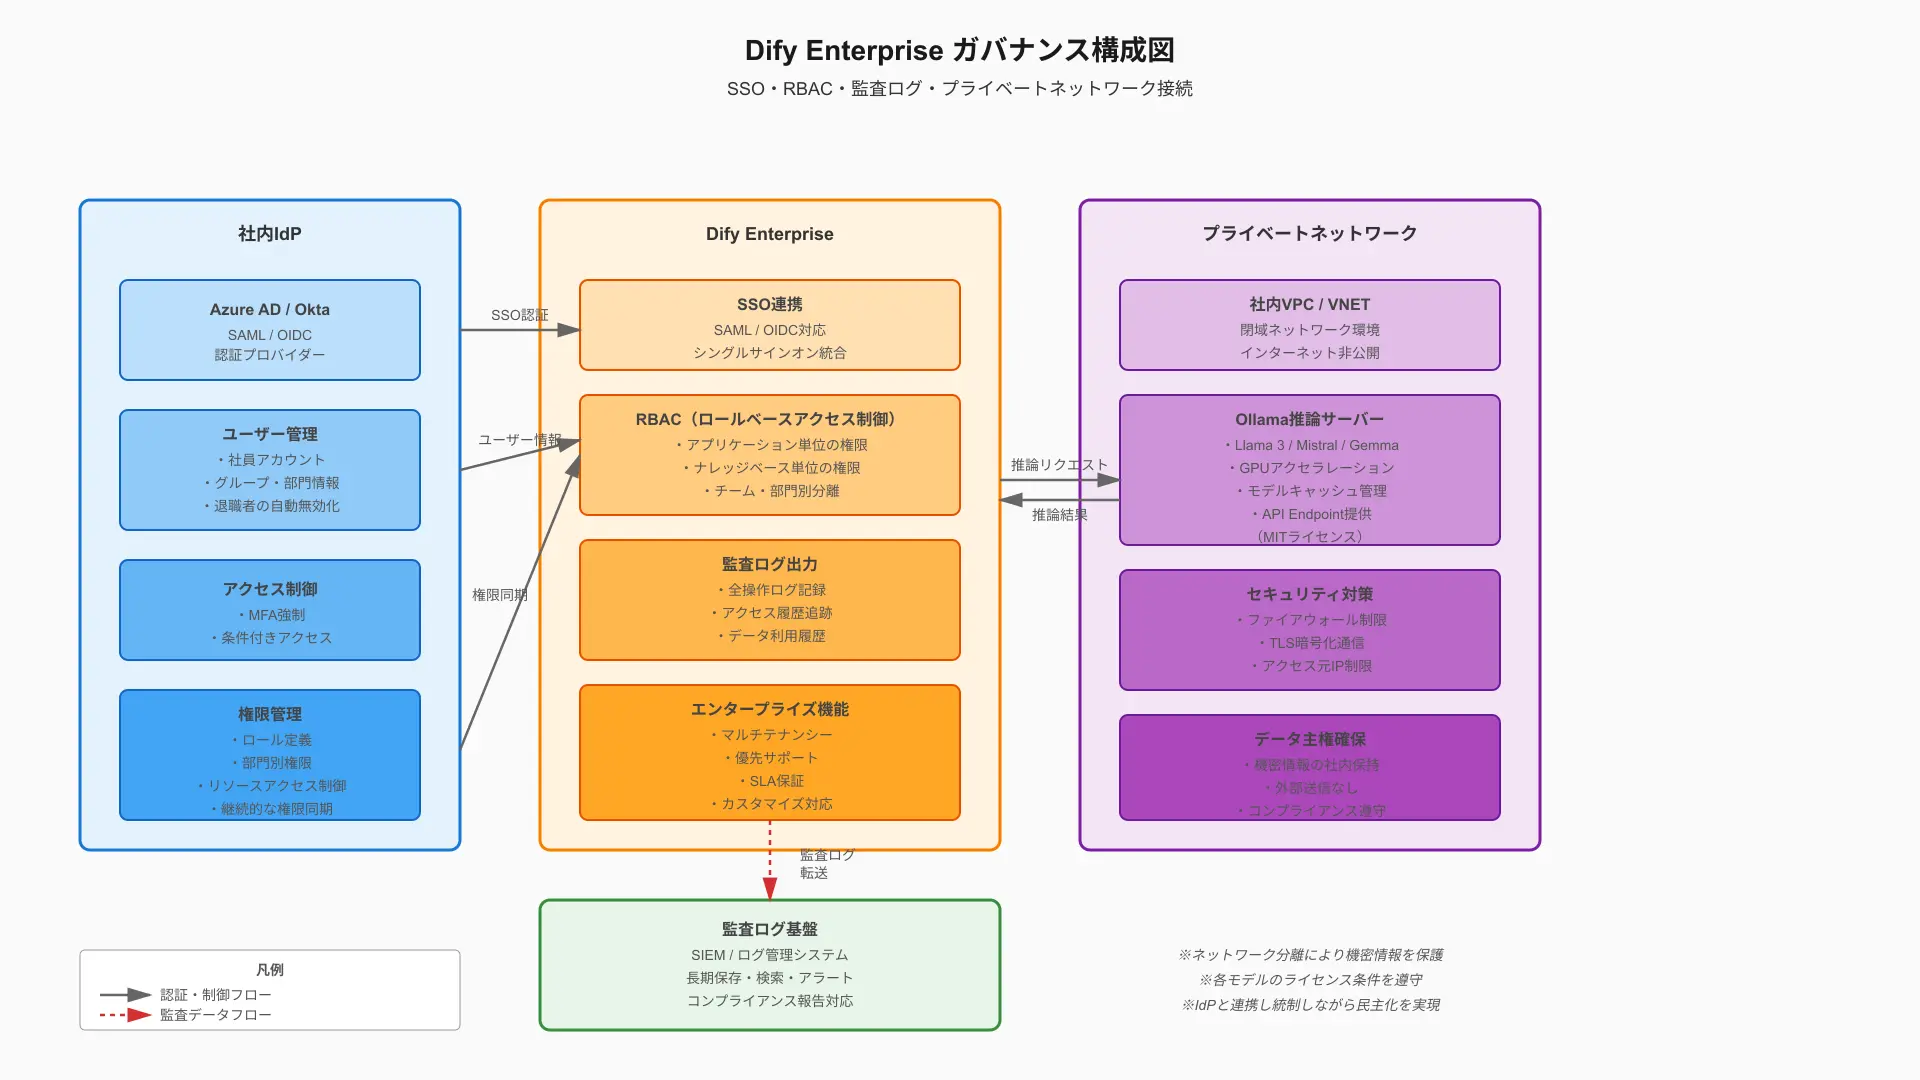
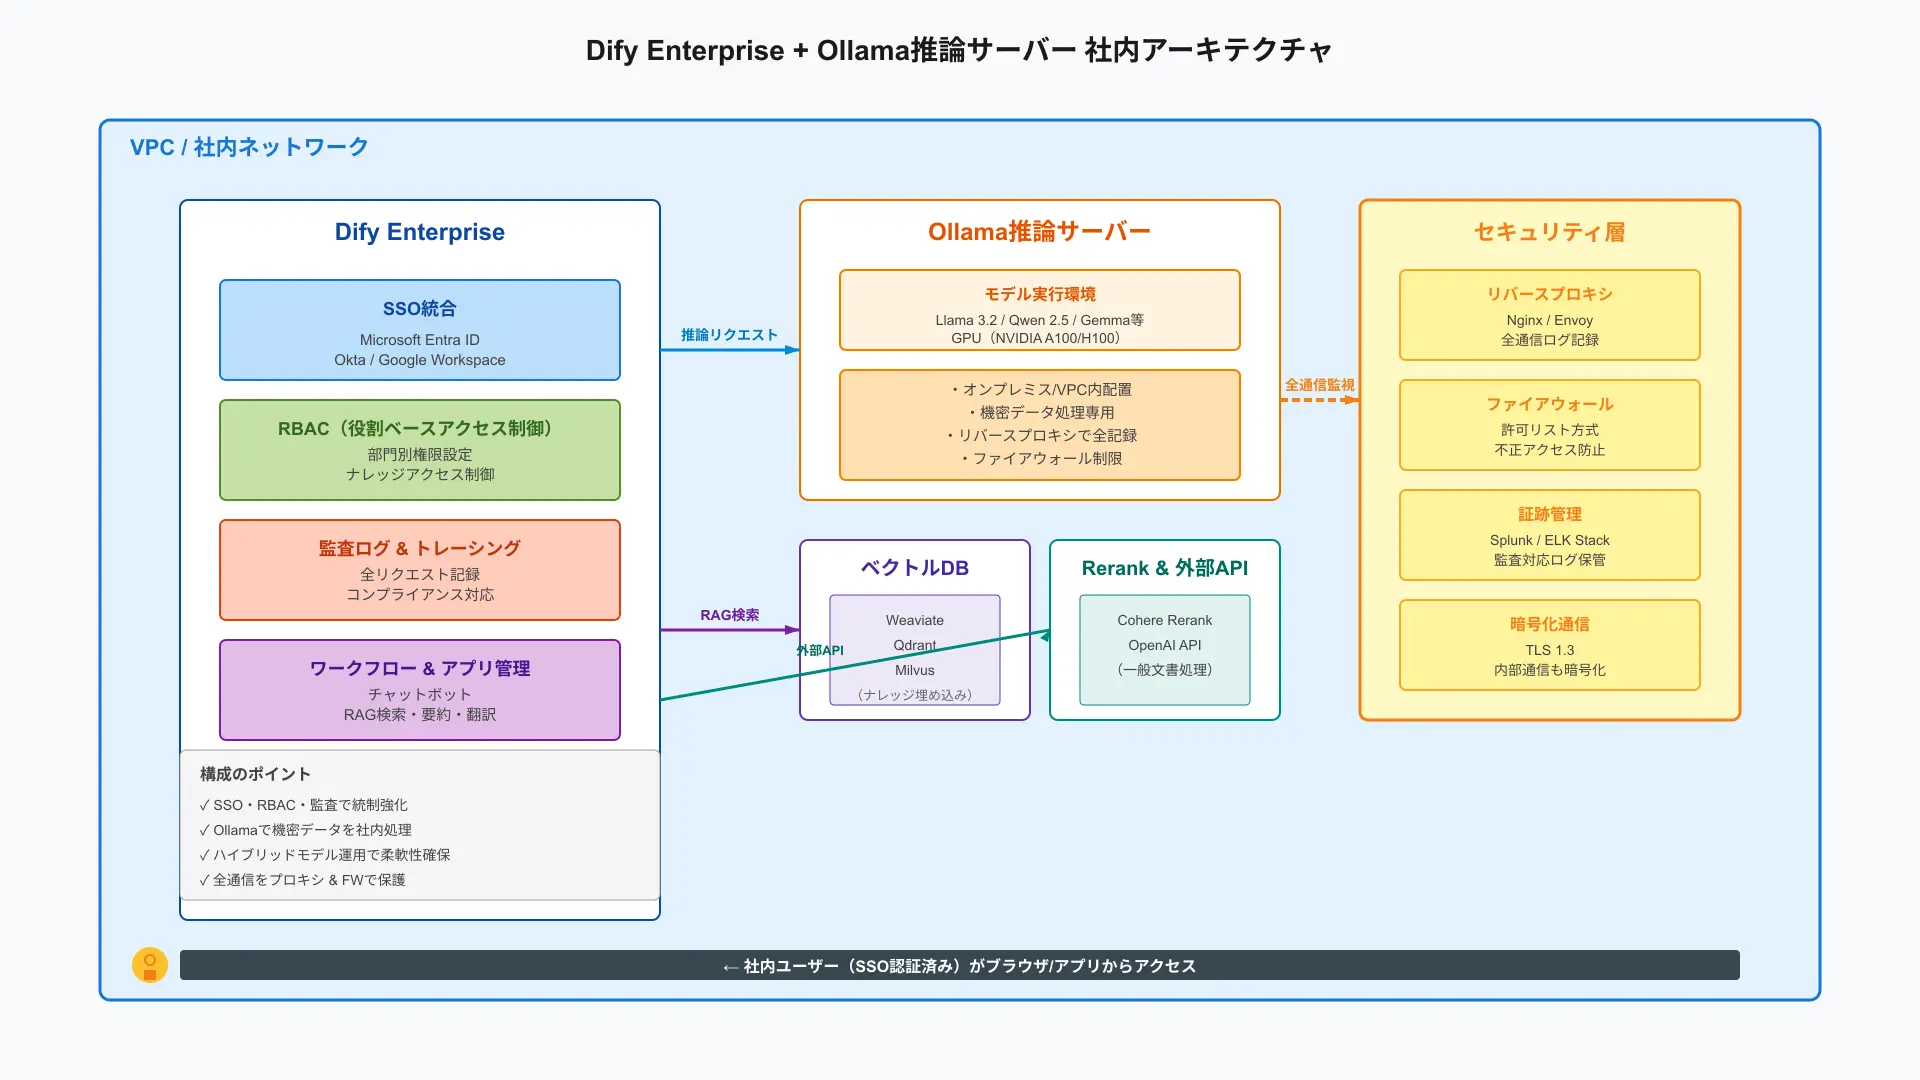
エンタープライズで求められるガバナンス:SSO・監査ログ・アクセス制御
誰がどのモデルやドキュメントにアクセスしたかを追跡できる詳細な監査ログを保管します。
OktaやAzure ADとのSAML/SSO連携を設定し、退職者のアクセスを即座に遮断できる体制を整えます。
内部統制基準を満たす強固なガバナンスを敷くことで、大企業でも安心して利用できる社内AI環境が確立します。
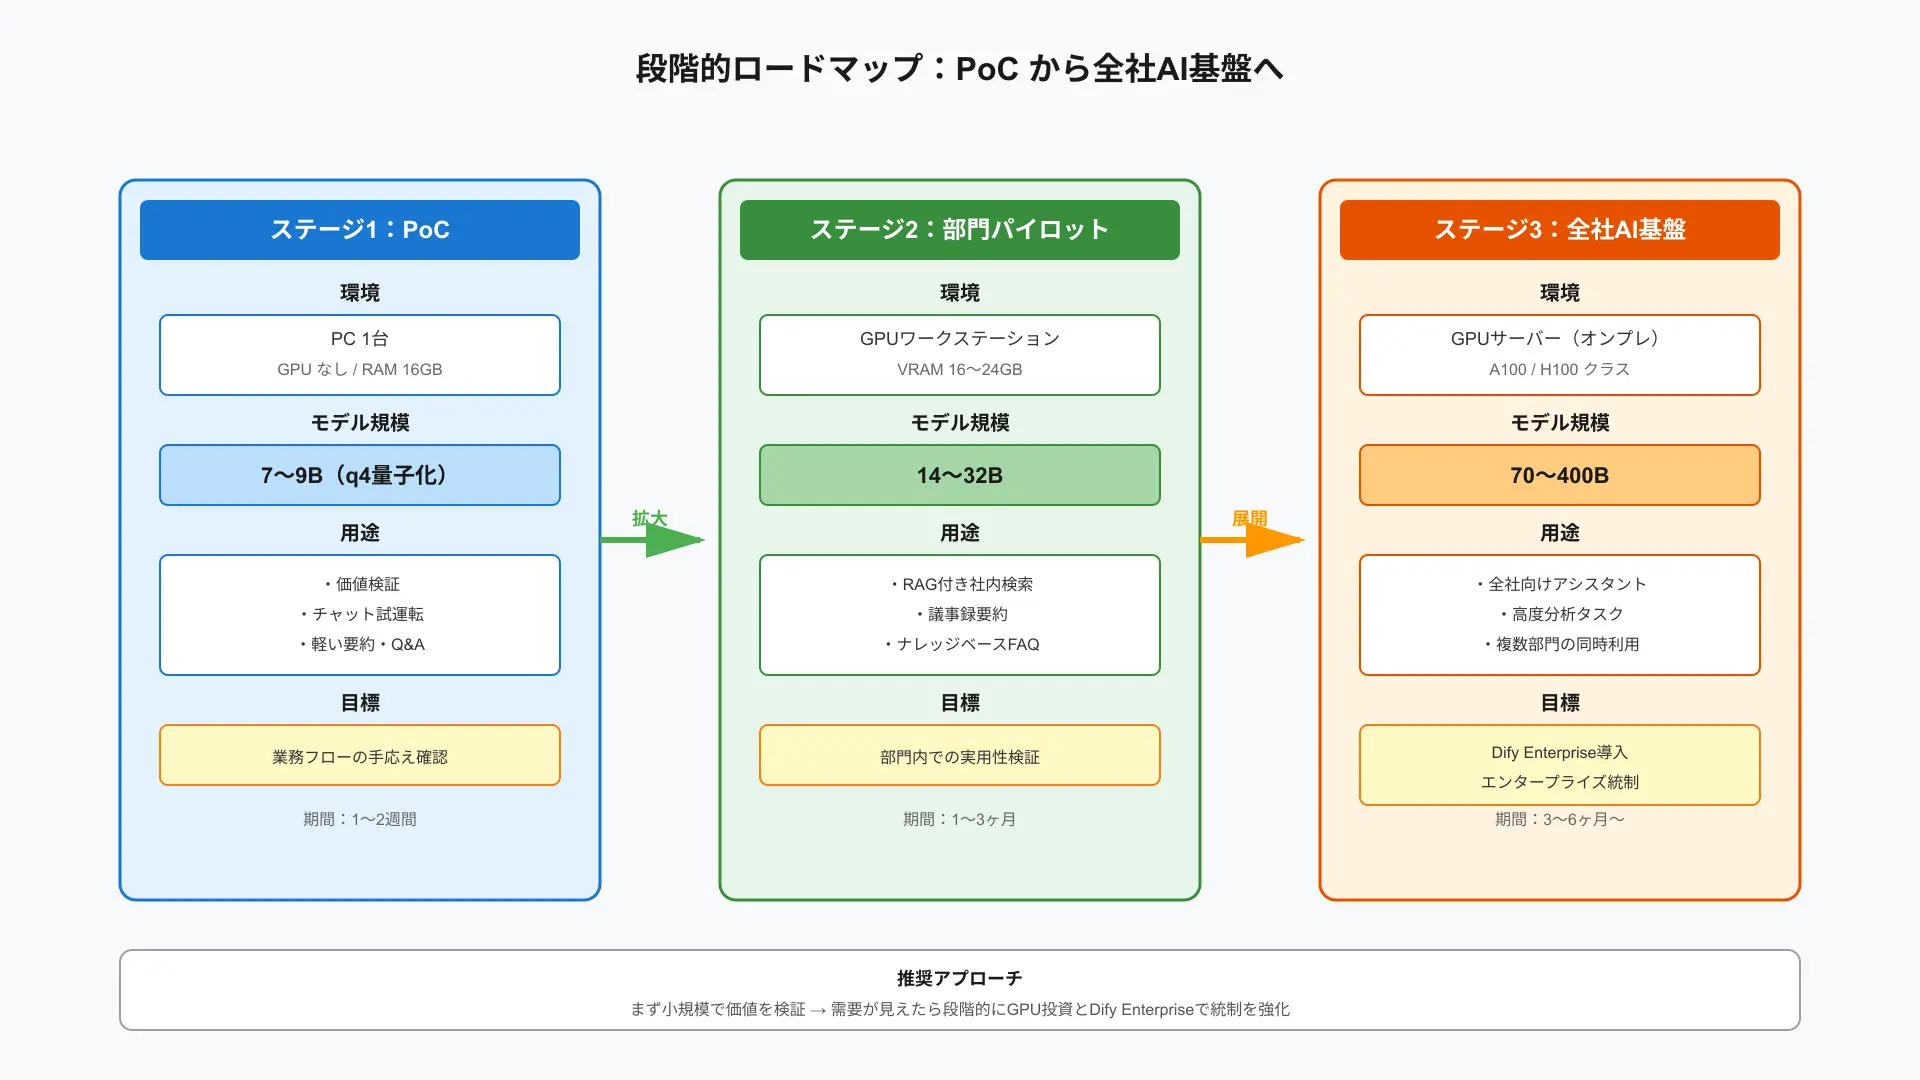
これから始める人へのロードマップ:1週間でPoC→数ヶ月で社内展開へ
当セクションでは、Dify×Ollamaを自社へ段階的に導入するための実践ロードマップを解説します。
ステップを踏んで推進することで、投資リスクを最小限に抑えながら確実に成功へ導けるからです。
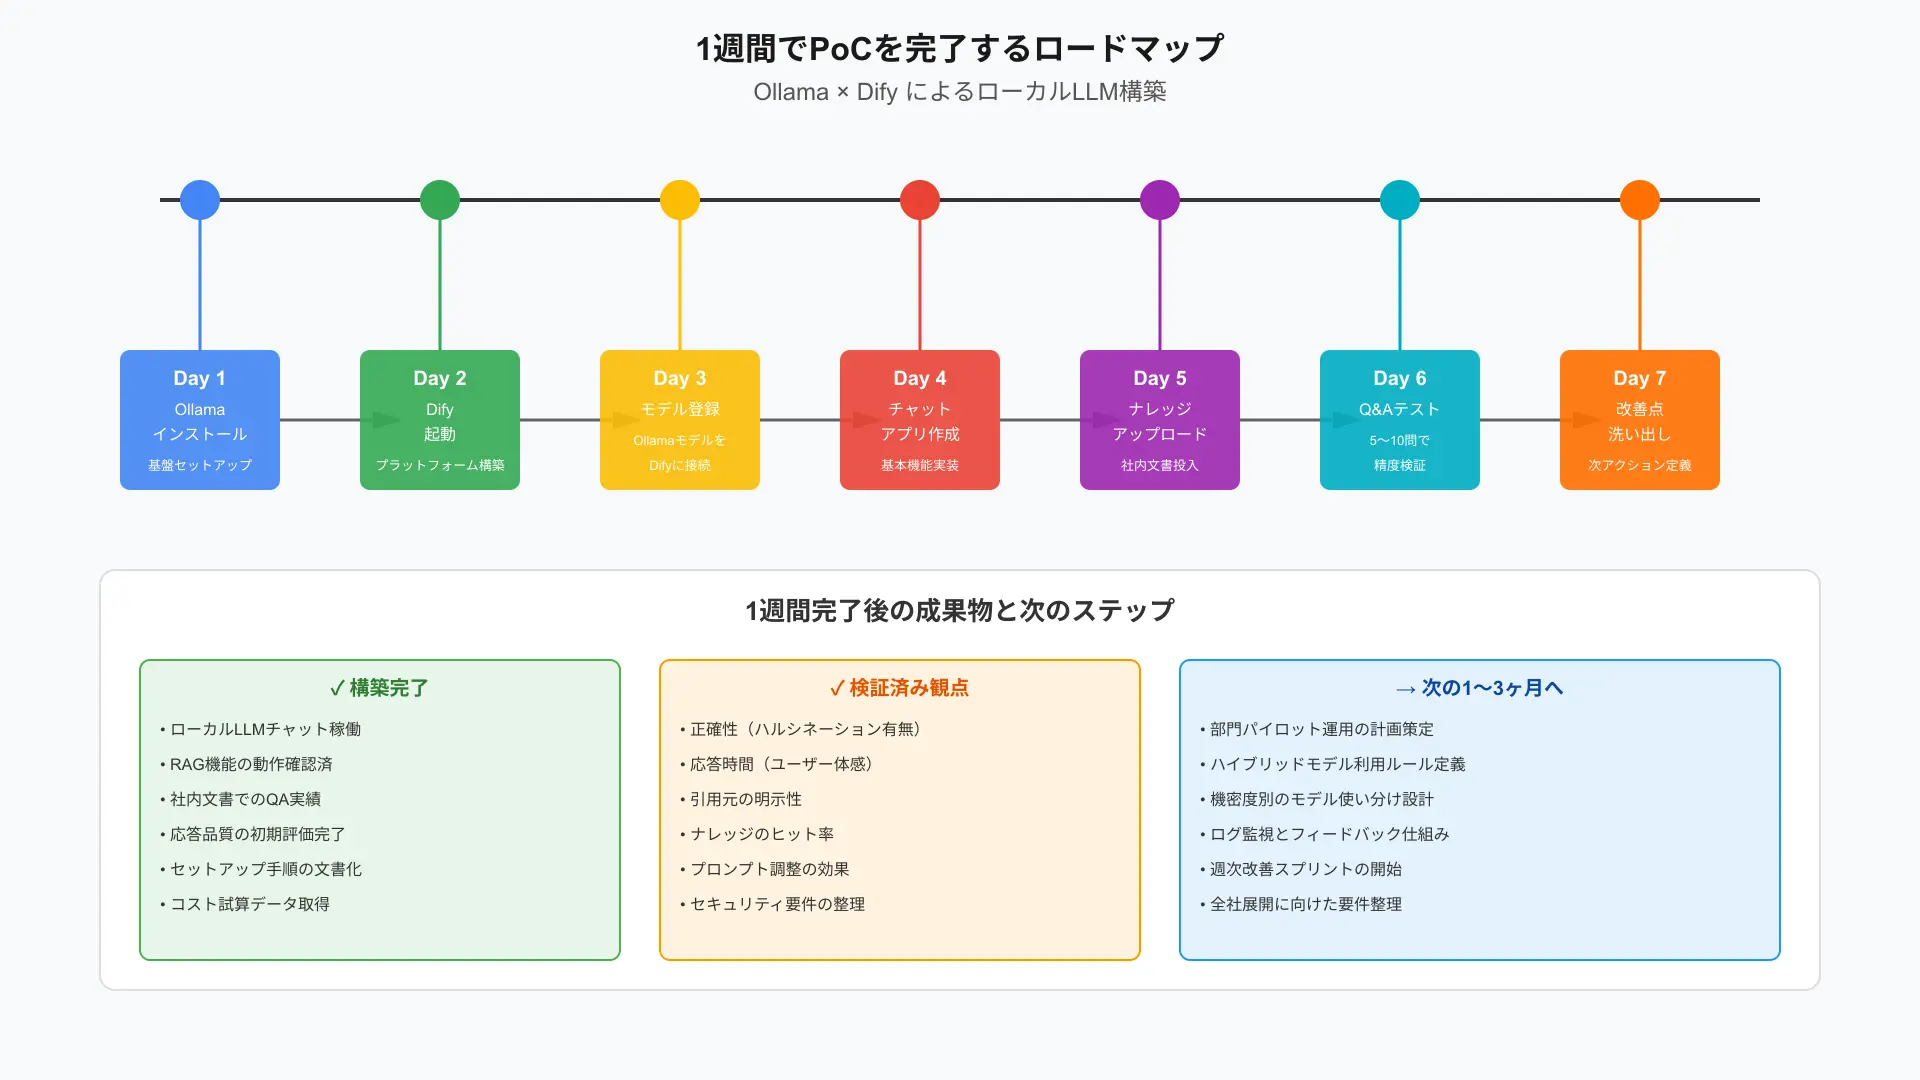
- 1週間でできること:自分のPC上でローカルLLMチャット+簡易RAGを動かす
- 1〜3ヶ月で目指す姿:部門単位のパイロット運用とハイブリッドモデル利用
- 3ヶ月以降:本格内製化を見据えたDify Enterprise+専用GPUサーバーも選択肢に
1週間でできること:自分のPC上でローカルLLMチャット+簡易RAGを動かす
まずは手元のPCでOllamaを起動し、Difyと連携させて数個の社内PDFを読み込ませます。
ローカル環境特有のレスポンス速度や回答精度を体感し、自社課題への適合性を検証します。
一切の初期費用をかけることなく、数日で確かな手応えを得るスピーディーなPoCを実行できます。
1〜3ヶ月で目指す姿:部門単位のパイロット運用とハイブリッドモデル利用
部署内の共有ワークステーションに環境を移し、10〜20名のメンバーで日常業務に試験導入します。
現場からのフィードバックを収集してプロンプトやナレッジベースをブラッシュアップします。
業務効率化の実績データを着実に積み上げ、全社展開に向けた強力な稟議材料を準備できます。
3ヶ月以降:本格内製化を見据えたDify Enterprise+専用GPUサーバーも選択肢に
専用のGPUサーバーをデータセンターに設置し、全社員が利用する共通AIプラットフォームとして本番稼働させます。
社内の各基幹システムとAPI連携し、あらゆる業務プロセスにAIを深く組み込みます。
完全なデータ主権と圧倒的な開発スピードを両立し、企業の競争力を根本から高めるAIトランスフォーメーションが完成します。
まとめ
DifyとOllamaを組み合わせることで、完全閉域網でのセキュアなローカルAI環境をノーコードで素早く構築できます。
機密データの漏洩を防ぎながらAPI従量課金ゼロの固定費運用を実現し、社内RAGや業務自動化を力強く推進できます。
まずは手元のPCでOllamaを起動し、次世代のローカルAIアプリケーション開発を今すぐ体験してください!
【成果持ち帰り型3週間】
研修だけで終わらせない!「自社専用AI」定着パッケージ
「社員がAIを使えない」「自社商材に合わない」を解決。講師がその場で実務用にカスタマイズ。月額10万円〜。
自社内に強固なローカルAI基盤を打ち立て、安全で持続可能なDXを実現しましょう。