(最終更新日: 2026年08月27日)
「Difyで構築したAIアプリをAPI経由で自社システムやWebサイトに連携させたいが、具体的なエンドポイントの仕様や実装方法が分からない」とお悩みではありませんか?
2026年最新のDifyは、単なるプロンプト実行環境を超えて、RAG・ワークフロー・エージェントを包括する『AIバックエンド(BaaS: Backend as a Service)』として企業のプロダクト開発に不可欠な存在となっています。
OpenAIやAnthropicのAPIを直接叩く場合と比較して、Dify APIを活用することでプロンプト改善やナレッジベースの更新をGUI上で非エンジニアでも行えるようになり、開発工数を最大90%削減可能です。
本記事では、主要エンドポイント(/chat-messages, /workflows/run, /completion-messages)の設計から、SSEストリーミング処理、認証セキュリティ、2層料金体系、TCO比較までプロの視点で完全解説します。
この記事を読めば、Dify APIを安全かつ効率的に自社サービスへ組み込むための全知識が手に入ります!
Dify APIの全体像:他LLM APIとの違いと基本コンセプト
当セクションでは、Dify APIのアーキテクチャと従来のLLM直接呼び出しとの本質的な違いを解説します。
BaaSとしての位置付けを理解することで、自社プロダクトにおける役割分担が明確になるからです。
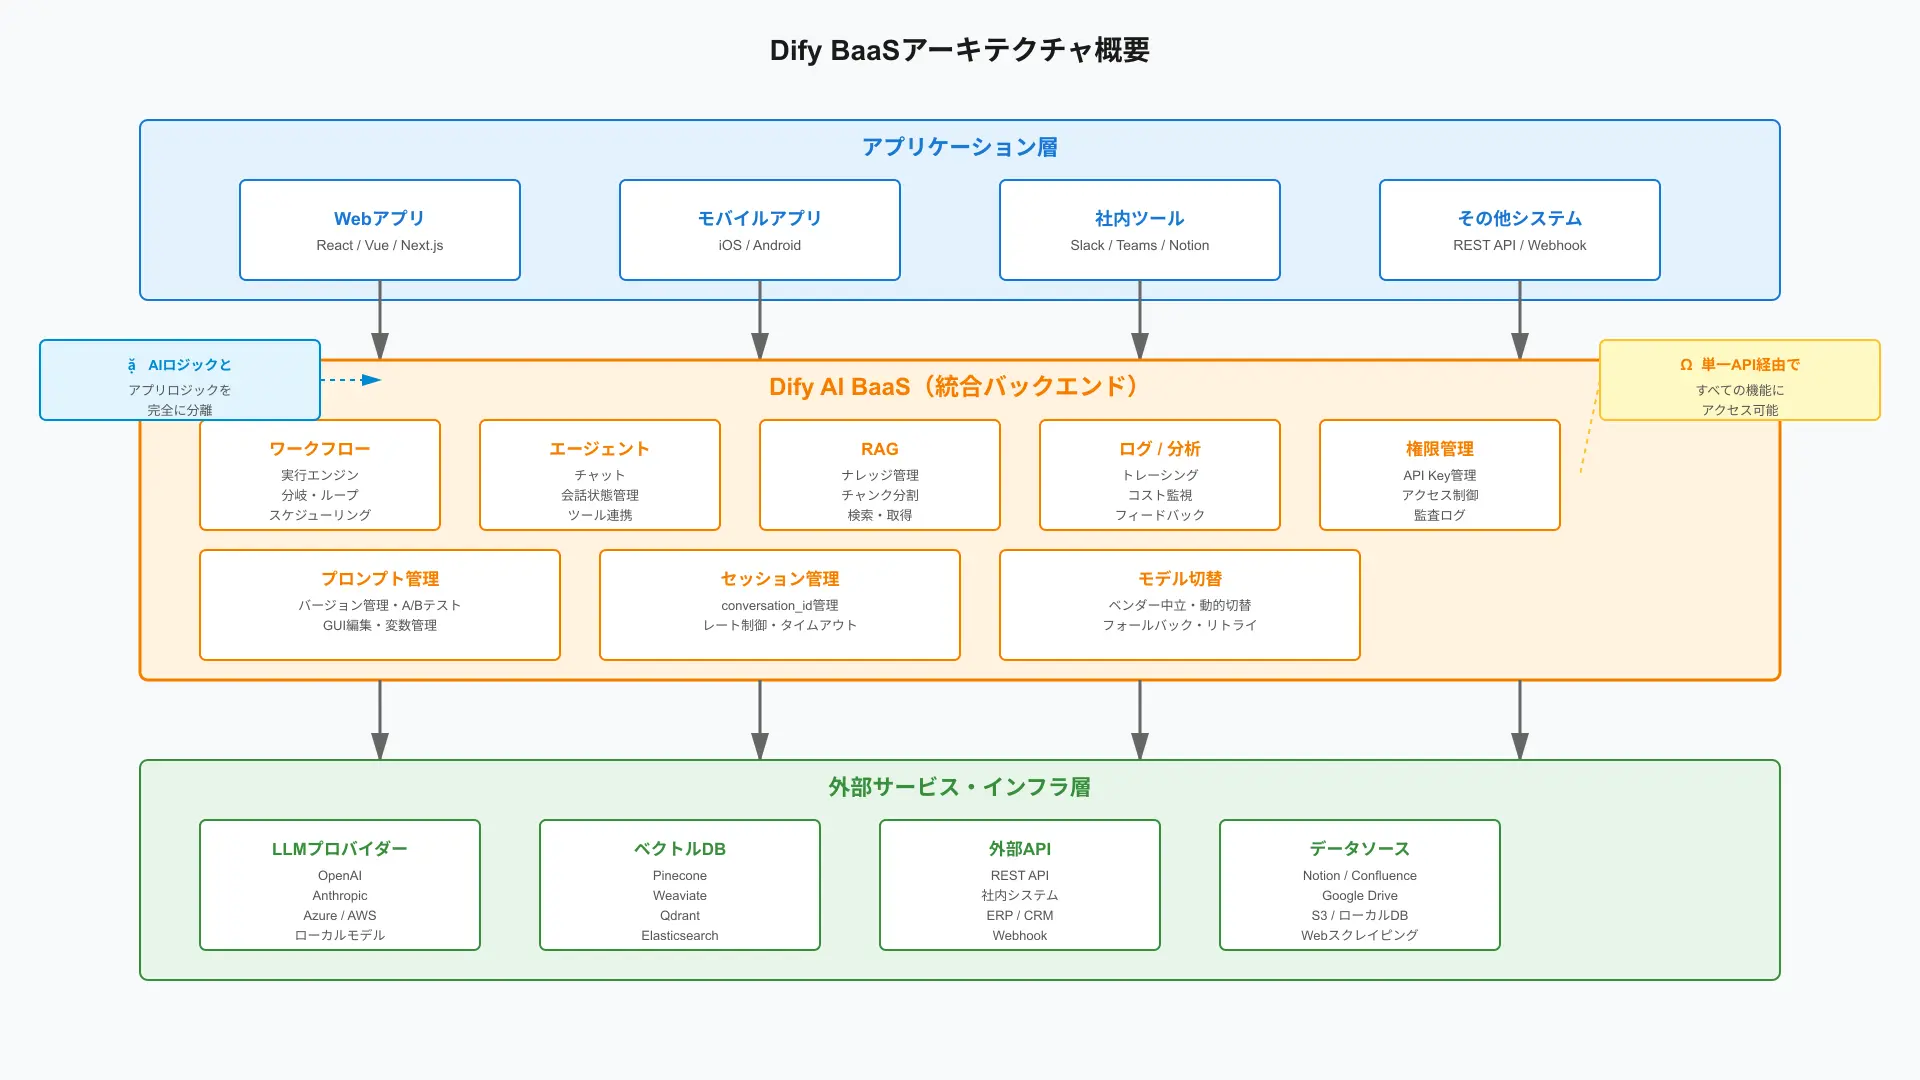
Difyは「LLMのラッパー」ではなくAIバックエンド(BaaS)
Difyはモデルの呼び出しだけでなく、プロンプト管理・RAG・ツール連携・ログ監査を内包する包括的なBaaS基盤です。
バックエンド開発者が複雑なLLMオーケストレーションコードをゼロから自作する必要が一切なくなります。
アプリケーションのビジネスロジックとAIロジックを完全に分離し、GUI側でのプロンプト調整が即座にAPI出力へ反映される俊敏な開発環境を実現できます。
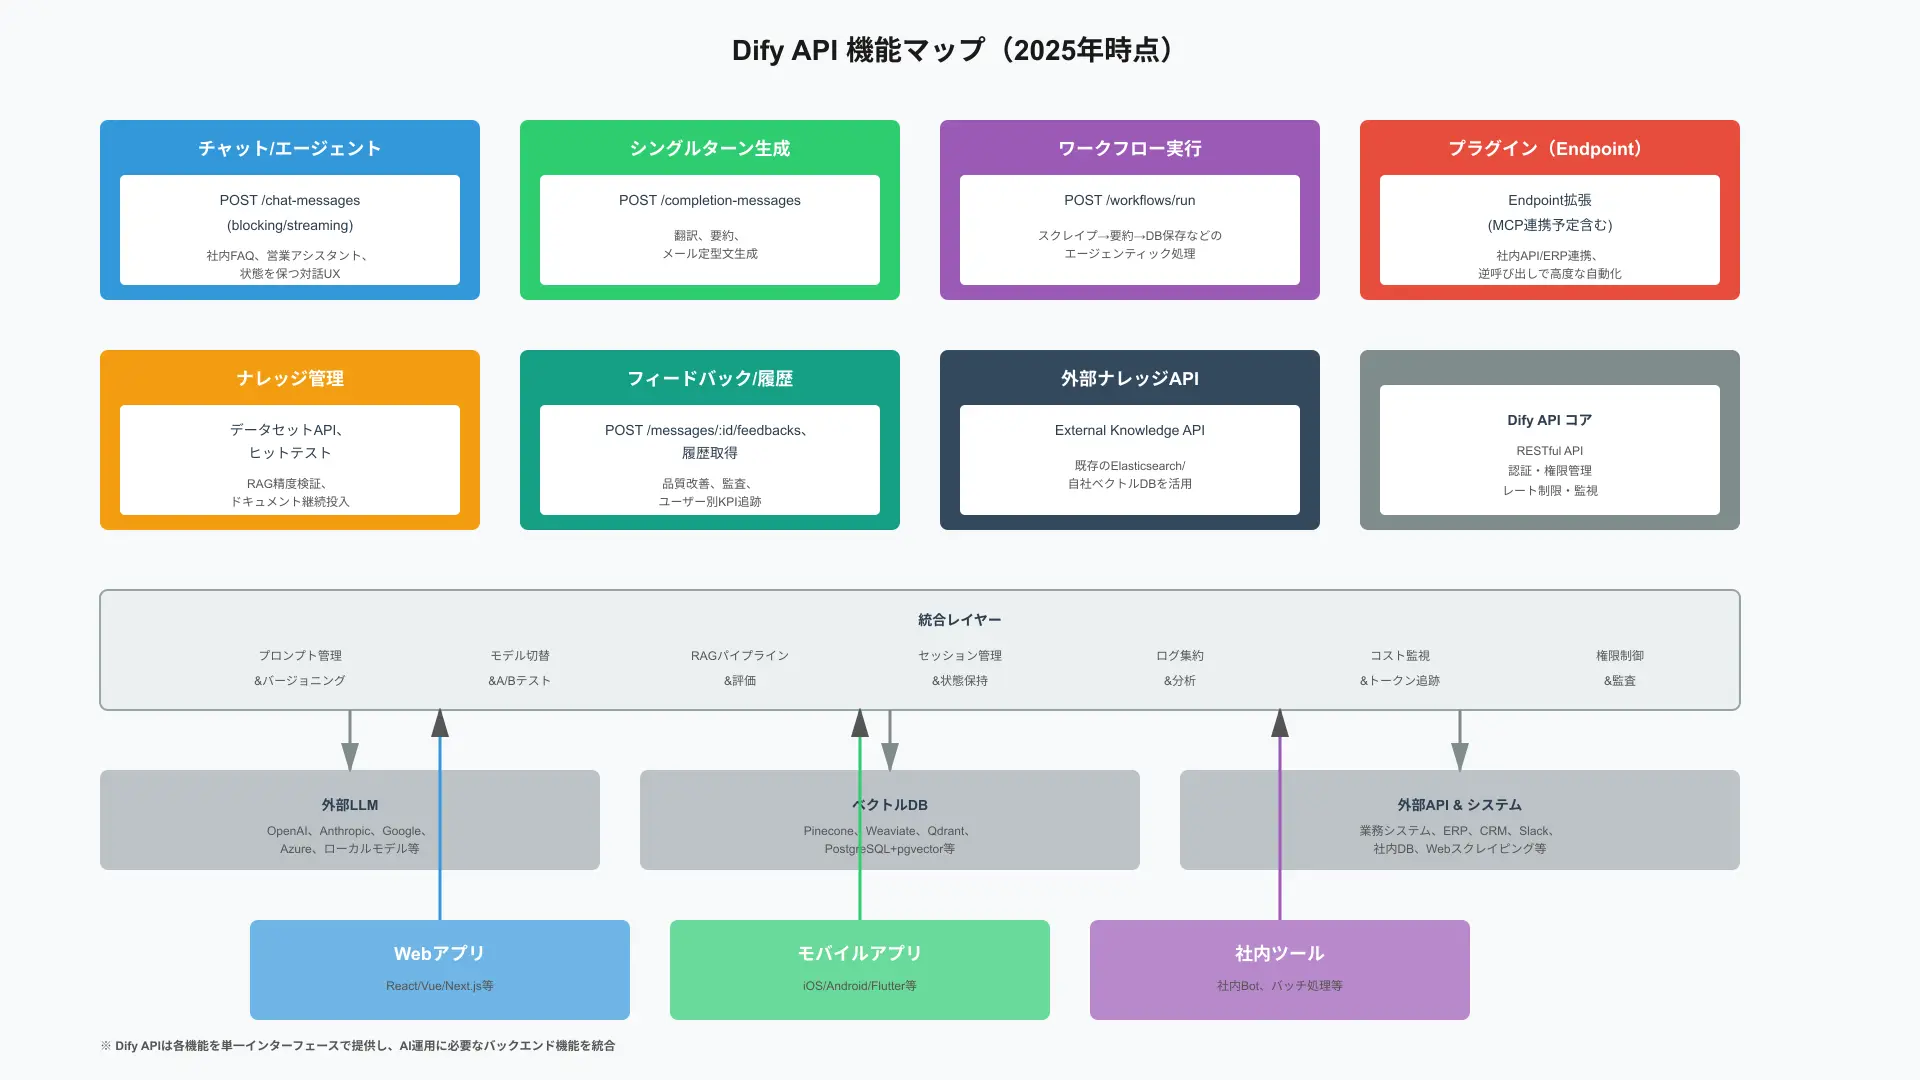
【2026年最新】Dify APIでできること一覧
対話型チャット、複雑なワークフロー実行、単一テキスト生成、ナレッジ管理まで多彩なAPIが提供されています。
マルチモーダルな画像・ファイル解析や、リアルタイムなServer-Sent Events(SSE)ストリーミングにも標準対応しています。
Webアプリ、モバイルアプリ、Slack等の社内ツールに対して、数行のHTTPリクエストを送るだけで高度な自律エージェント機能を接続できます。
OpenAI API等との役割分担:いつDifyを挟むべきか
シンプルな1問1答のテキスト処理であれば直接APIを叩く方が適しているケースもあります。
しかし社内文書のRAG検索や複数ステップの条件分岐を伴う場合は、Difyを仲介させることで開発生産性が劇的に向上します。
非エンジニアのPdMやドメイン専門家がプロンプト改善を直接担当できるため、エンジニアの開発工数をコア機能の実装へ集中させられます。
Dify APIの認証と基本リクエスト:まずは1エージェントを動かす
当セクションでは、Dify APIの認証方式とセキュアなリクエスト送信設計を解説します。
適切なキー管理とプロキシ構成を整えることで、本番運用の安全性を担保できるからです。
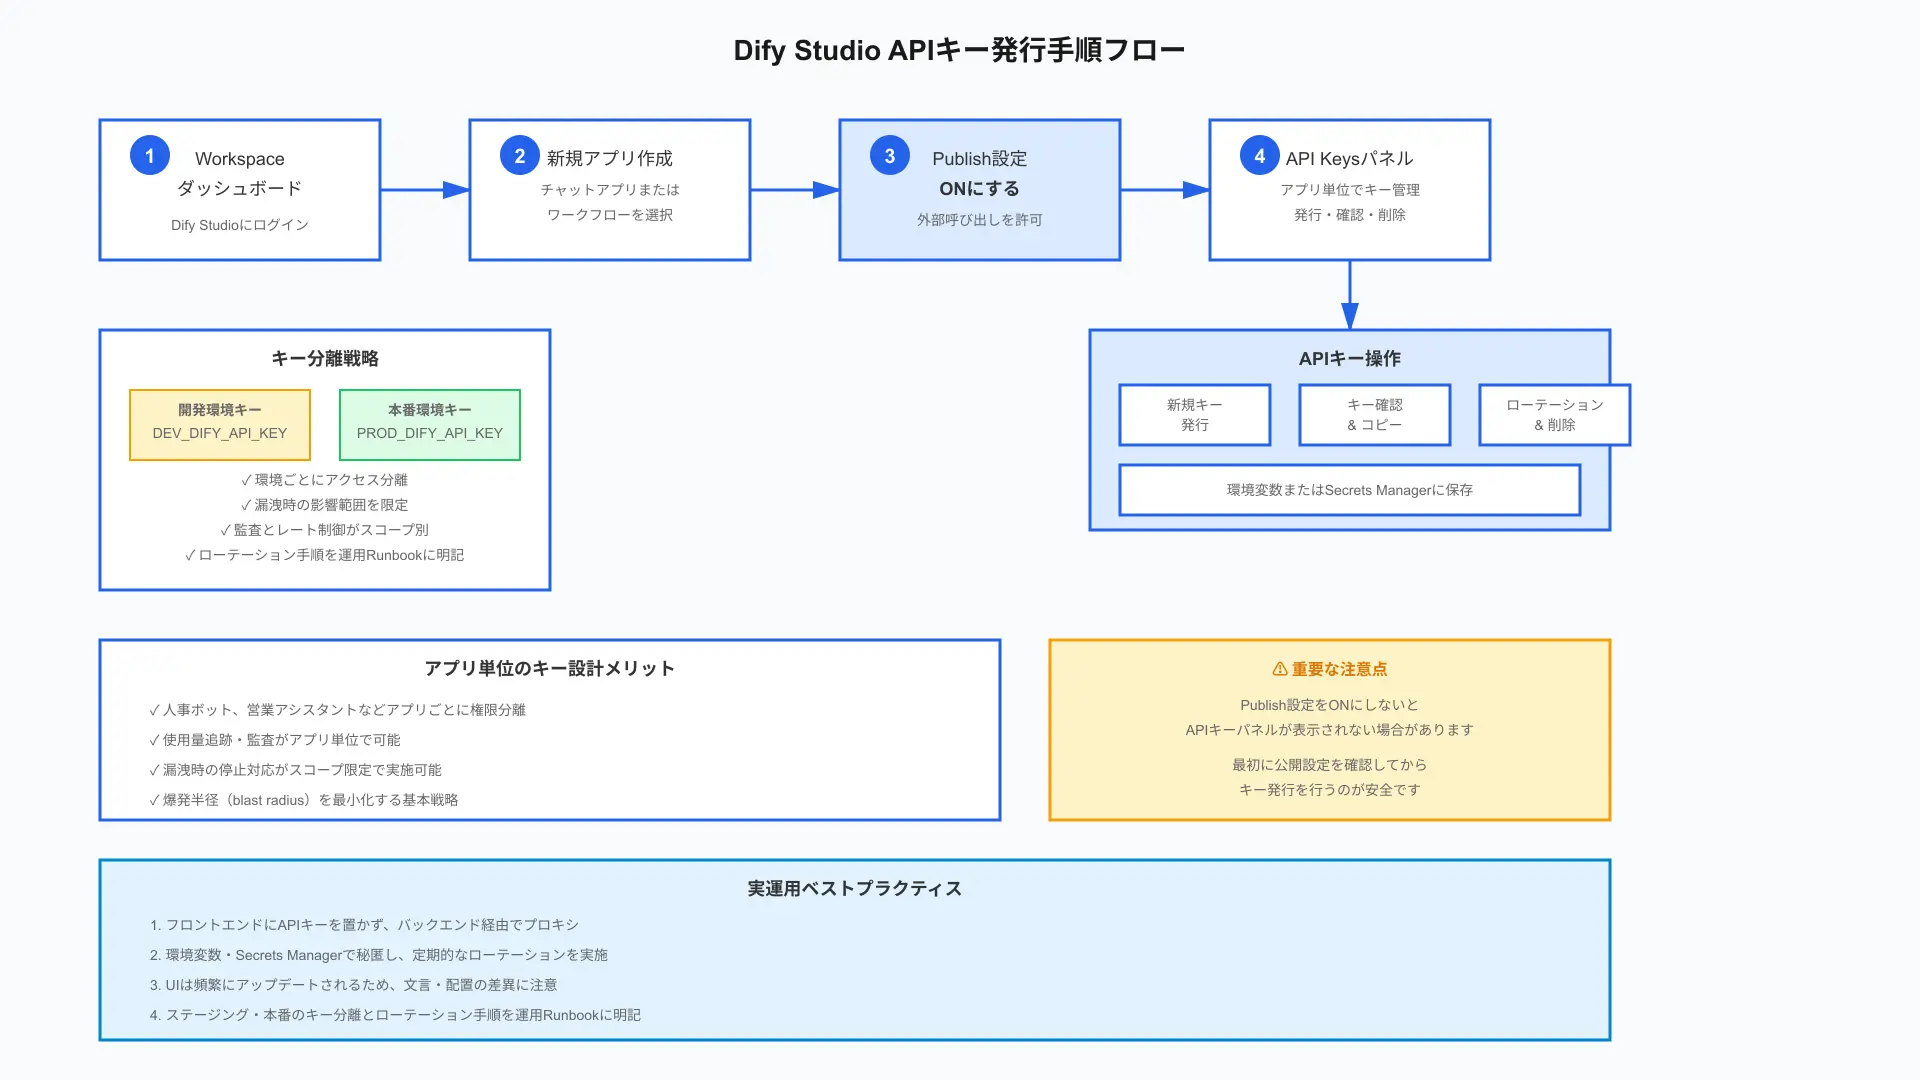
APIキーの種類と取得手順(アプリ単位のキー設計)
DifyのAPIキーはワークスペース全体ではなく、作成したアプリケーション単位で個別に発行されます。
アプリごとに権限やログが完全に独立しているため、不要になったキーの失効やローテーションも容易に行えます。
管理画面の「APIアクセス」からワンクリックでシークレットキーを発行し、環境変数経由で安全にバックエンドへ注入します。
認証ヘッダーと共通パラメータ設計
すべてのAPIリクエストはAuthorizationヘッダーに「Bearer {api_key}」を付与して送信します。
ブラウザのフロントエンドから直接Dify APIを叩くとキーが漏洩するため、必ず自社バックエンドをプロキシとして挟みます。
Next.jsのAPI RoutesやFastAPI等を経由させることで、ユーザー認証とレートリミットを自社側で厳格に制御できます。
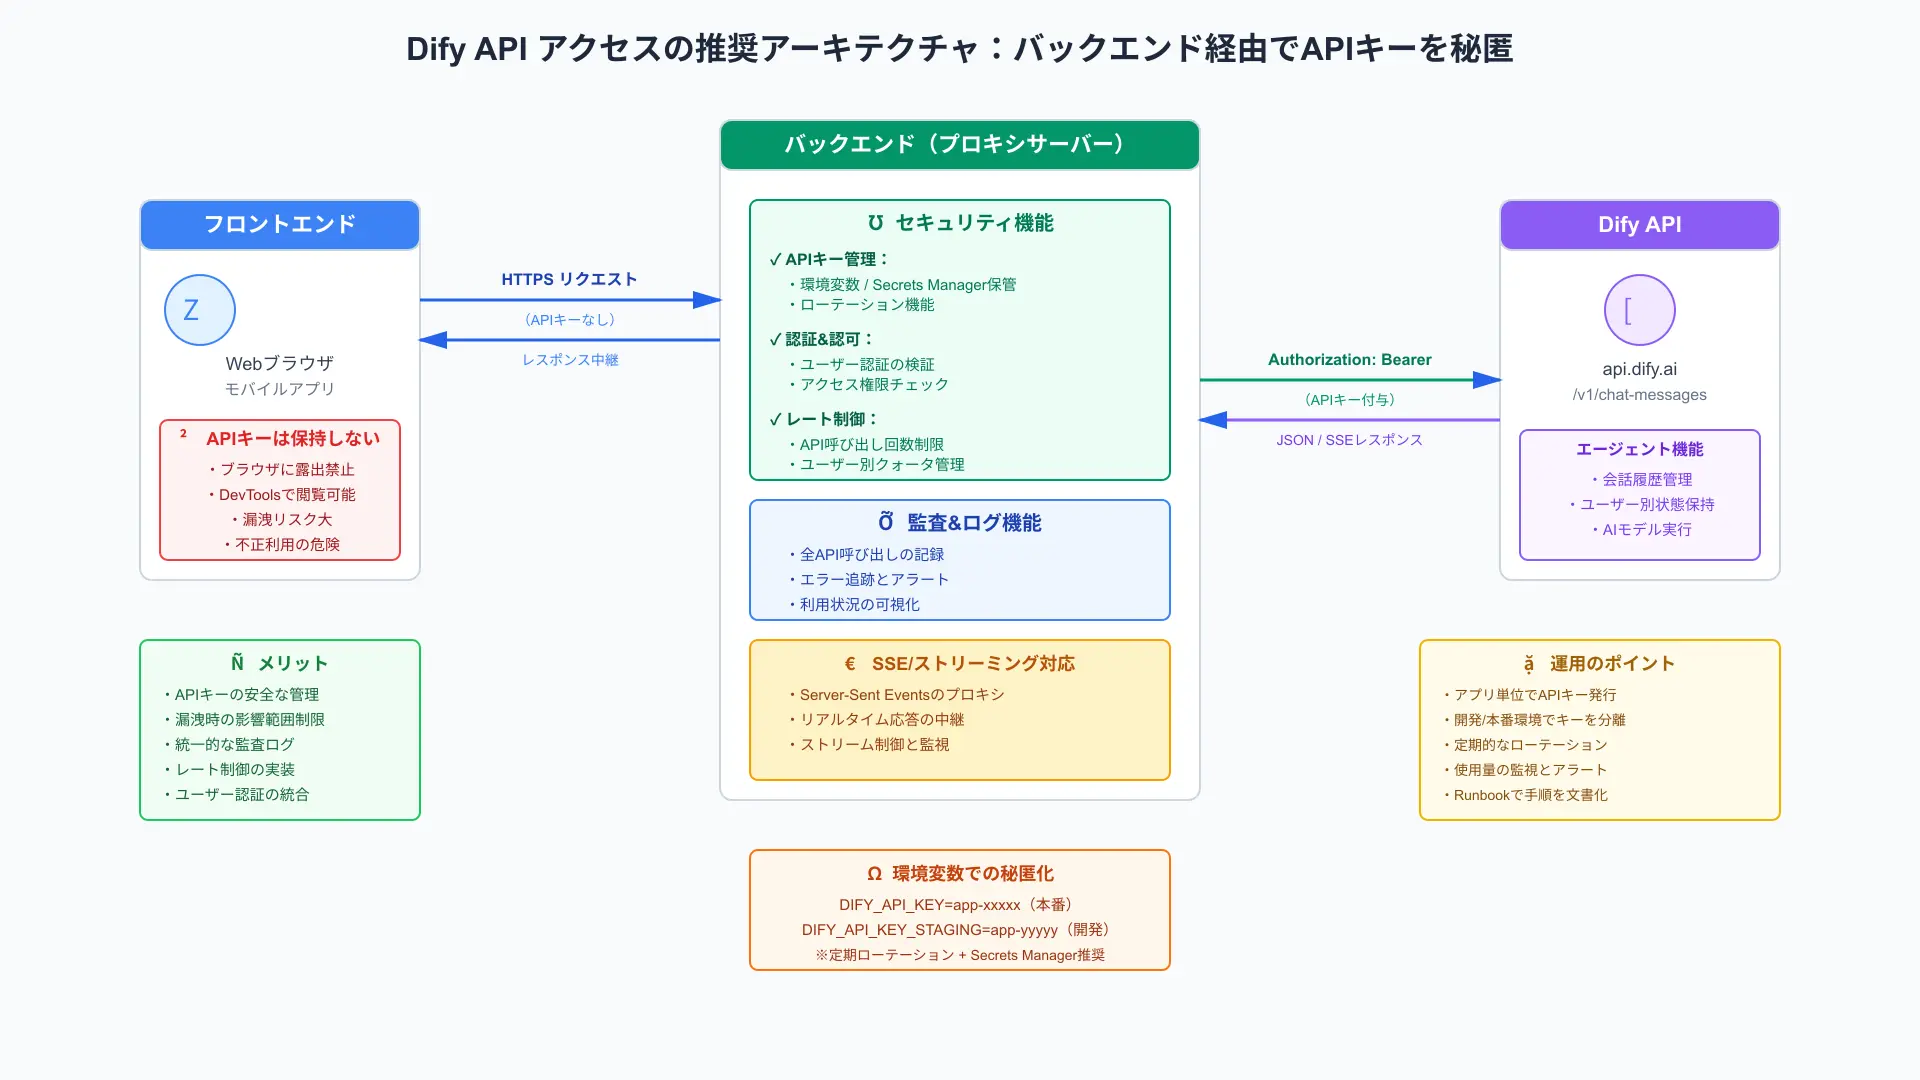
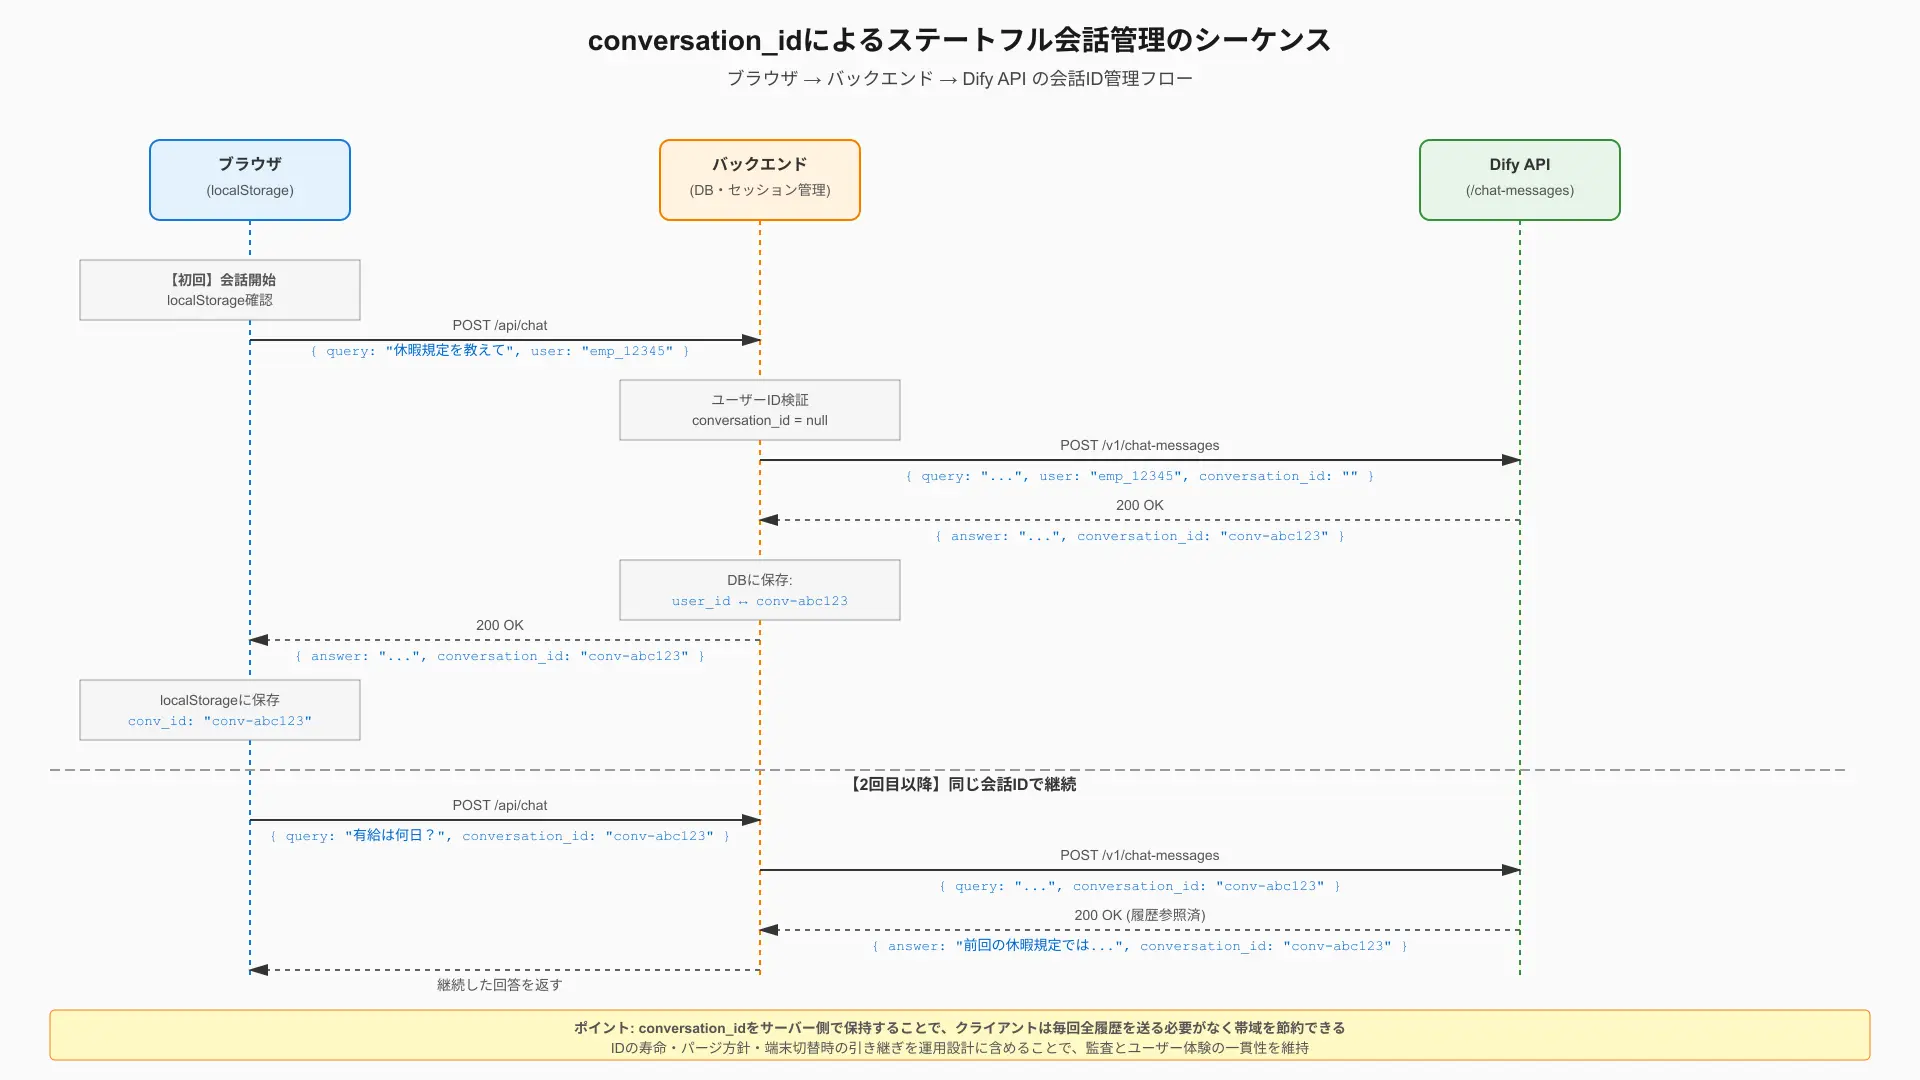
ステートフルな会話管理:conversation_idの考え方
チャット対話のコンテキストを維持するために、初回リクエスト時は空文字を送り、レスポンスで返却されたconversation_idを保持します。
2回目以降のリクエストに同IDを含めるだけで、Dify側が過去の会話履歴を自動でプロンプトに結合して推論します。
クライアント側で膨大な会話履歴配列を保持・送信する手間がなくなり、ネットワーク転送量とフロントエンドの実装負荷を大幅に軽減できます。
チャットボット・エージェントを叩く:/chat-messages の実践
当セクションでは、対話型アプリの基幹となる/chat-messagesエンドポイントの実装を解説します。
リクエスト構造とストリーミング処理をマスターすることで、快適なチャットUIを構築できるからです。
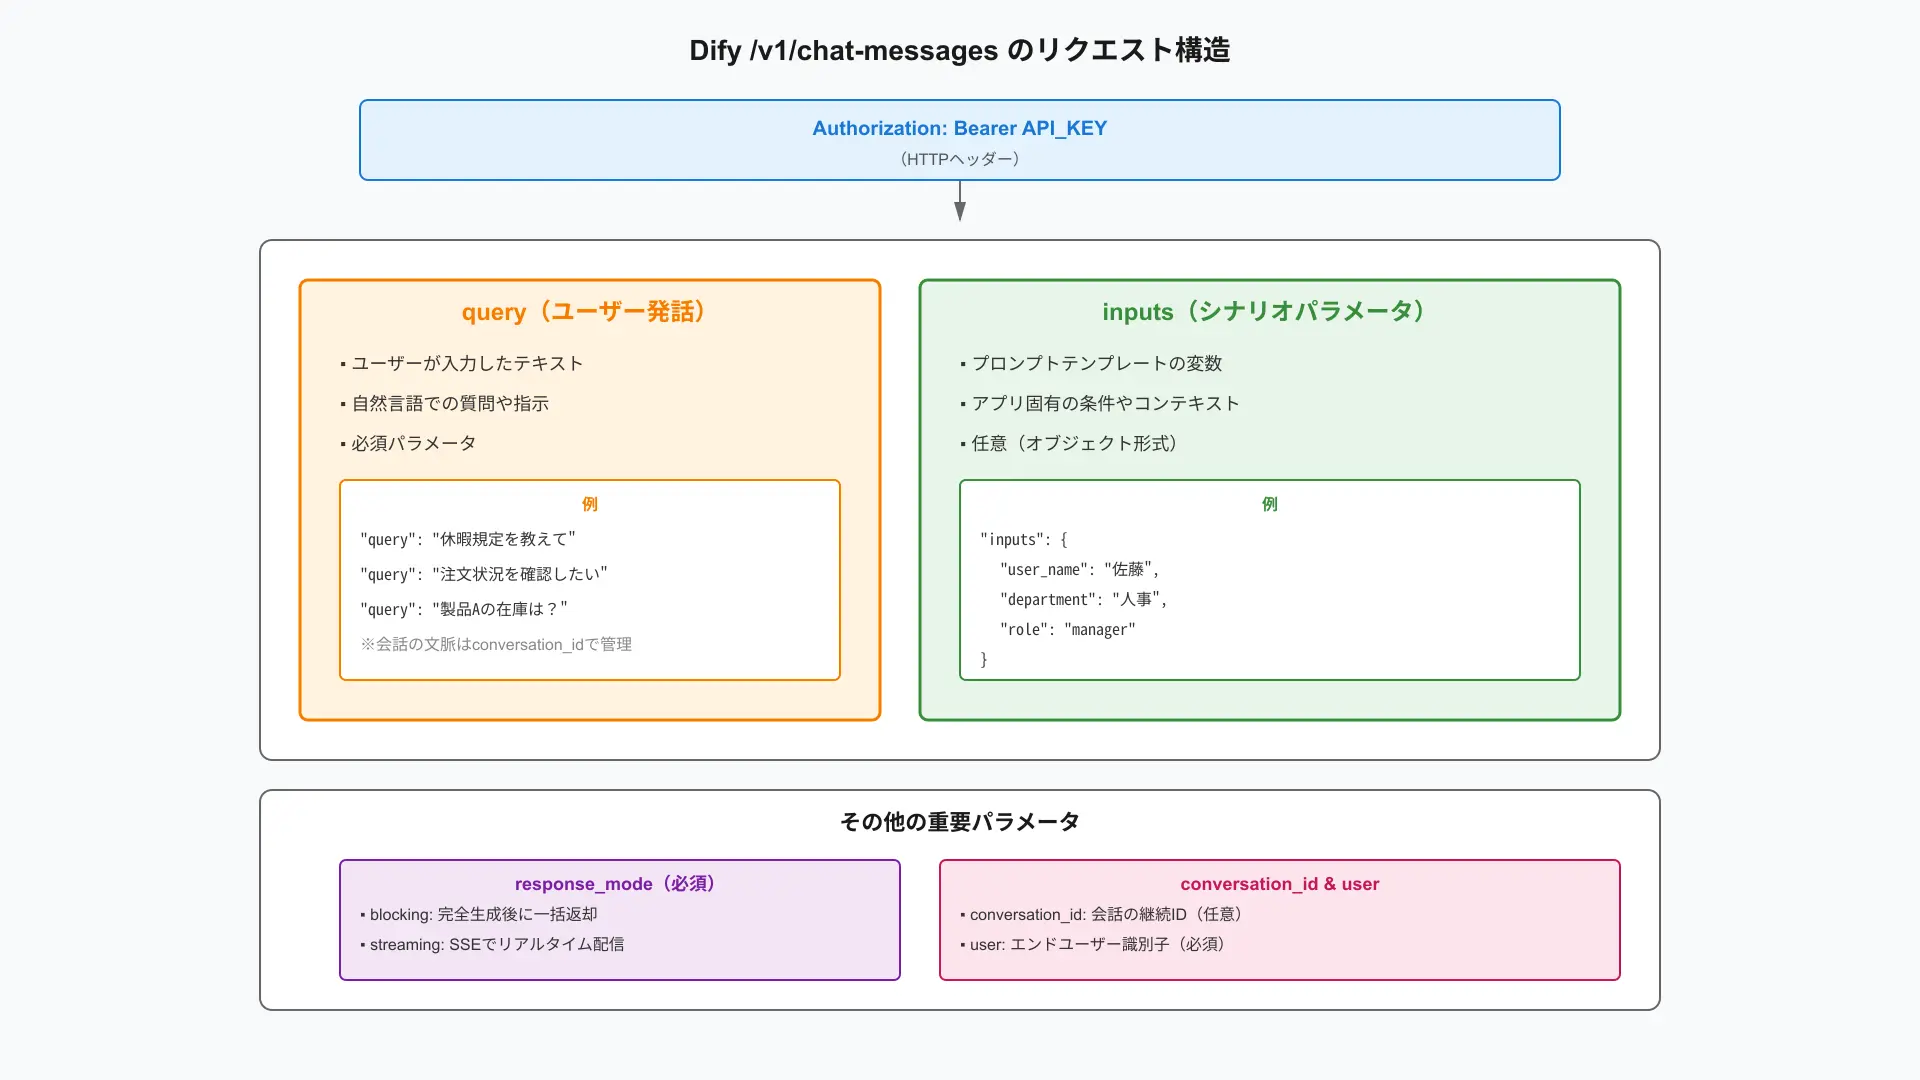
/chat-messagesエンドポイントの基本構造
リクエストボディにはquery(ユーザー入力文)、inputs(変数のマップ)、user(エンドユーザー識別子)を指定します。
アプリ側で定義した変数(ユーザー属性や参照ドキュメントID等)をinputs経由で柔軟に注入可能です。
定型的なJSON形式で送信するだけで、設定済みのプロンプトテンプレートやRAG検索が自動適用された回答が得られます。
ストリーミングレスポンス(SSE)の扱いとUX設計
response_modeに「streaming」を指定することで、Server-Sent Events形式でテキストが順次配信されます。
生成中の思考プロセスや検索ノードの進行状況もイベントとしてリアルタイムに受信できます。
ユーザーの体感待ち時間(TTFT: Time To First Token)を最小化し、ChatGPTライクな滑らかなタイピング演出UIを簡単に実装可能です。
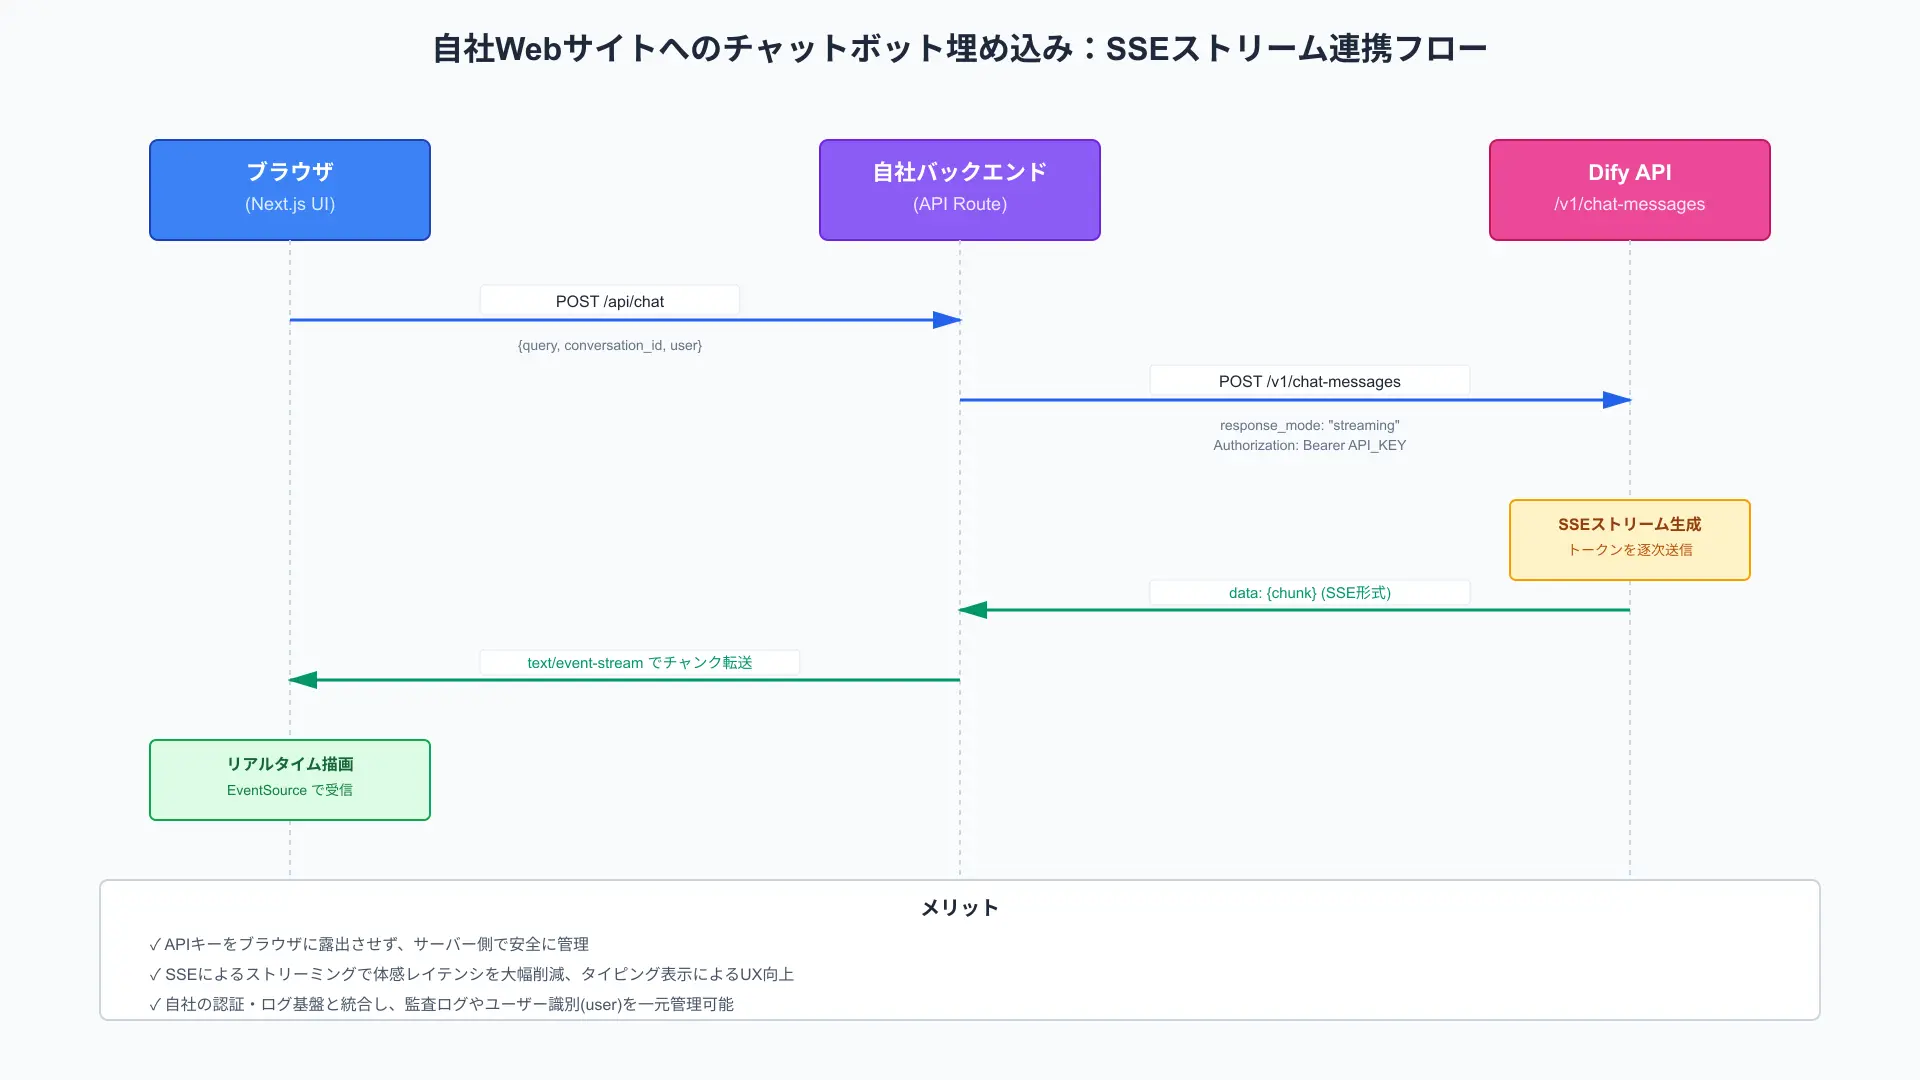
自社Webサイトにチャットボットを埋め込むAPI連携パターン
Difyにはiframe埋め込みタグも用意されていますが、API連携を用いれば自社のデザインシステムに完全統合できます。
ログイン中の会員情報や閲覧中ページのURLをinputsへ自動で引き渡す高度なパーソナライズも容易です。
ブランドイメージを損なうことなく、コンバージョン導線と完全に連動した高性能なAIチャットUIを展開できます。
ワークフロー実行:/workflows/run でエージェンティックな処理を呼び出す
当セクションでは、複雑な業務フローをAPIから実行する/workflows/runエンドポイントを解説します。
ノードベースの高度な自動化ロジックをプログラムから自在に呼び出せるようになるからです。
Workflow APIの役割とチャットAPIとの違い
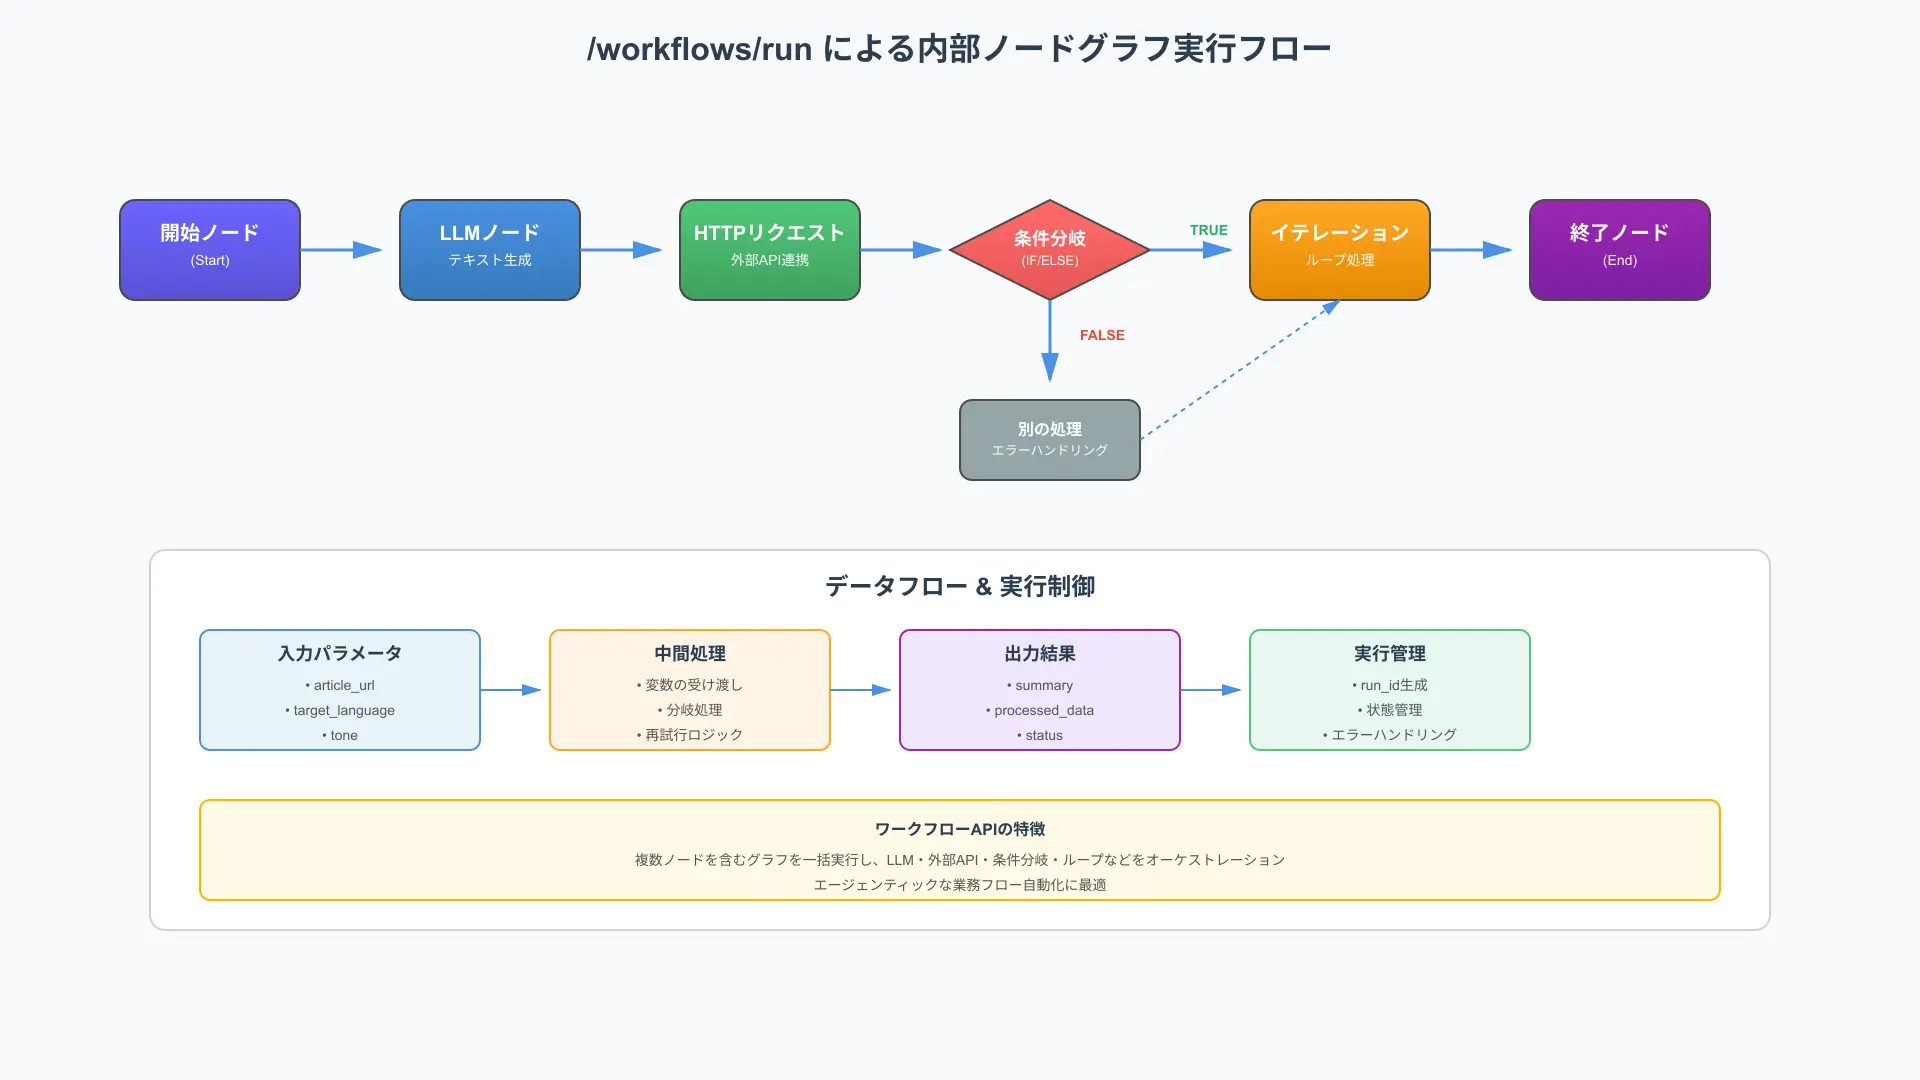
チャットAPIが対話セッションを主眼とするのに対し、Workflow APIは入力に対する一連の処理実行と結果出力を担います。
LLM呼び出し、Pythonコード実行、外部API連携、条件分岐ノードが直列または並列で実行されます。
複雑なバックエンド処理全体を1つのAPIエンドポイントとして抽象化し、マイクロサービスのAI処理エンジンとして強力に機能します。
/workflows/run のリクエスト設計とinputsのマッピング
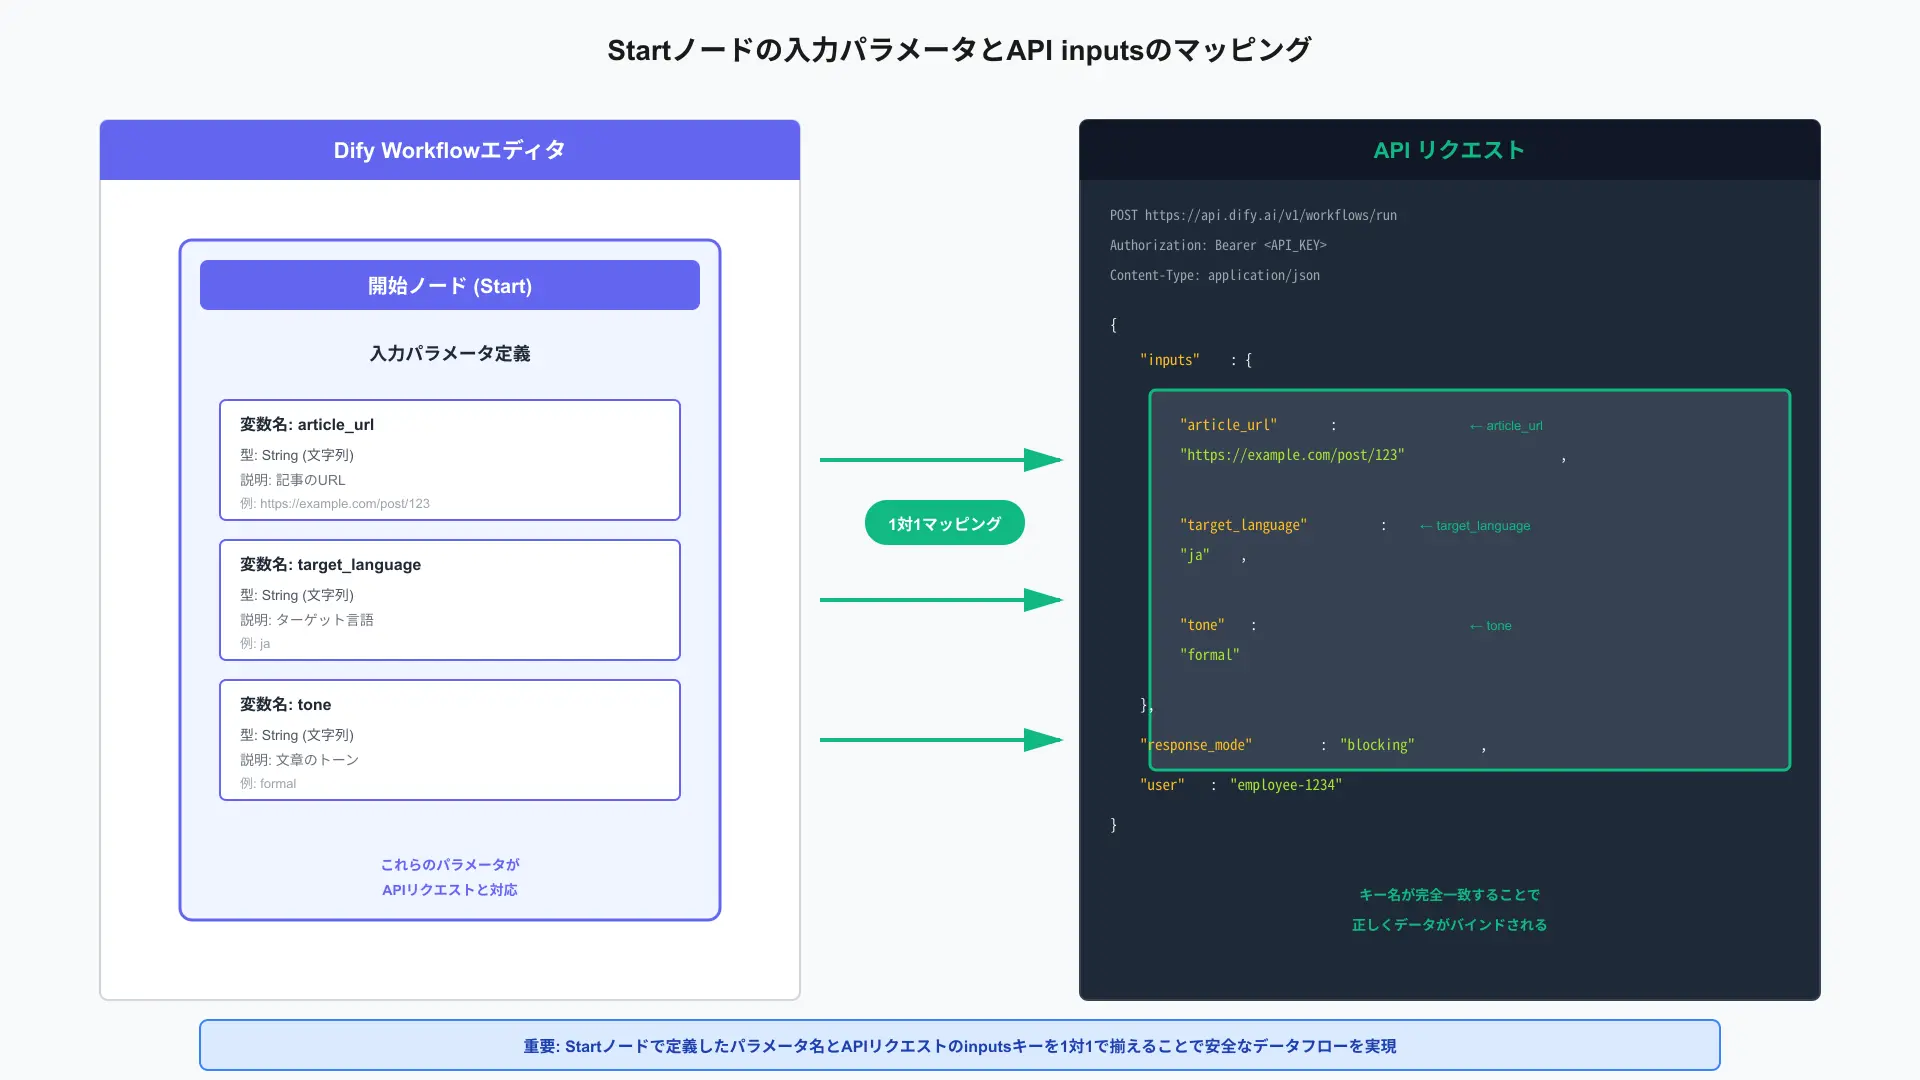
ワークフロー開始ノードで定義した入力フィールド名に合わせて、JSONのinputsオブジェクトを組み立てて送信します。
文字列、数値、配列、さらにはアップロードされたファイルオブジェクトまで多彩なデータ型を受け渡せます。
実行完了時にはすべての出力ノードで定義されたデータが構造化JSONとして返却され、自社システム側の後続処理へシームレスに連携できます。
長時間実行ワークフローへの対応:タイムアウトと非同期化のコツ
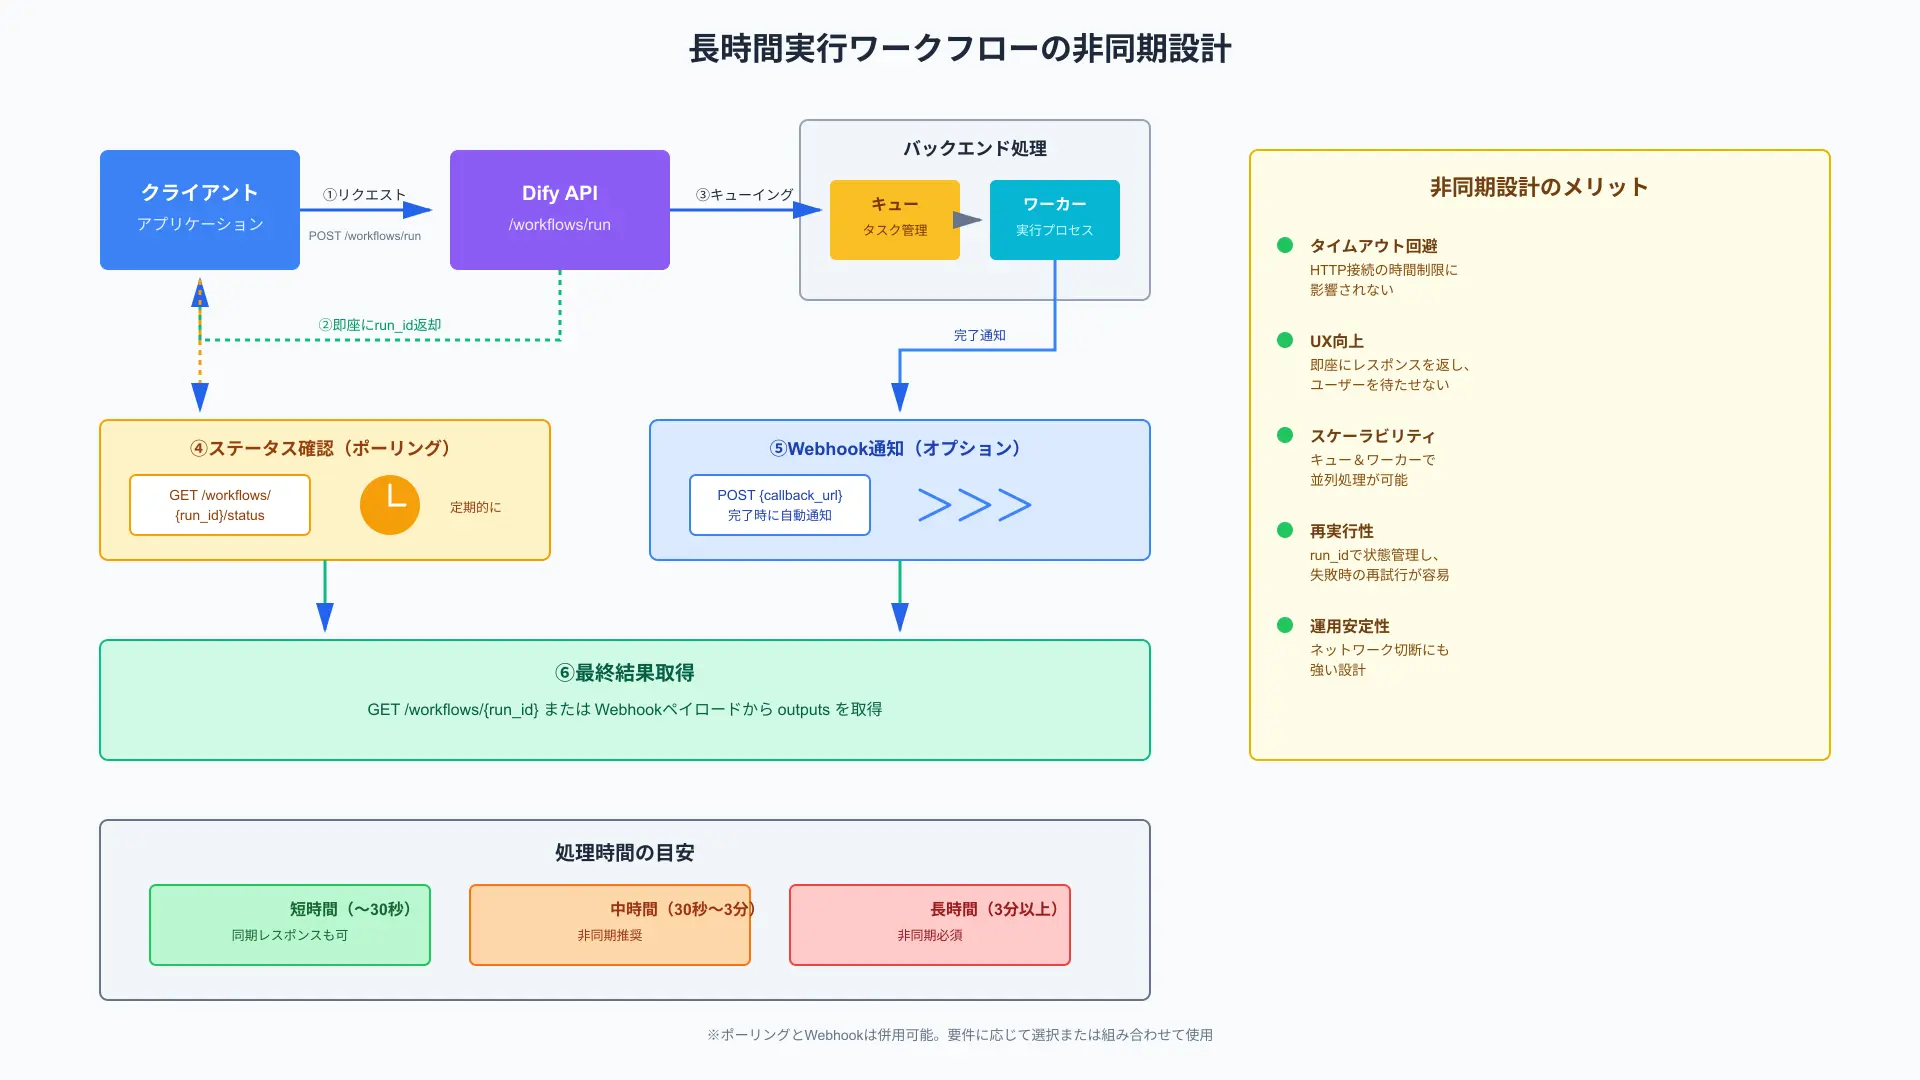
大量データのバッチ処理やWebクローリングを含むワークフローでは、HTTPタイムアウトへの対策が不可欠です。
ストリーミングモードでノード単位の進捗ログを購読するか、キューイングシステムと組み合わせてポーリングを行います。
非同期アーキテクチャを導入することで、数分以上を要する重厚なエージェント処理も安定して実行できます。
シングルターン生成とユーティリティ用途:/completion-messages の使いどころ
当セクションでは、単発のテキスト処理に特化した/completion-messagesエンドポイントを解説します。
対話履歴を必要としない軽量タスクにおいて、最も効率的なリクエスト構造を選択できるからです。
/completion-messagesでできることとチャットとの違い
対話セッションを保持せず、渡されたプロンプトと入力変数に対して1回の推論結果を返します。
記事のタイトル生成、要約、翻訳、感情分析など、完結したタスクの実行に最も適しています。
無駄な履歴管理オーバーヘッドが発生しないため、極めてシンプルかつ高速なテキスト処理APIとして運用可能です。
バックエンドバッチ処理・マイクロサービスとしての活用例
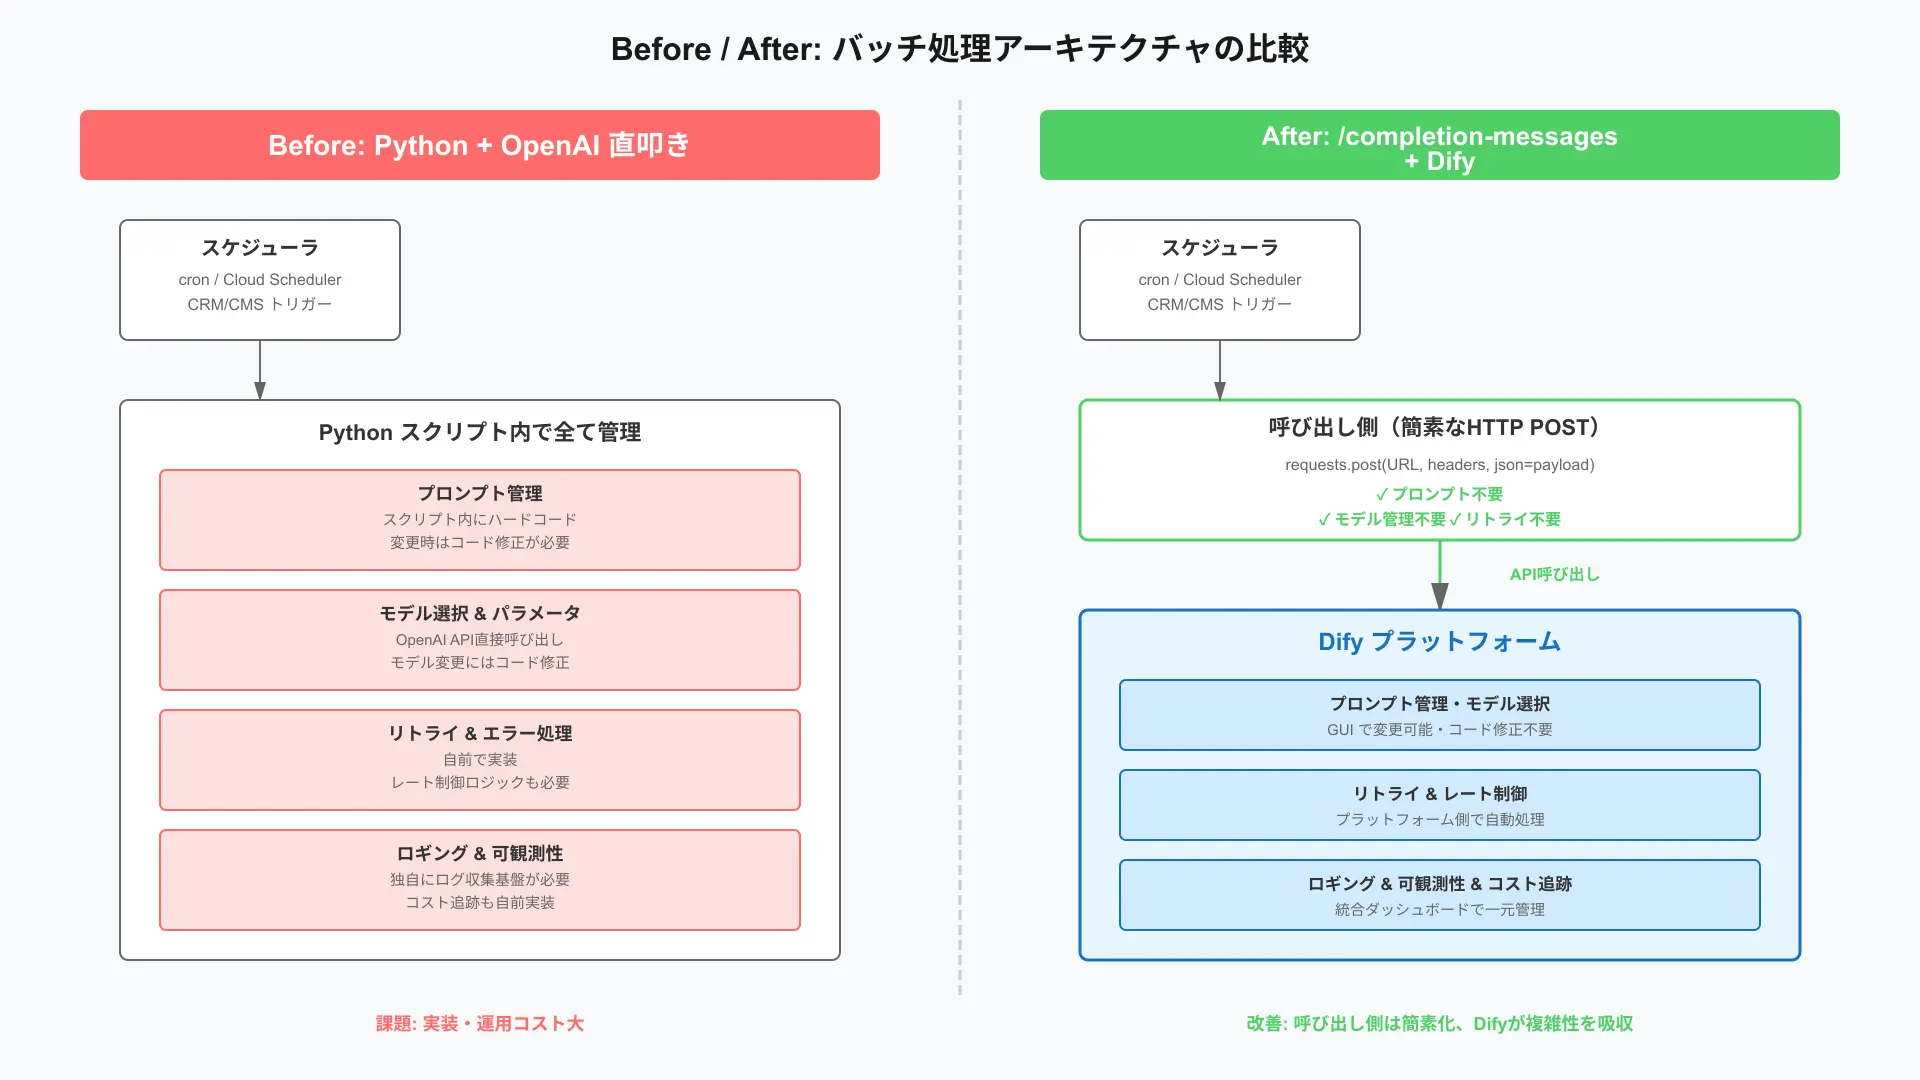
夜間のデータベース定期更新や、ユーザー投稿コンテンツの自動タグ付けバッチ等に組み込まれます。
キューワーカーから並列でエンドポイントを呼び出すことで、大量のテキストデータを一括処理できます。
自社製マイクロサービスの1つとしてDifyを常駐させ、社内全体のAIテキスト処理基盤を統一できます。
ナレッジベースとRAG:データセットAPI・外部ナレッジAPIの実務
当セクションでは、社内文書を検索・参照させるデータセットAPIと外部ナレッジ連携を解説します。
ドキュメントの登録から検索テストまでをAPI経由で自動化し、鮮度の高いRAG環境を維持できるからです。
DifyのナレッジベースとRAGパイプラインの仕組み
アップロードされたドキュメントは自動でチャンク分割・埋め込み(Embedding)され、ベクトルDBへ格納されます。
キーワード検索(BM25)とベクトル検索を組み合わせたハイブリッド検索や、リランキングモデルも標準で動作します。
複雑なRAGインフラを自前で構築することなく、最高水準の検索精度を持つナレッジ参照基盤を即座に利用できます。
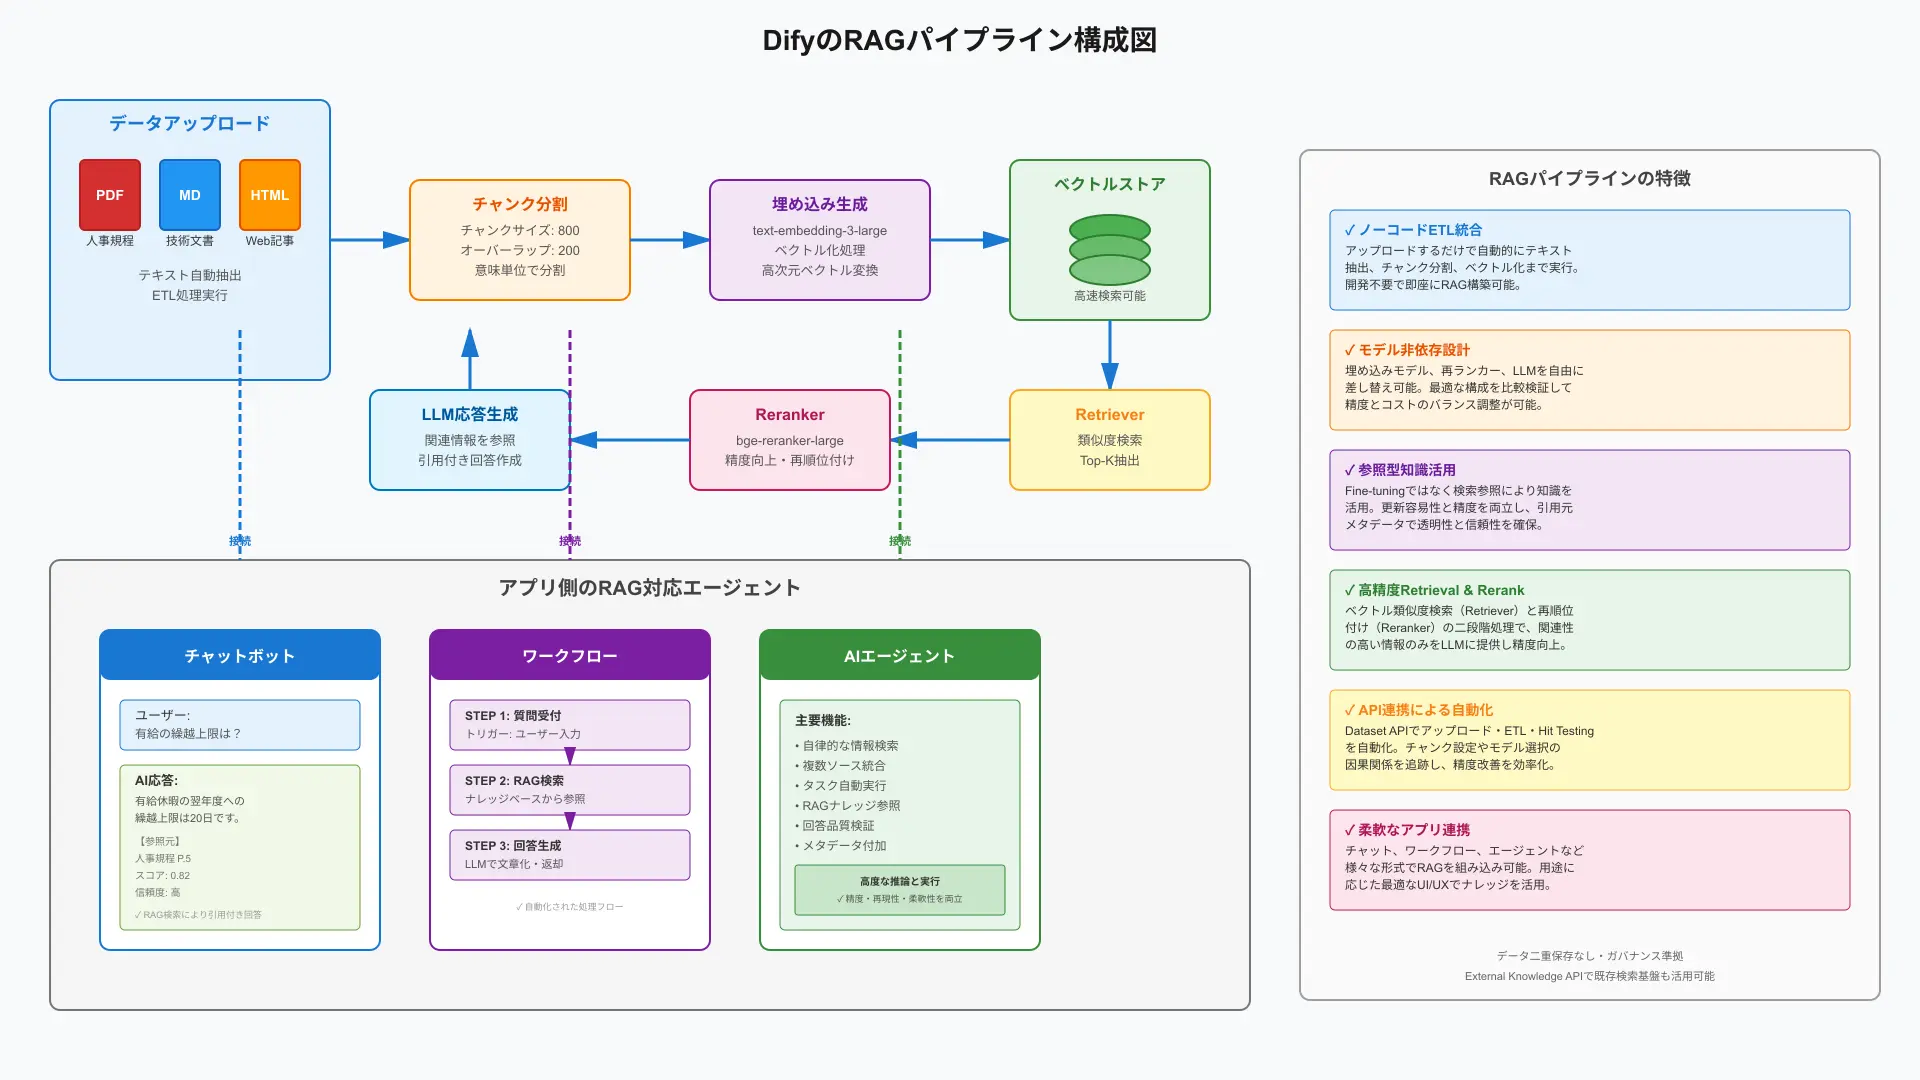
APIでデータセットを管理する:アップロードとヒットテスト
データセットAPIを使用すれば、社内のNotionやGoogle Drive、S3上の最新文書をプログラムから自動同期できます。
ヒットテストAPIにより、特定のクエリに対してどのドキュメントチャンクがマッチするかを事前に検証可能です。
定期的なドキュメント同期バッチを組むことで、常に最新の社内規定や商品情報に基づく正確なAI回答を担保できます。
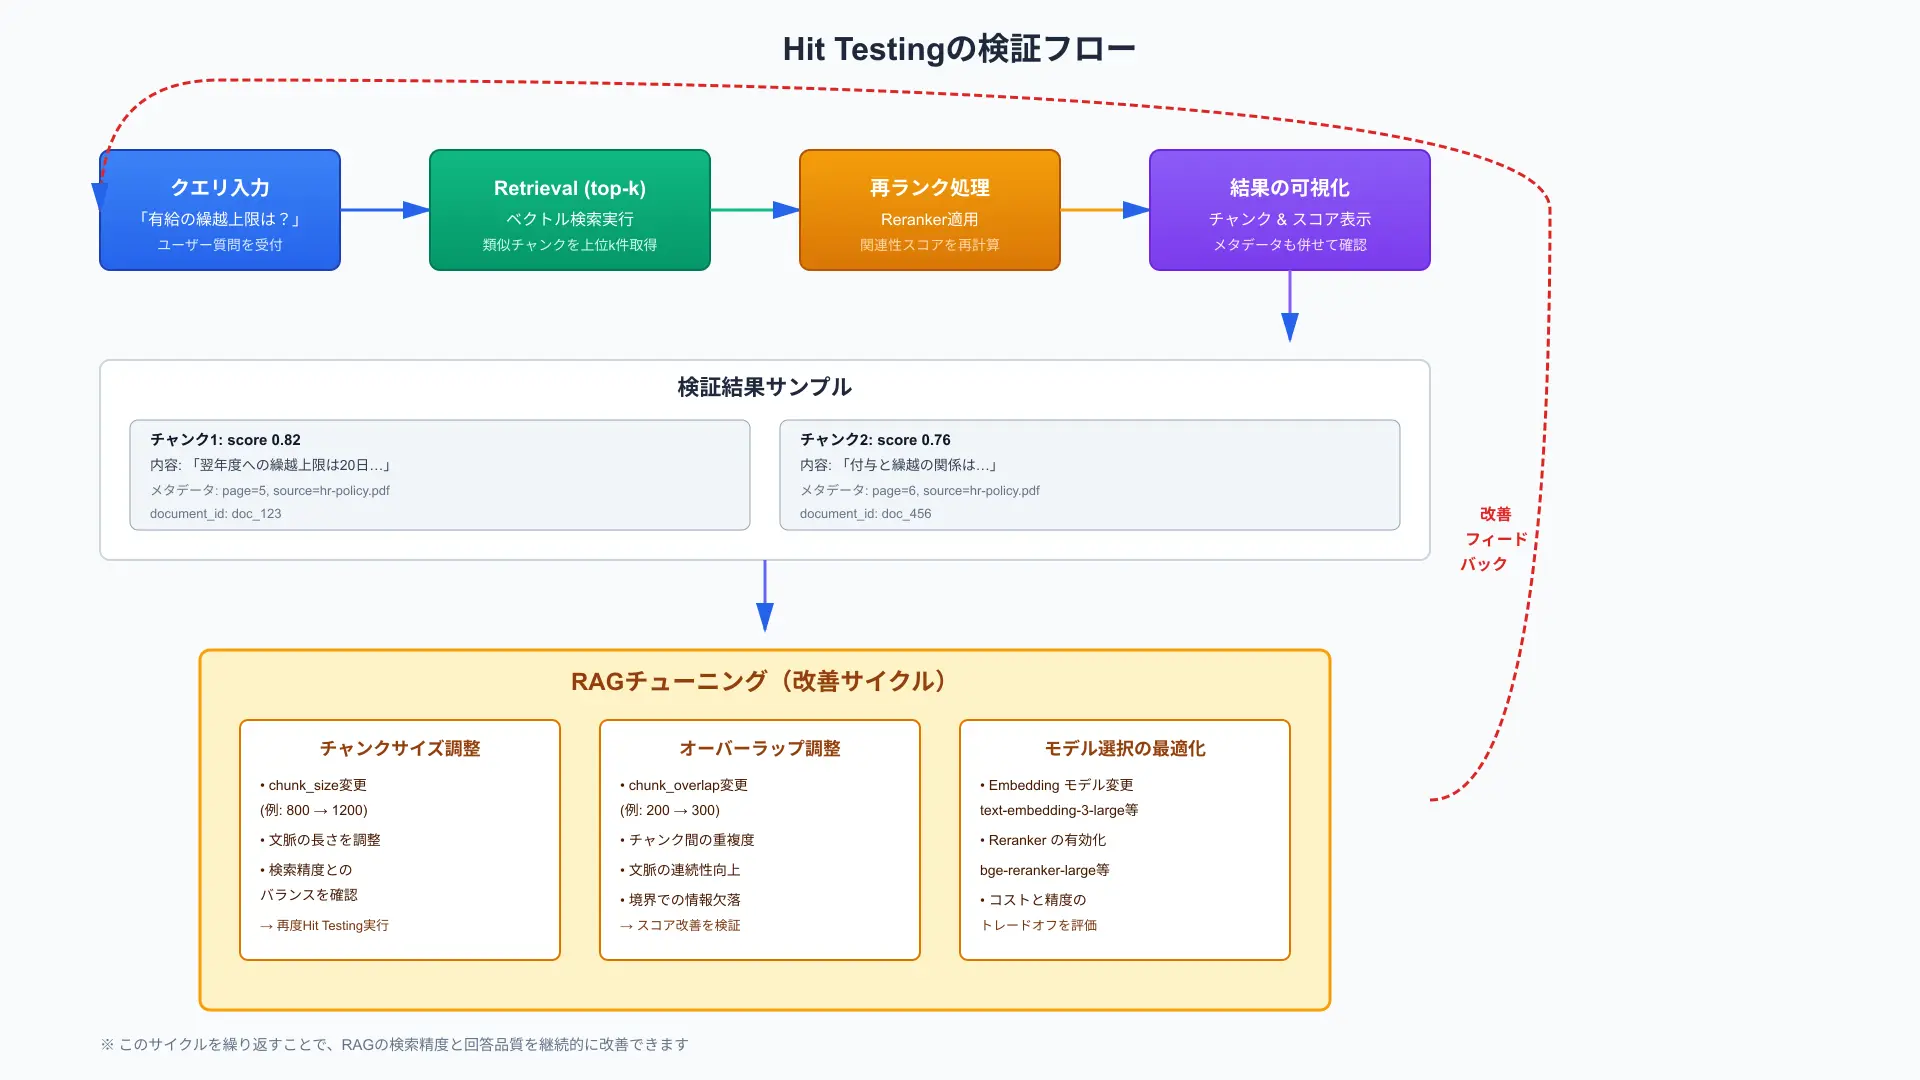
既存の検索基盤を活かす:External Knowledge APIの使いどころ
すでに自社でElasticsearchやAzure AI Searchを運用している場合は、External Knowledge APIを活用します。
Dify側のナレッジにデータを再登録することなく、既存検索エンジンのAPIエンドポイントを直接DifyのRAGノードとして接続できます。
既存のエンタープライズ検索資産をそのまま継承し、二重管理コストをゼロにした理想的なナレッジ統合が実現します。
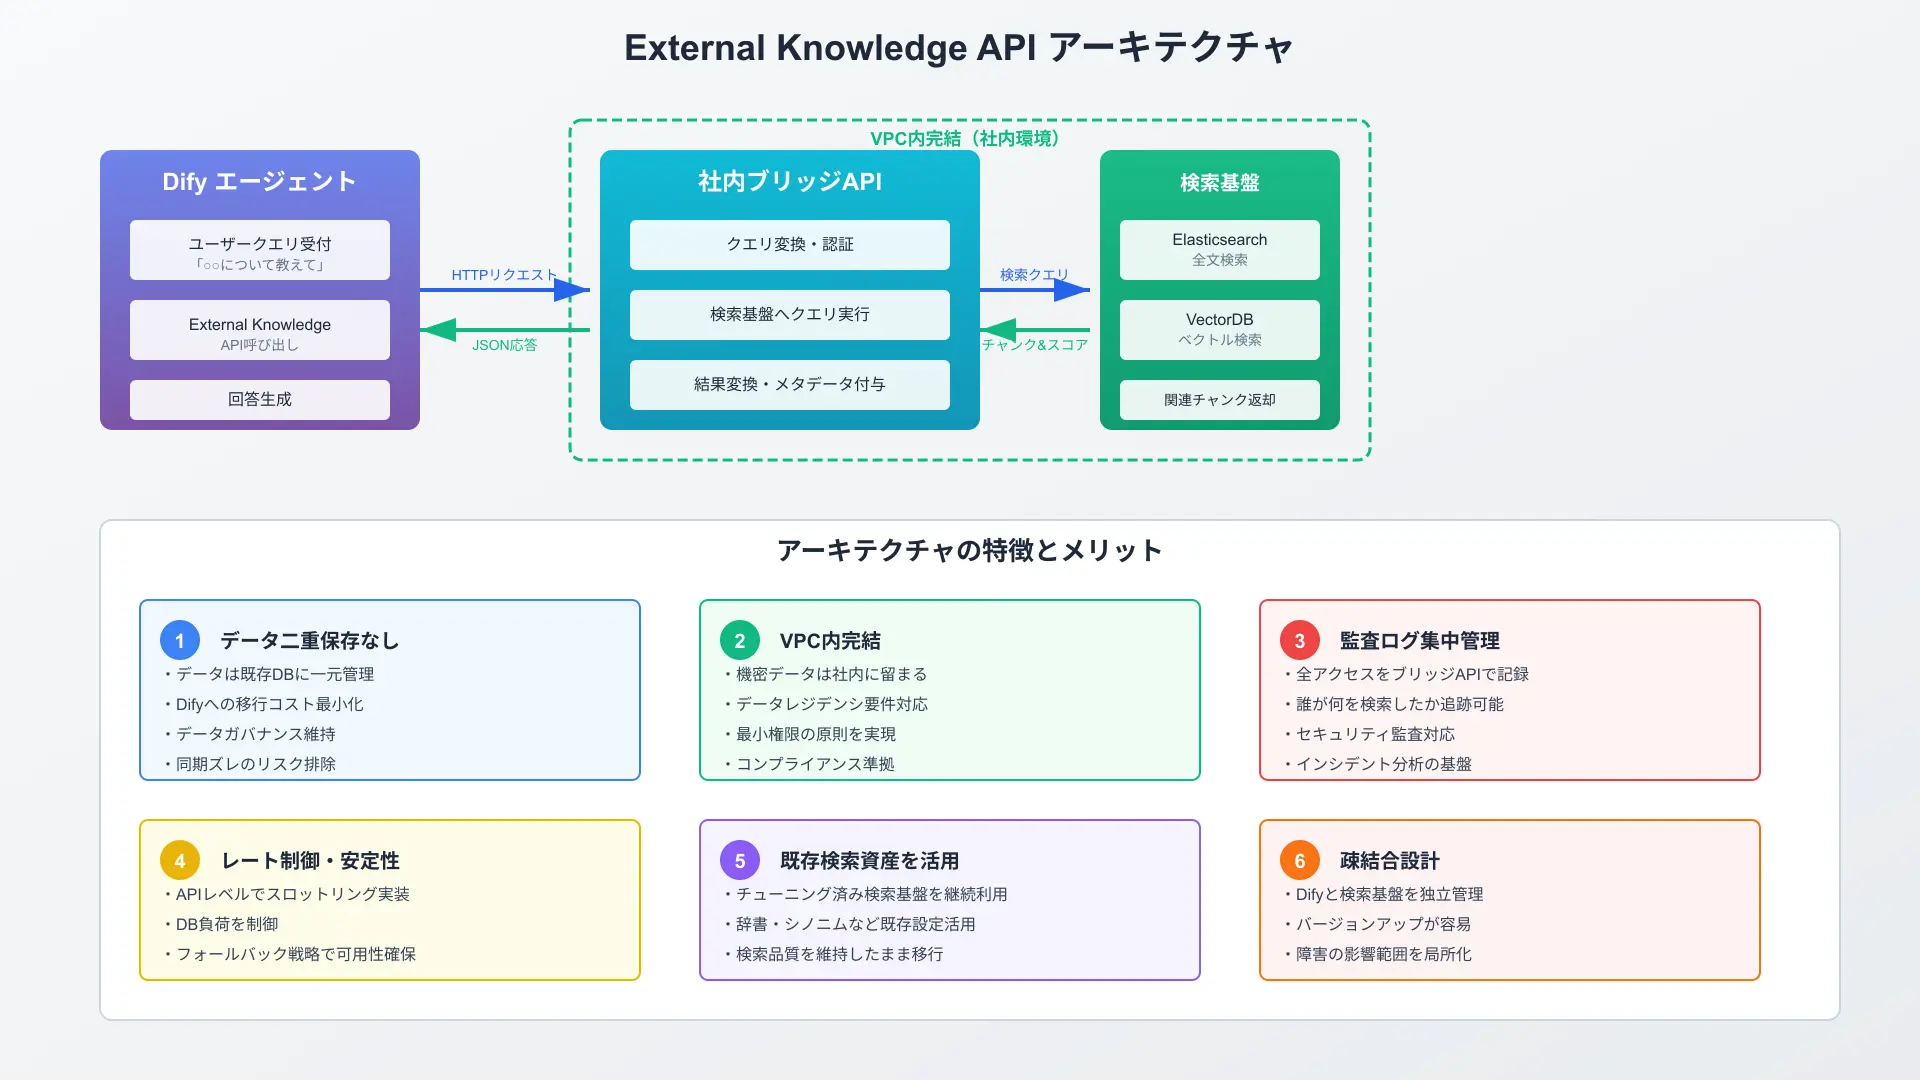
運用・LLMOpsの視点:ログ、フィードバック、エラー処理とセキュリティ
当セクションでは、本番運用に欠かせないログ分析、フィードバックループ、エラー監視を解説します。
継続的な品質改善と堅牢なセキュリティ体制を確立することで、トラブルのない安定運用を続けられるからです。
ログとフィードバックAPIで継続改善する
エンドユーザーからのGood/Bad評価やテキストコメントをフィードバックAPI経由でDifyへ送信できます。
低評価のついた対話ログを管理画面で即座に抽出し、プロンプトやナレッジの改善へフィードバック可能です。
実運用のデータを定量的にモニタリングすることで、ユーザー満足度を高める継続的なプロンプト改善サイクルが定着します。
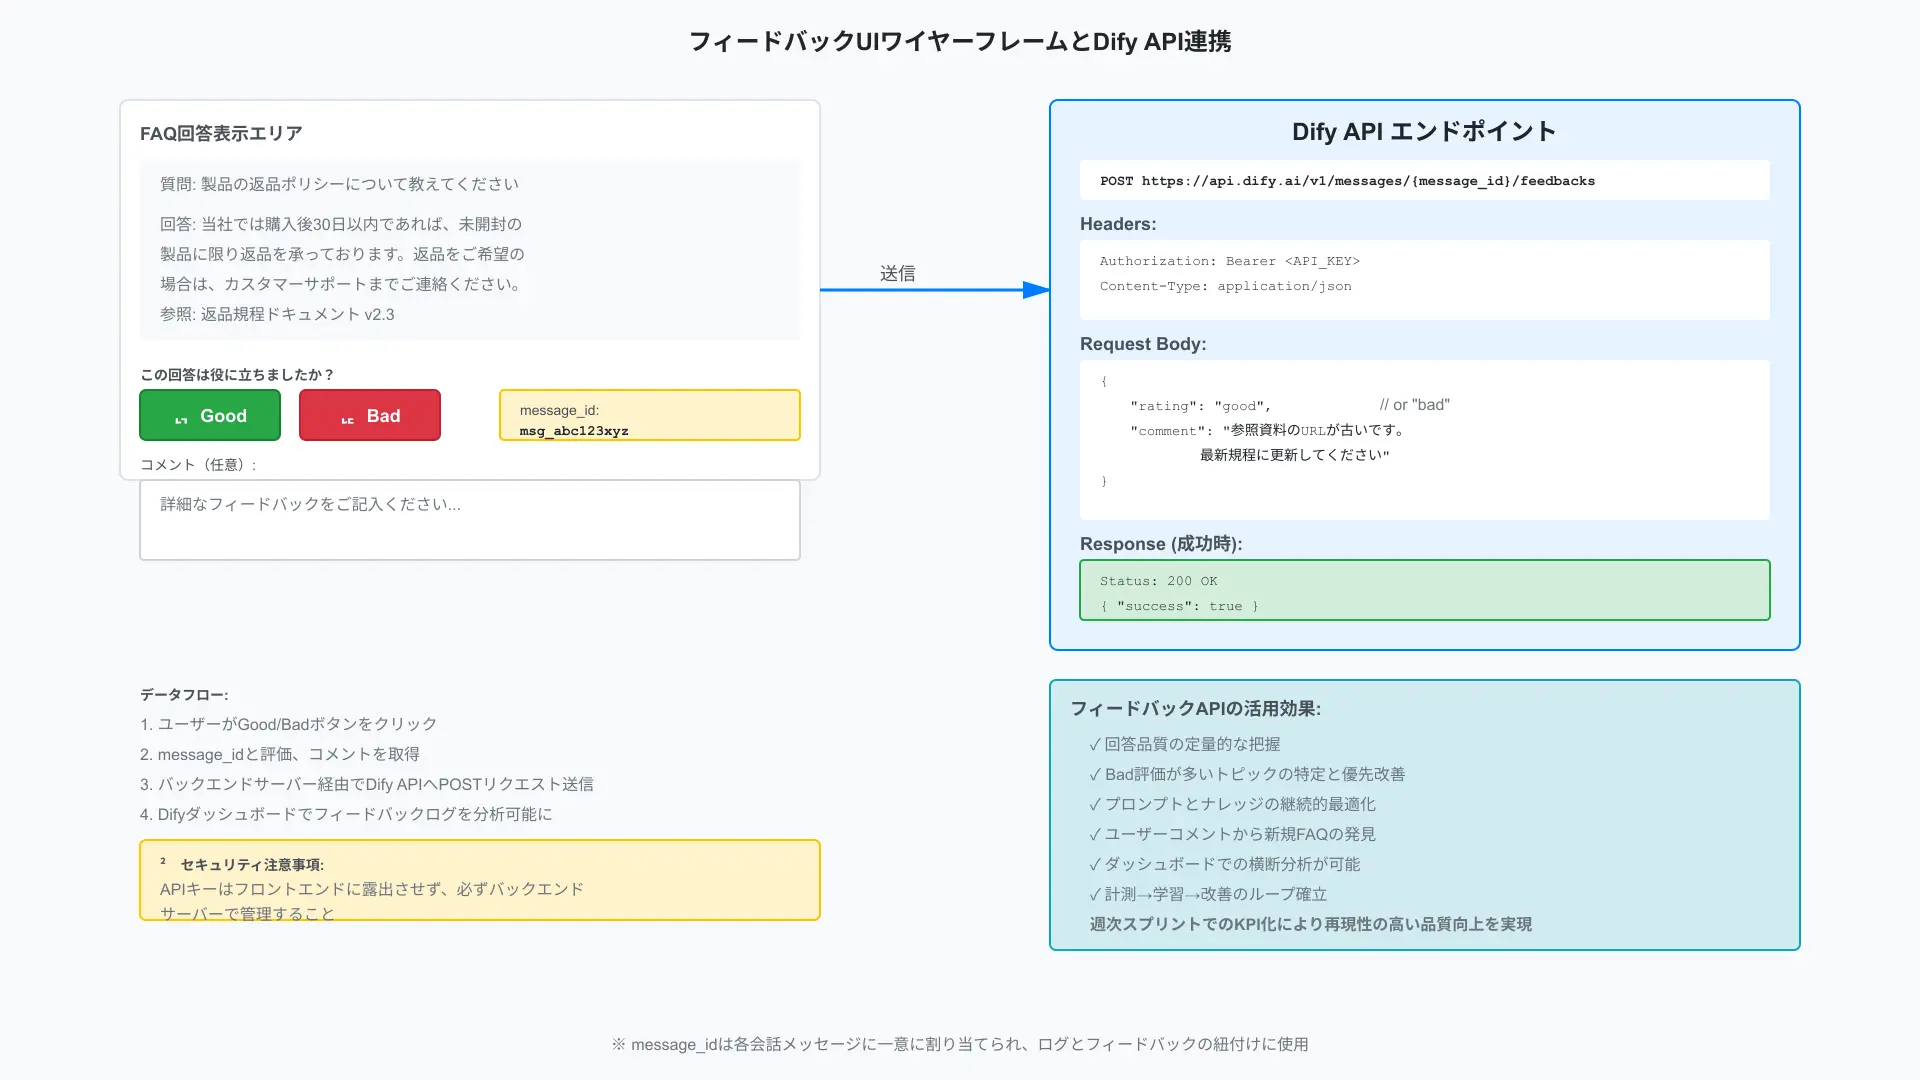
典型的なエラーとハンドリングパターン
プロバイダー側のレートリミット(429)やコンテキスト長超過、タイムアウト(504)に対する再試行設計を施します。
指数バックオフによる自動リトライや、エラー発生時のフォールバック応答をバックエンド側で定義します。
予期せぬLLM障害が発生した場合でも、ユーザー体験を損なわない安定したフォールバック処理を提供できます。
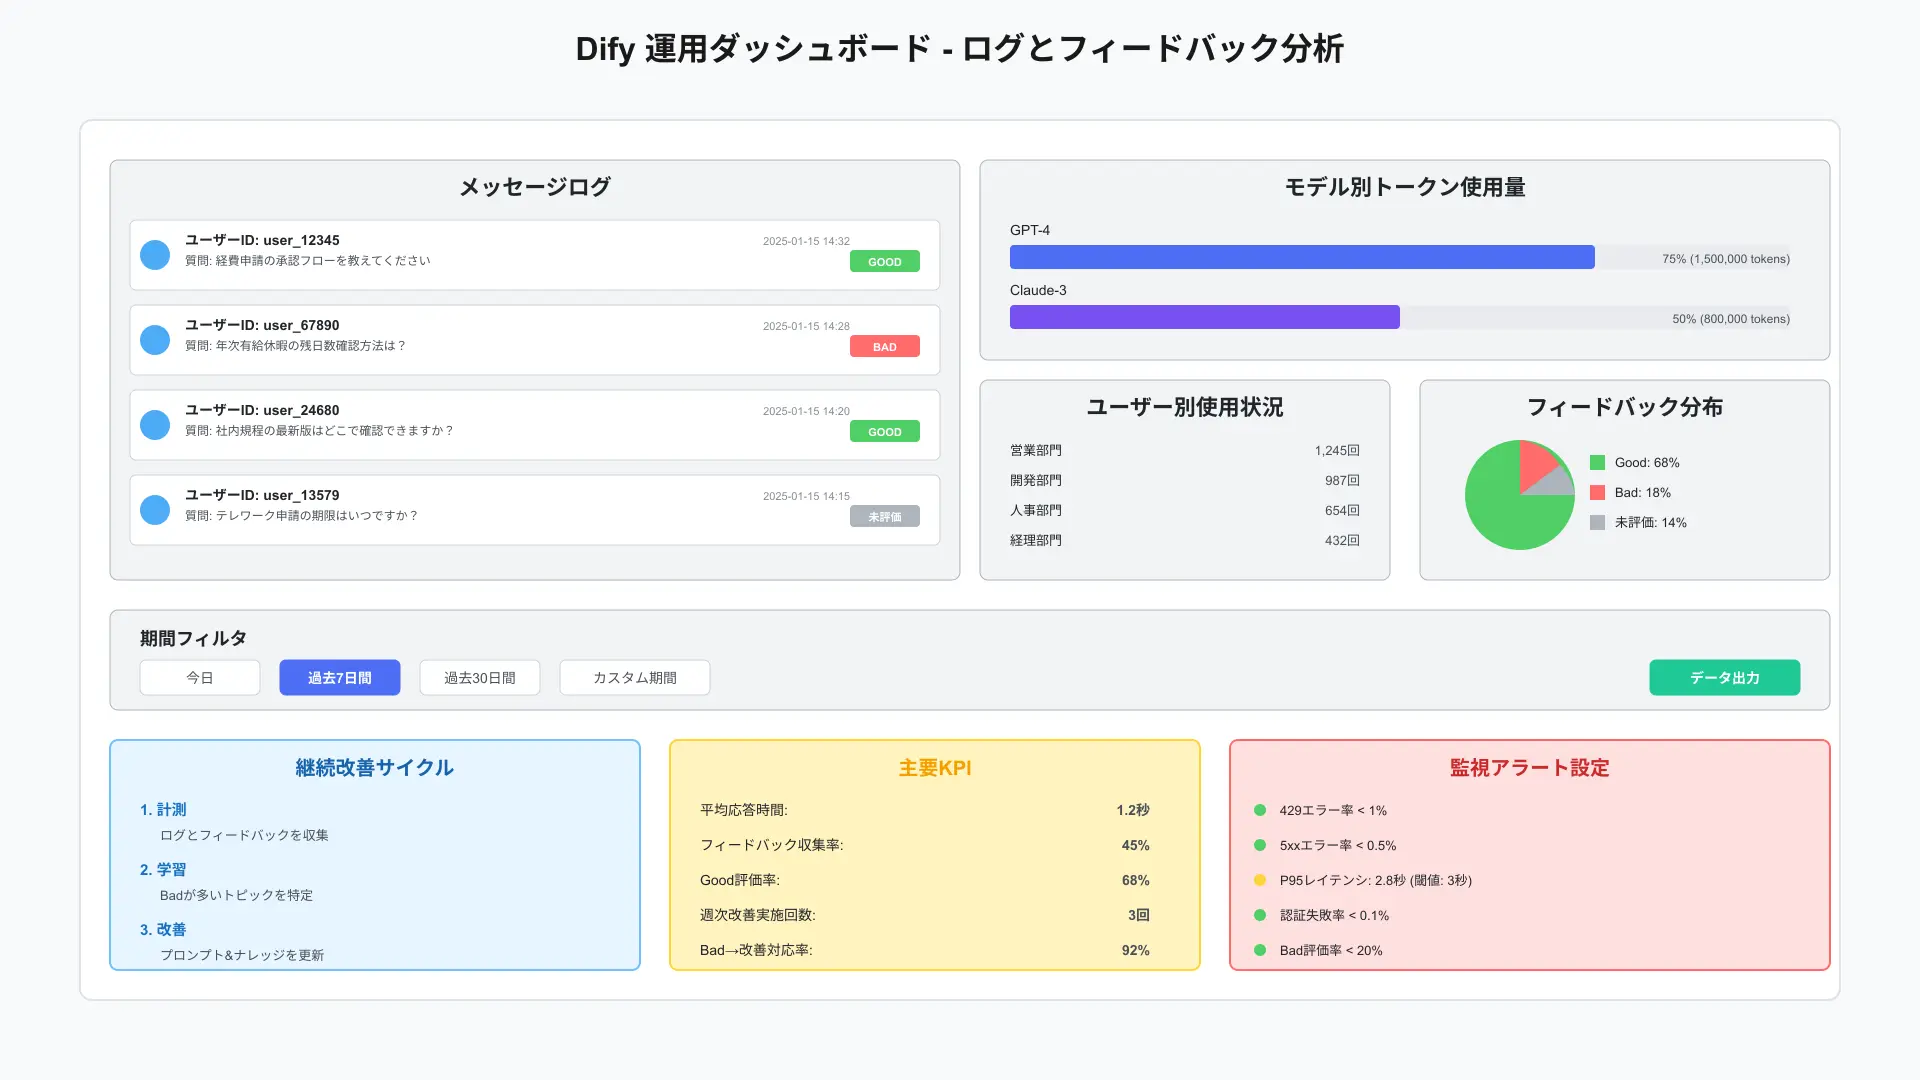
セキュリティ・コンプライアンス:フロントから直叩きしない理由とエンタープライズ対応
クライアントサイドからの直接通信を遮断し、通信経路の暗号化とアクセストークンの検証を徹底します。
Dify EnterpriseプランではSSO/SAML連携、監査ログのエクスポート、RBAC(役割ベースアクセス制御)が完備されています。
企業の厳格な情報セキュリティ基準を満たし、機密情報や顧客データを安全に保護するエンタープライズAI運用を実現できます。
料金・コスト設計:プラン選択とTCOの考え方
当セクションでは、Difyの2層料金構造と自前開発に対するTCO(総保有コスト)を解説します。
正しいコスト構造を把握することで、予算オーバーを防ぎ最大の費用対効果を引き出せるからです。
【2026年最新】主な料金プランとAPI制限の違い
クラウド版にはSandbox(無料検証)、Professional(月額$59)、Team(月額$159)、Enterpriseが用意されています。
上位プランほど作成可能なアプリ数、メンバー数、ベクターストレージ容量が拡張されます。
APIのレートリミット(QPS)要件に合わせて最適なプランを選択し、事業規模に応じた無理のないコスト設計が可能です。
BYOKモデル課金と「見えないコスト」の把握
Difyの利用料とは別に、自社で登録したOpenAIやClaudeのAPIキーに対する従量課金が発生します。
この「BYOK(Bring Your Own Key)方式」により、モデル提供元の最新割引やボリュームディスカウントをそのまま享受できます。
Dify利用料とLLM API費用の合算値を常に可視化し、無駄なトークン消費を抑制するコスト管理体制を構築できます。
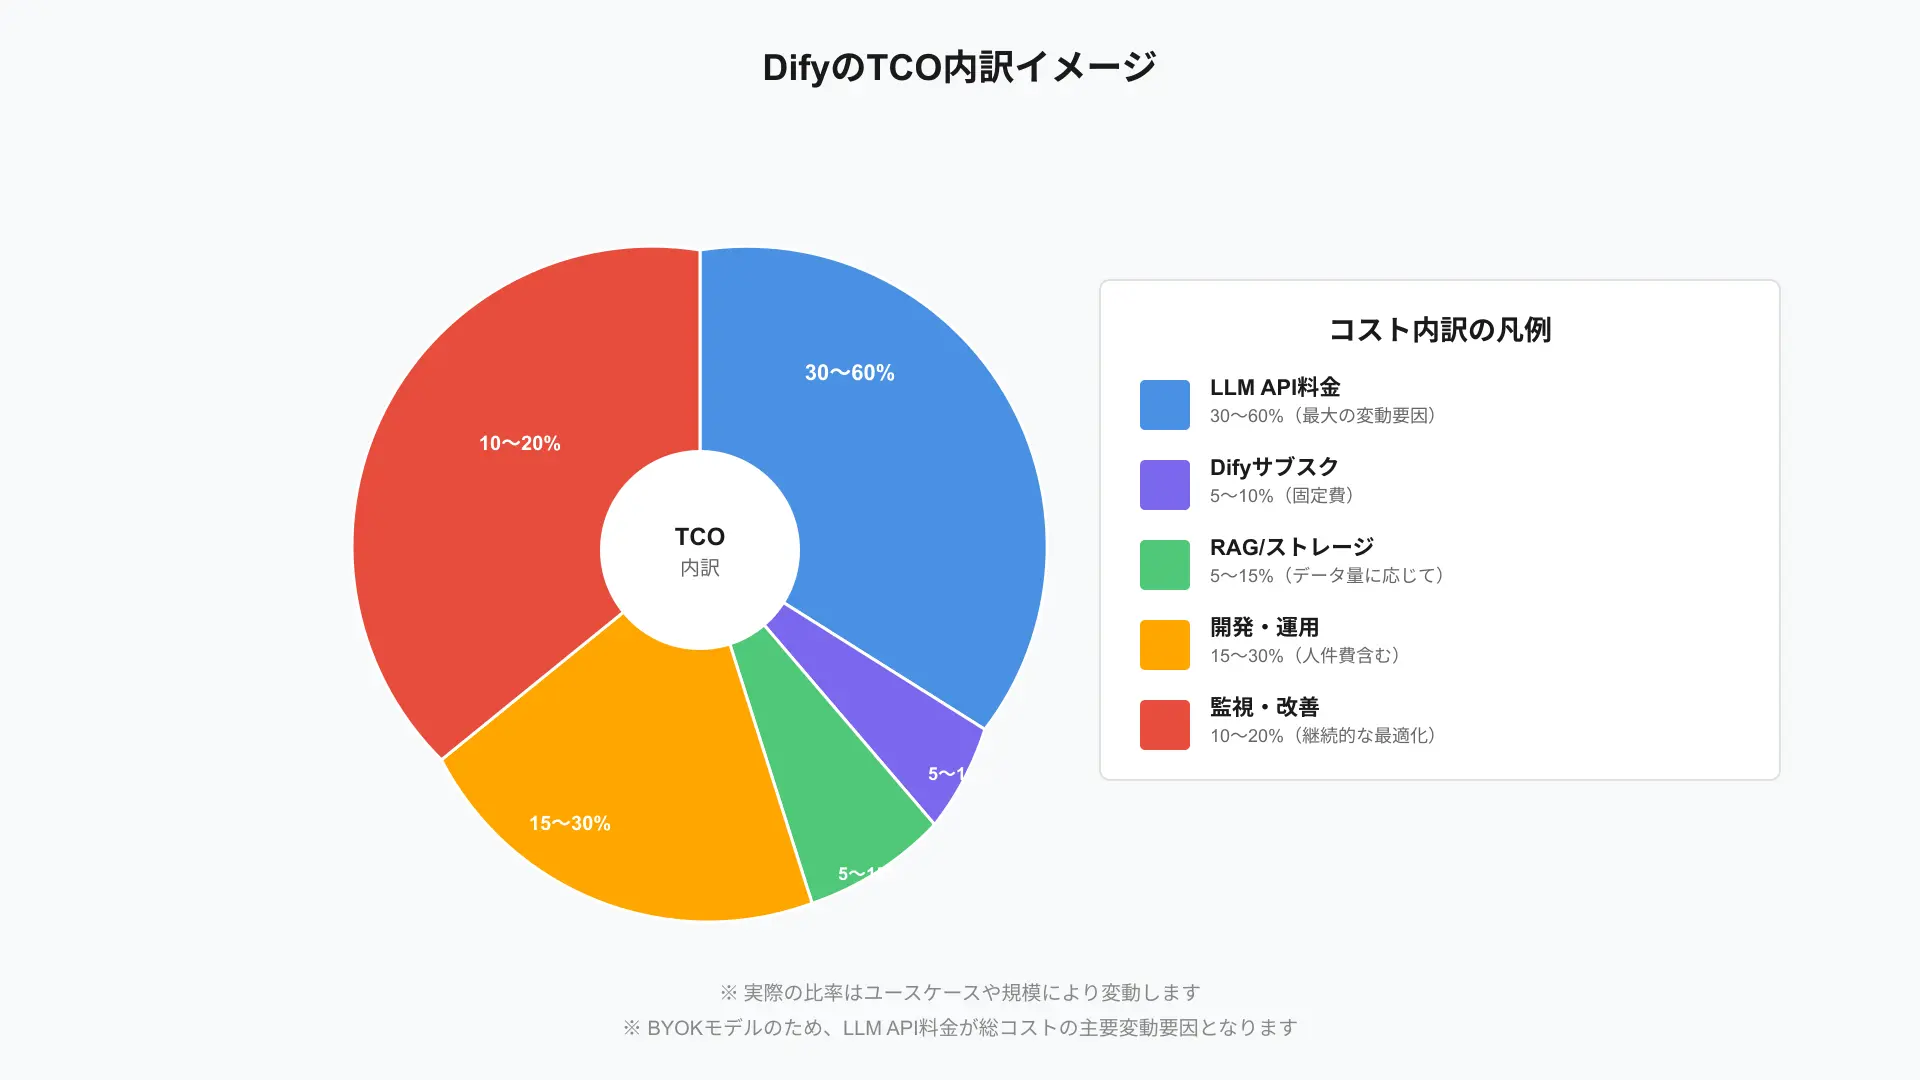
「自前構築 vs Dify」のコスト比較と判断の目安
LangChainやLlamaIndexを用いて自前でRAGやUI基盤を構築する場合、数ヶ月のエンジニア人件費と保守コストが生じます。
Difyを採用すれば月数万円程度のプラットフォーム費用で同等以上の機能が即座に手に入ります。
開発期間と運用保守コストを劇的に圧縮し、数千万円規模の開発ROI(投資対効果)を達成できます。
ユースケース別:Dify APIをどう組み込むか実装イメージ
当セクションでは、代表的な3つのビジネスユースケースにおけるAPI連携フローを解説します。
具体的なアーキテクチャ図を参照することで、自社への導入イメージが明確になるからです。
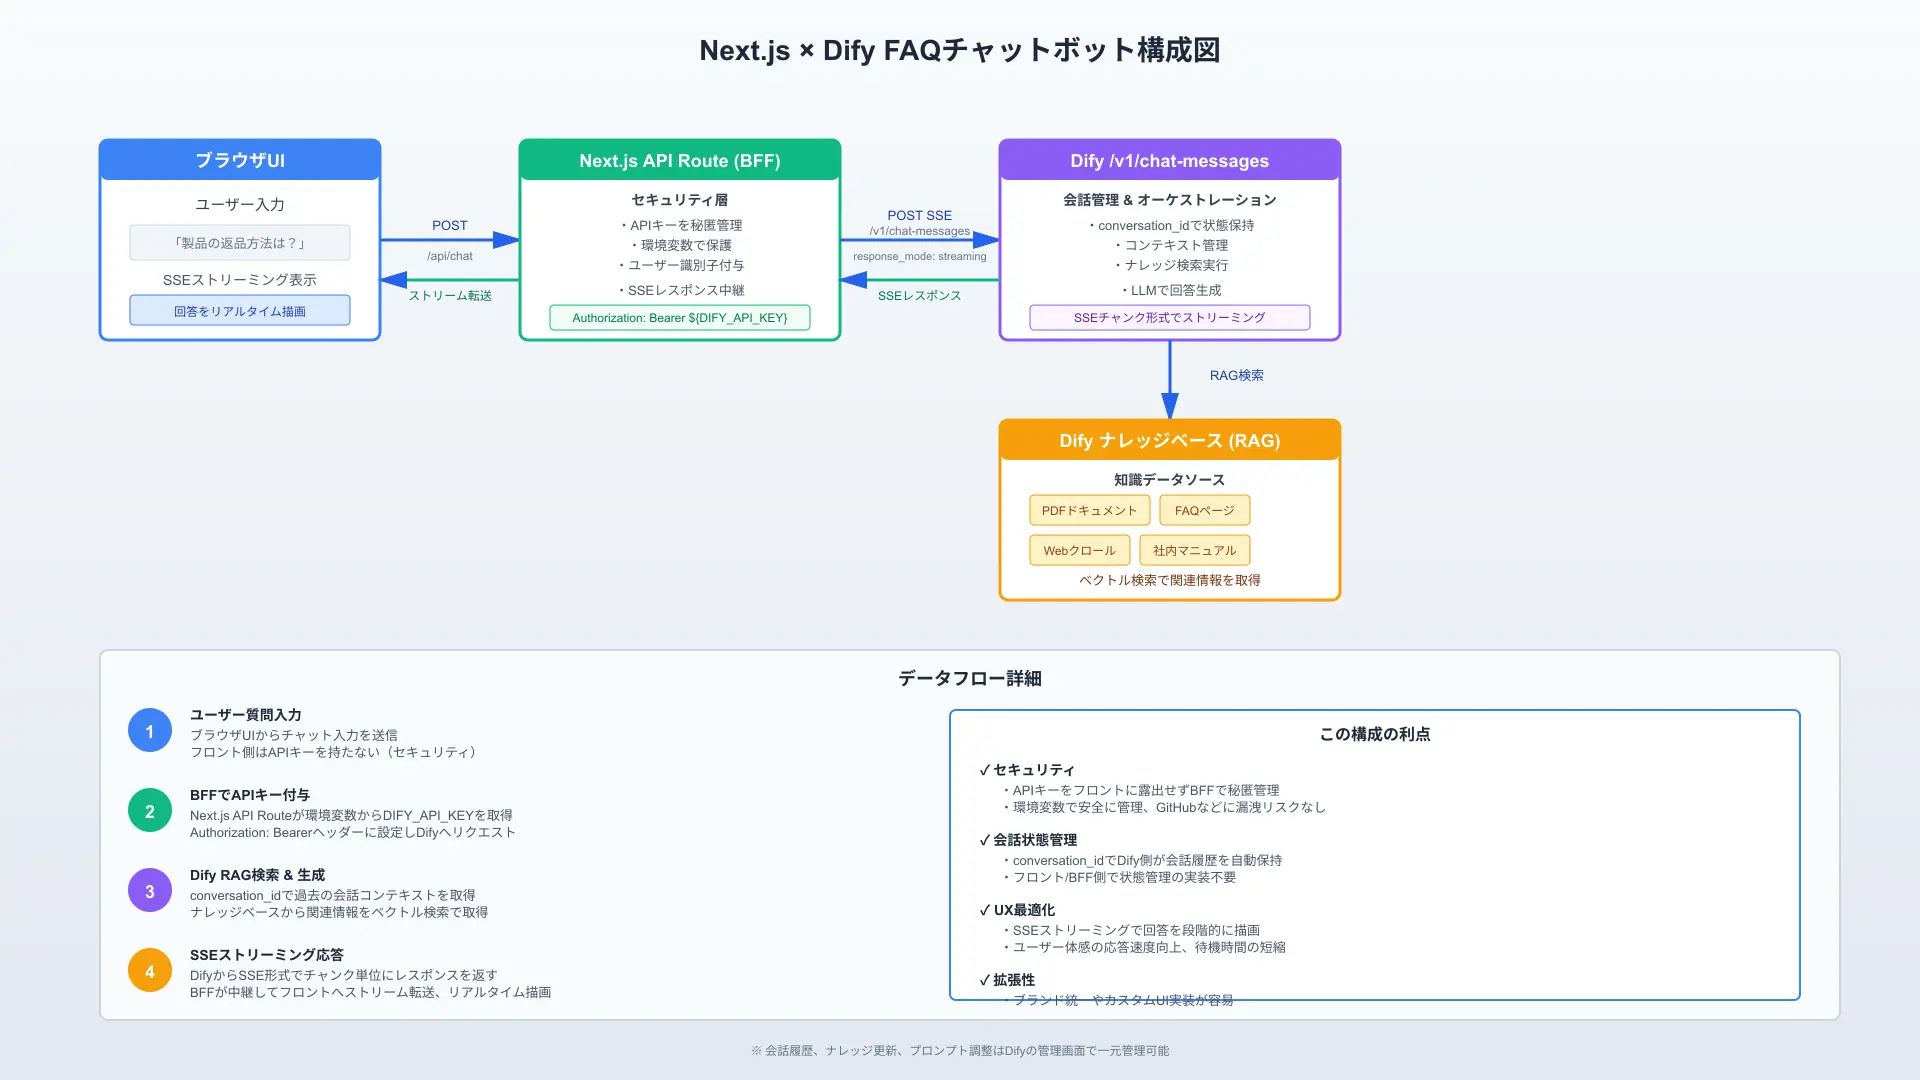
ユースケース1:自社Webサイト向けFAQチャットボット
Next.jsやReactで構築したWebサイトから自社サーバー経由で/chat-messagesをストリーミング呼び出しします。
ユーザーが入力した質問に対して社内マニュアルをRAG検索し、正確な参照元リンク付きで即座に回答します。
カスタマーサポートの問い合わせ対応件数を大幅に削減し、24時間365日の高精度な自動応答システムを構築できます。
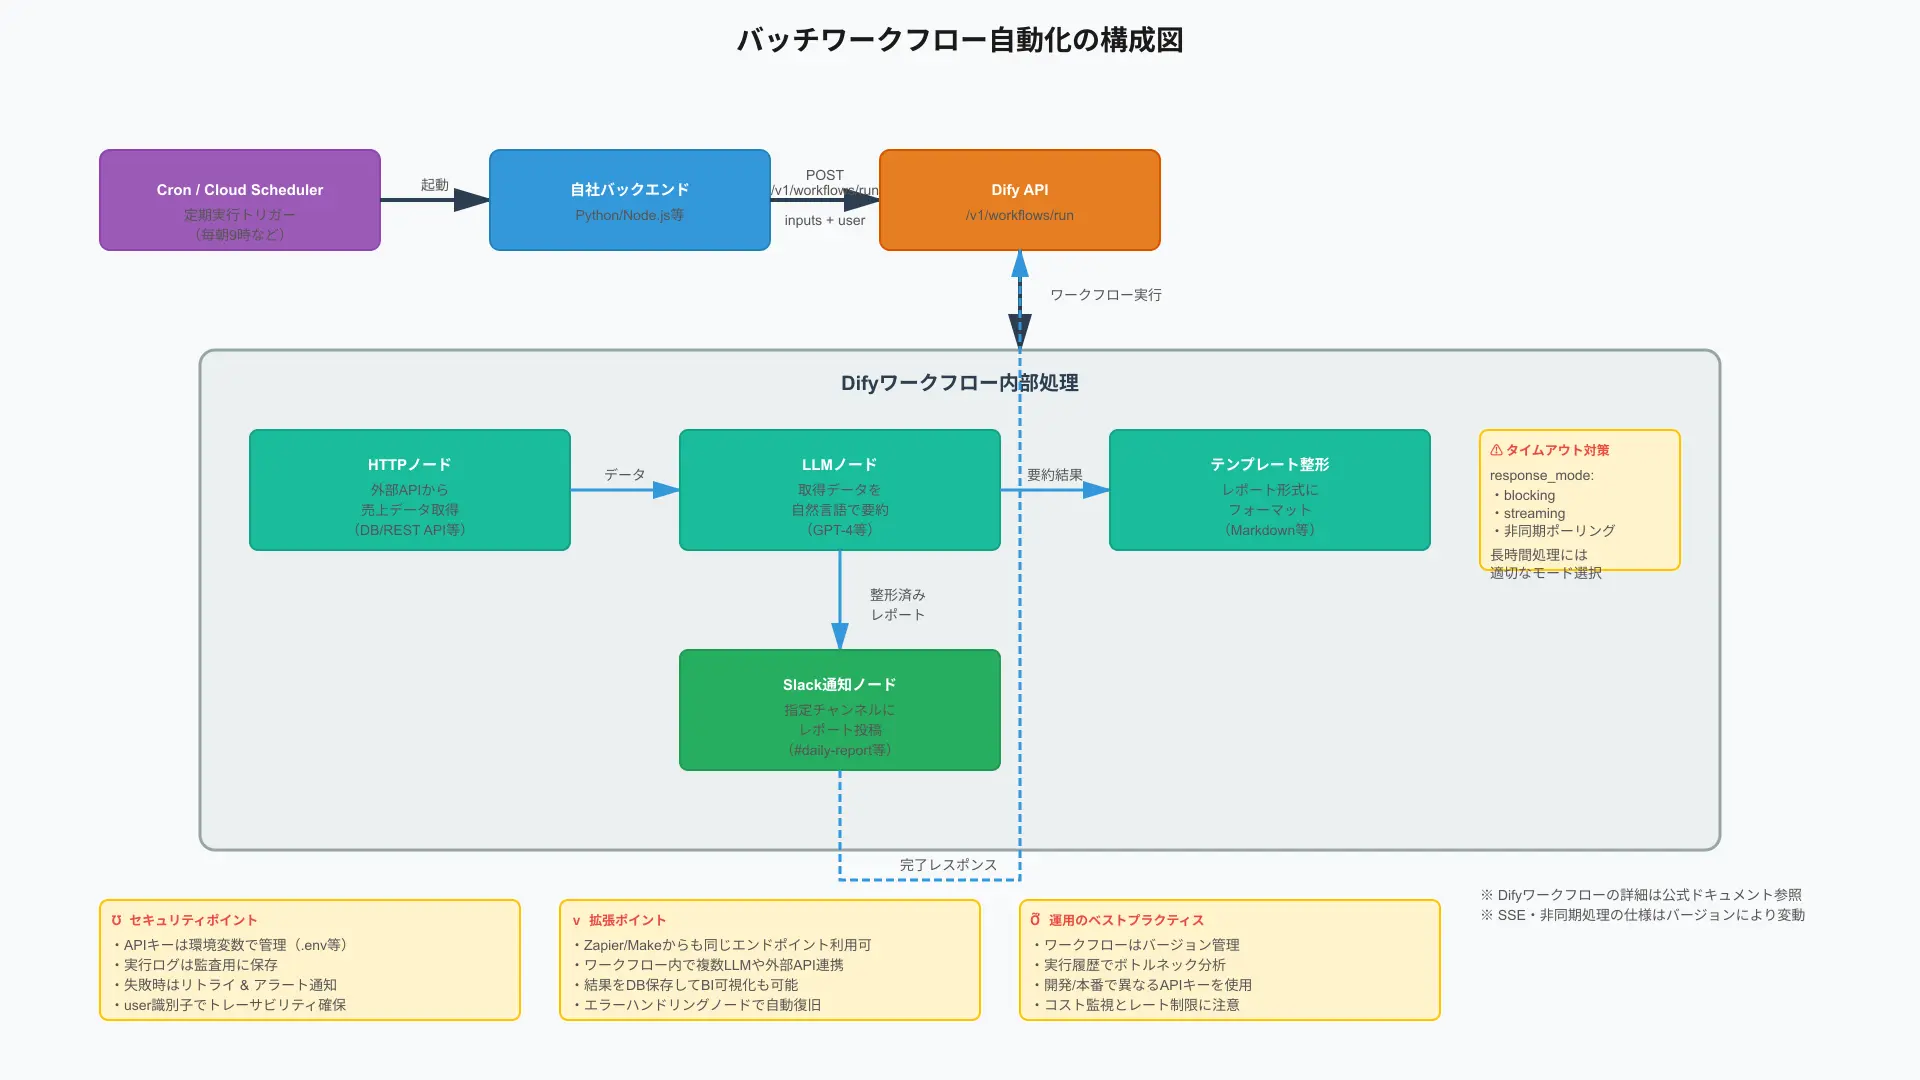
ユースケース2:バックエンドからのバッチワークフロー起動
夜間のCronジョブやAWS Lambdaから/workflows/runを非同期でバッチ実行します。
当日の営業日報や顧客アンケートデータを集約し、感情分析と重要トピックの要約レポートを自動生成します。
手作業による集計作業を完全にゼロにし、毎朝の経営会議へタイムリーなインサイトを提供できます。
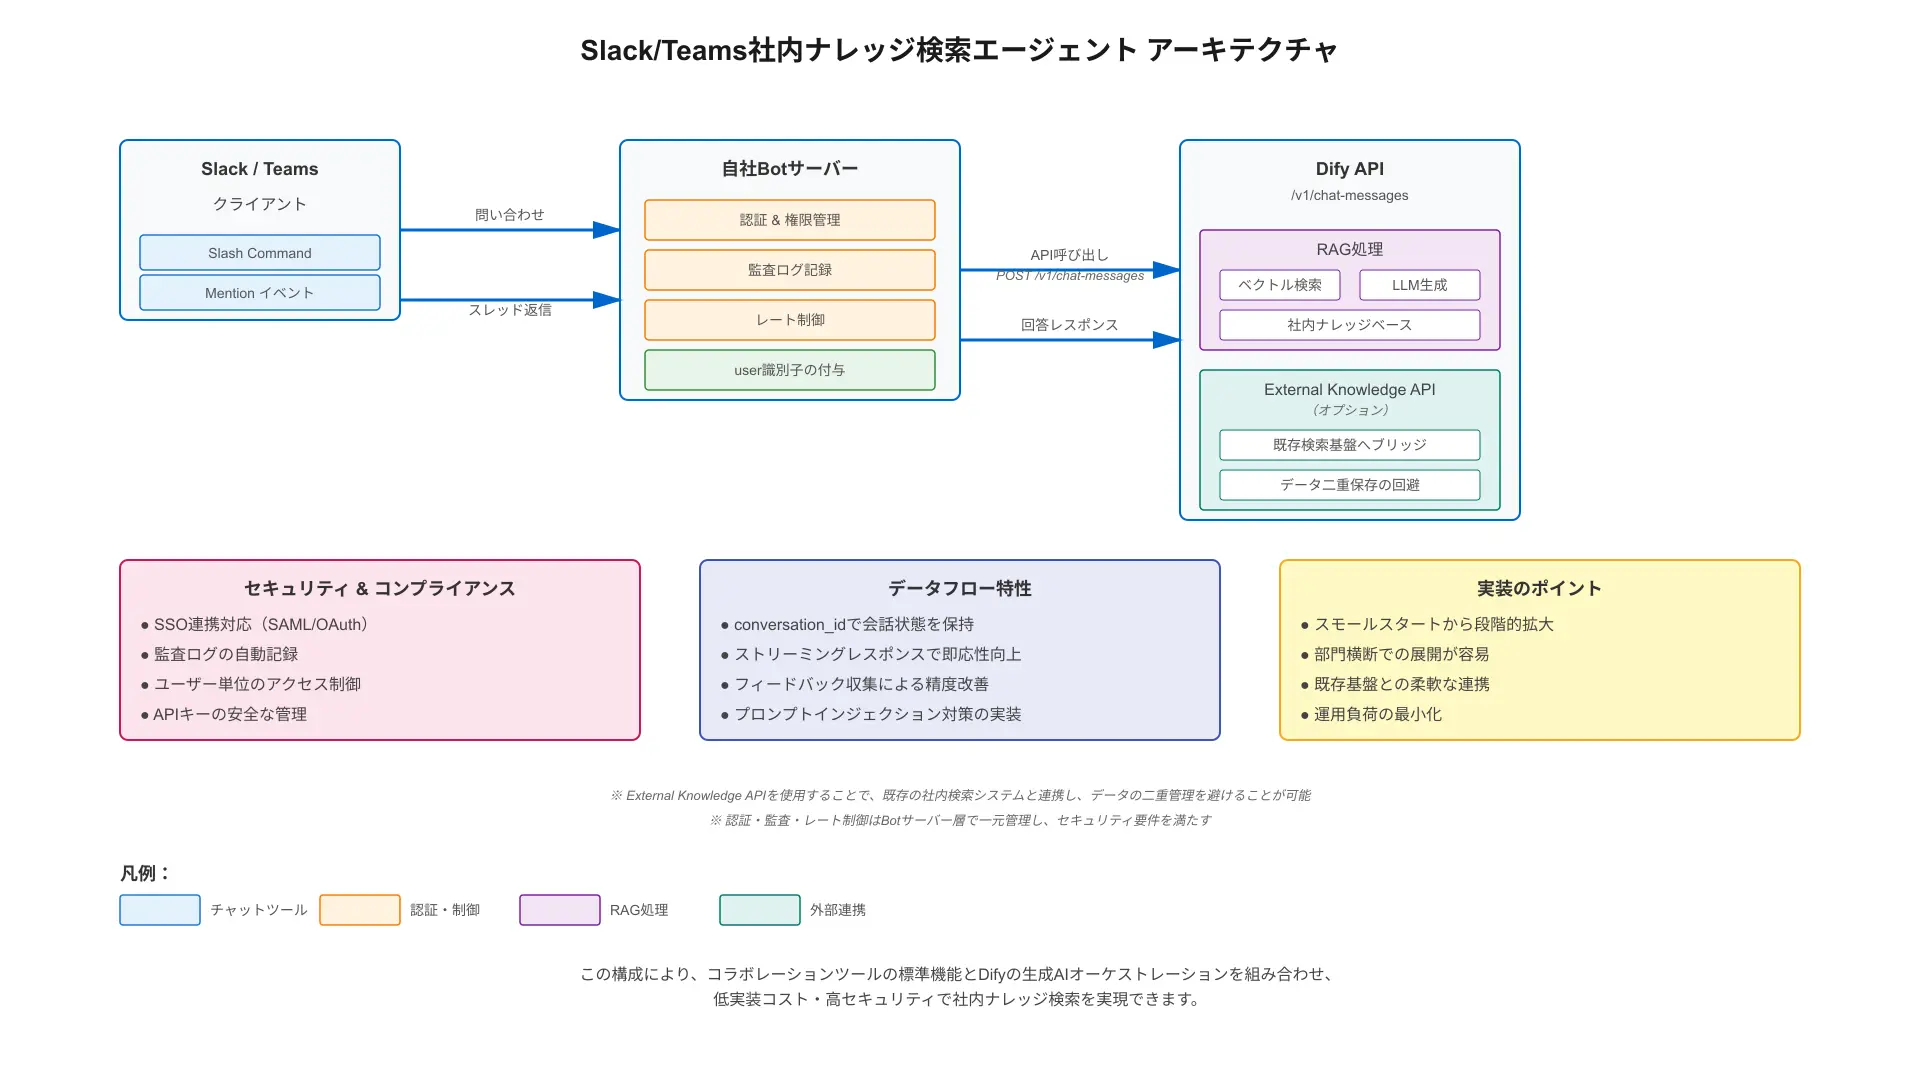
ユースケース3:社内ナレッジ検索エージェント(Slack/Teams連携)
Slack BoltやBot FrameworkとDify APIを組み合わせ、社内チャットツールから直接ナレッジを検索します。
社内規定や業務手順に関する質問に対して、Difyのエージェントがツールを実行して迅速に回答します。
全社的な情報探索時間を削減し、従業員の自己解決率を飛躍的に向上させる社内AIアシスタントを展開できます。
どんな組織・案件でDify APIがフィットするか:導入判断のチェックリスト
当セクションでは、自社のプロジェクトにDify APIが適合するかを判定するチェック基準を解説します。
向き不向きを正しく見極めることで、技術選定の失敗を未然に防げるからです。
Difyが特に向いているパターン
スピーディーにPoCを立ち上げたいプロジェクトや、非エンジニアと共同でプロンプトを改善したい組織に最適です。
RAG検索やワークフローなど、一般的なAIアプリケーション要件の8割以上をGUIとAPIでカバーできます。
限られた開発リソースで最大の成果を出したいスタートアップから大企業まで、圧倒的なスピード感でAIプロダクトを量産できます。
逆にDifyを選ばないほうがよいケース
数ミリ秒単位の極限の低レイテンシが求められる金融取引や、独自の独自モデルアーキテクチャを直接操作したいケースです。
また、完全なオンプレミス閉域網での自社製LLM運用など特殊なインフラ制約がある場合は個別開発を検討します。
自社の技術要件とインフラ制約を照らし合わせ、プラットフォームの制約がボトルネックにならないか事前に評価することが重要です。
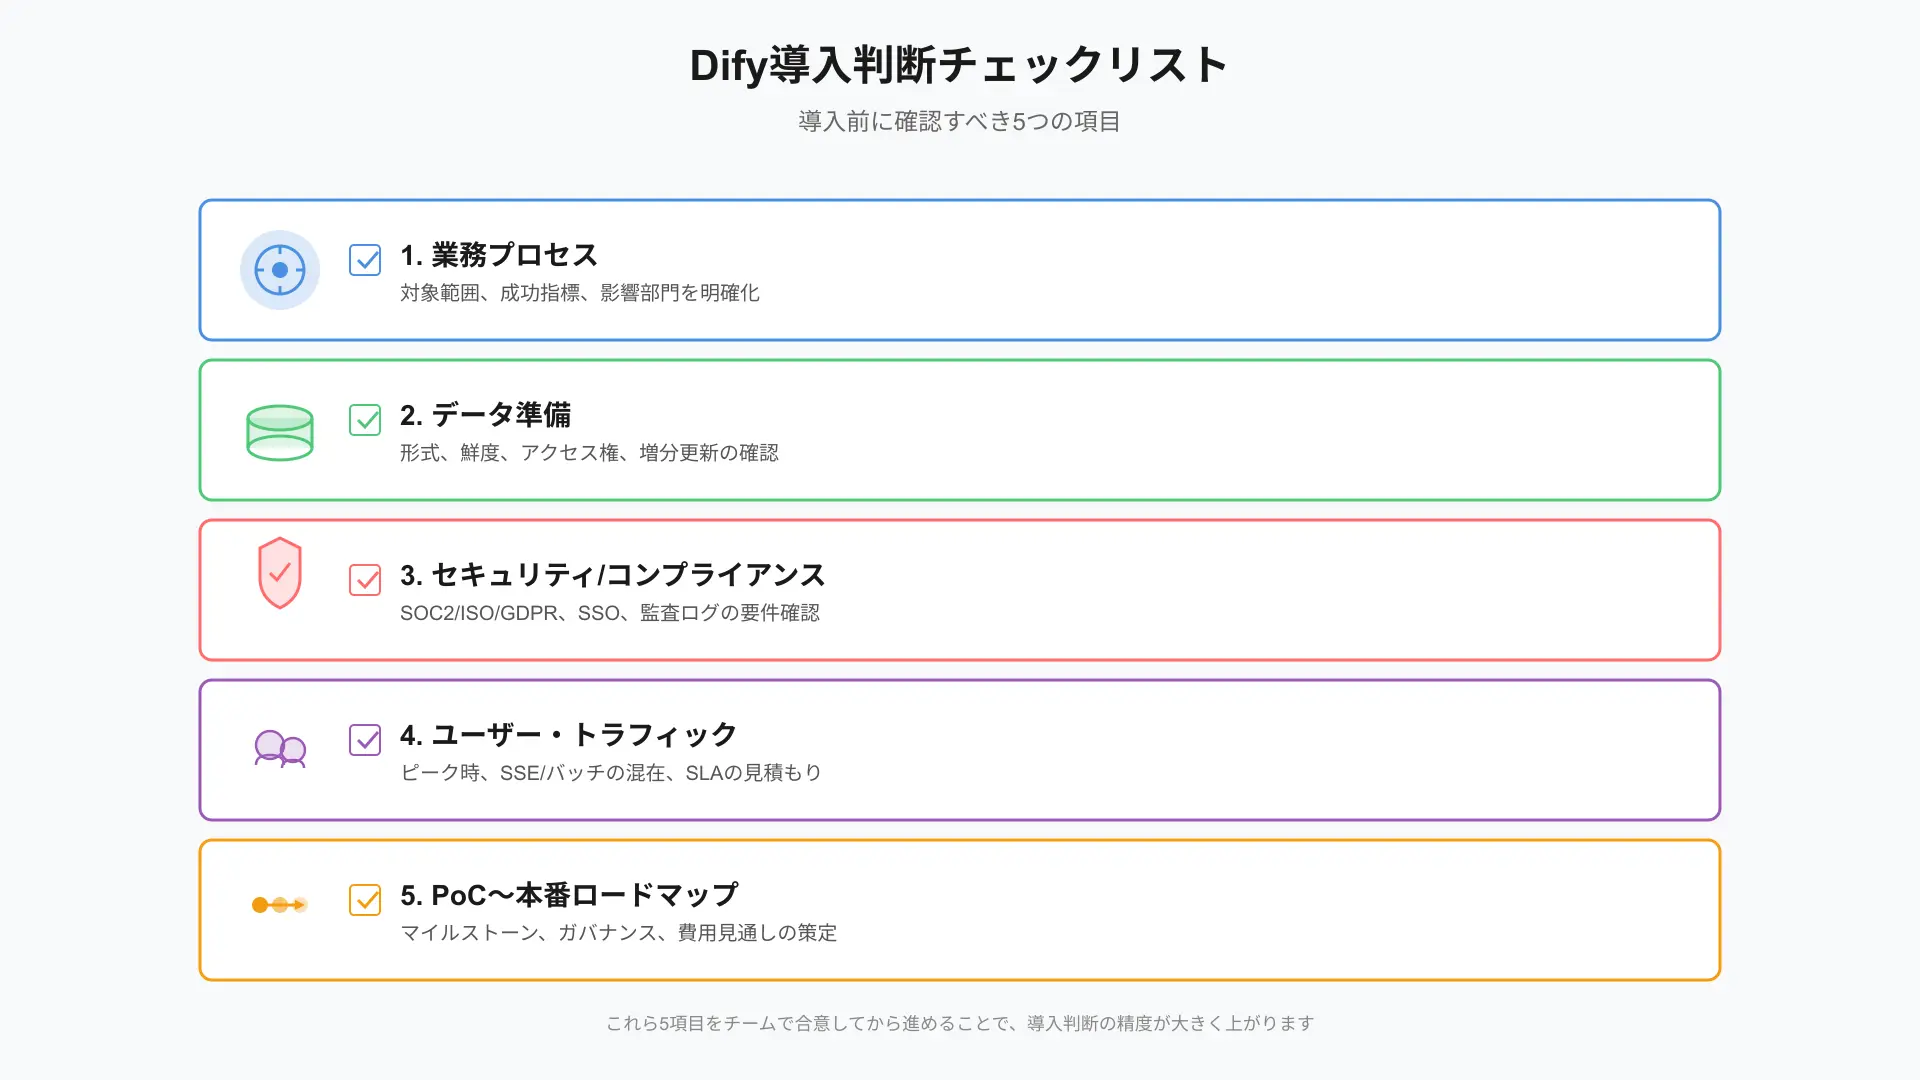
導入前に確認したいチェックリスト
セキュリティ要件、データ更新頻度、想定リクエスト数(QPS)、開発メンバーのスキルセットを確認します。
チェック項目を1つずつクリアすることで、本番運用開始後の予期せぬトラブルを確実に回避できます。
確実な導入計画を策定し、安全で持続可能な全社的AIトランスフォーメーションを推進しましょう。
まとめ
Dify APIを活用することで、プロンプト・RAG・ワークフローの管理をGUIに集約し、数行のコードで高度なAI機能を自社サービスへ統合できます。
直接LLM APIを叩く場合と比べて開発生産性と保守性が劇的に向上し、非エンジニアとの協業体制もスムーズに構築可能です。
まずはクラウド版のSandboxやProプランを活用して、Dify APIによる次世代のAIアプリケーション開発を今すぐ体験してください!
【成果持ち帰り型3週間】
研修だけで終わらせない!「自社専用AI」定着パッケージ
「社員がAIを使えない」「自社商材に合わない」を解決。講師がその場で実務用にカスタマイズ。月額10万円〜。
自社のプロダクトや業務システムにDify APIを組み込み、圧倒的なDX推進力を手に入れましょう。