(最終更新日: 2026年09月20日)
AIエージェントを運用する中で、「さっき教えたはずのことを忘れてしまう」と困ったことはありませんか?
特にビジネスの現場では、過去の経緯や文脈を正確に反映した回答が求められるため、記憶の管理は非常に大きな壁となります。
この記事では、OpenClawの「Memory」機能を活用し、AIに確かな長期記憶を持たせるための全技術を公開します。
仕組みの理解から具体的な設定、さらには情報の自動整理術まで、この記事を読むだけで理想の自律型エージェントを構築できるようになります。
2026年の最新仕様に基づき、セキュリティやコスト最適化といった実務で直面する課題も網羅的にカバーしました。
専門的な知識がなくても大丈夫です。AIを単なるツールから「業務を任せられる真のパートナー」へと進化させる一歩を、ここから一緒に踏み出しましょう!
OpenClaw Memoryの内部構造:ローカルファーストな多層ストレージ設計
当セクションでは、自律型AIエージェントの脳ともいえるOpenClaw Memoryの内部アーキテクチャについて、その中核をなす設計思想と具体的な仕組みを詳しく解説します。
AIが過去の文脈を失わずに業務を継続するためには、単なるデータの蓄積ではなく、人間が制御可能な透明性の高いストレージ構造が不可欠だからです。
- 「Markdown」を真実の源泉とする設計思想のメリット
- セッション・日次・恒久知識:4つの記憶レイヤーの役割
- プライバシーを守る「コンテキスト分離境界」の仕様
「Markdown」を真実の源泉とする設計思想のメリット
OpenClawはAIの記憶を不透明なデータベースの中に閉じ込めるのではなく、ユーザーの手元にあるMarkdownファイルを「唯一の真実(Single Source of Truth)」として扱う設計を採用しています。
このアプローチにより、エンジニアや管理者は特別なツールを使わずとも、普段使いのエディタで~/.openclaw/workspace配下のファイルを直接閲覧し、必要に応じて内容を修正することが可能です。
例えば、AIが過去の打ち合わせ内容を誤って解釈して記憶してしまった際、テキストファイルを書き換えるだけで瞬時に「誤学習」を訂正できる運用上の利便性は、ブラックボックス化した他社製AIにはない大きな強みと言えます。
また、記憶そのものがプレーンテキストであるため、Gitを用いたバージョン管理や監査証跡の保存も極めて容易であり、エンタープライズ領域での信頼性確保に大きく寄与するでしょう。
実際に記憶の管理を自動化したい場合は、OpenClaw(オープンクロー)完全導入ガイド:Git連携による自律型AIアシスタントの構築と活用術を参考に、履歴管理を仕組み化することをおすすめします。
物理的なテキストファイルとして記憶が「見える化」されていることは、AIと人間が協調するワークフローにおいて、心理的な安全性と実用的な制御性の両立をもたらします。
セッション・日次・恒久知識:4つの記憶レイヤーの役割
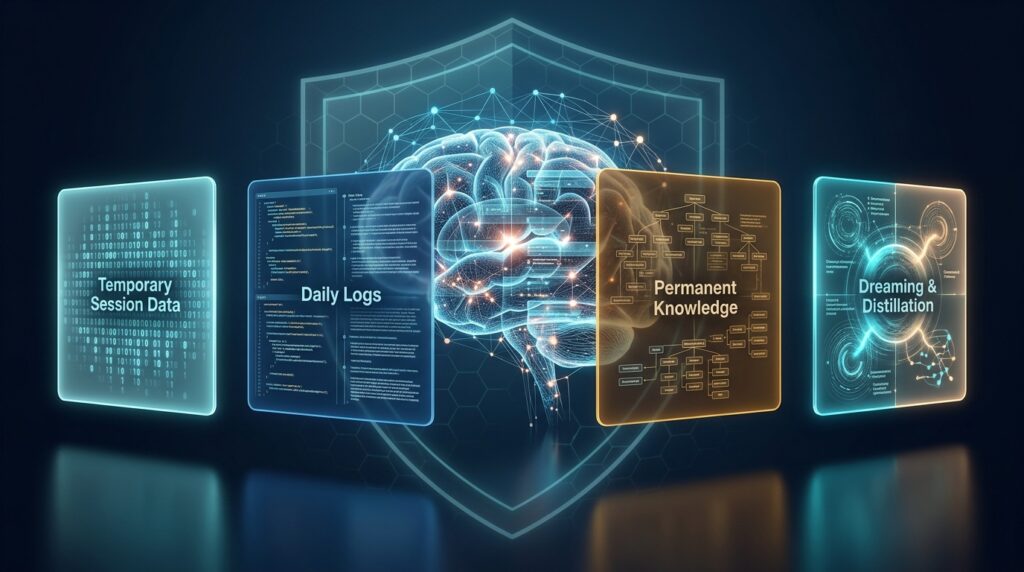
OpenClaw Memoryは、情報の鮮度と重要度に応じて厳密に分離された4つの記憶レイヤーで構成されており、それぞれが異なるライフサイクルを持っています。
すべての情報をフラットに扱うのではなく、情報の性質に合わせて物理パスや参照頻度を変えることで、LLMの限られたコンテキストウィンドウを効率的に活用するためです。
各レイヤーの役割と物理的な保存場所を整理すると、以下のようになります。
| 記憶レイヤー | 物理パス / 形式 | 主な役割と保持基準 |
|---|---|---|
| セッション層(短期) | メモリ内 / sqlite | 現在進行中の会話履歴。セッション終了時に破棄。 |
| 日次作業層(中期) | memory/YYYY-MM-DD.md | その日の作業ログ。セッション開始時に自動ロードされる。 |
| 恒久知識層(長期) | MEMORY.md | 確定したビジネスルールや個人設定。常に参照される。 |
| 記憶統合層(夢) | DREAMS.md | 自律的な知識昇格の記録。人間による監査用。 |
(参考: OpenClaw Docs)
例えば、午前中に行った「プロジェクト方針の決定」は日次ログに記録され、夜間の統合プロセスを経て、翌日にはMEMORY.mdへと昇格し、恒久的なルールとしてAIの行動を規定します。
このような多層的なストレージ設計により、大量の対話が発生してもAIが重要な指示を見失うことなく、長期間にわたって賢く振る舞い続けることが可能となります。
プライバシーを守る「コンテキスト分離境界」の仕様
企業導入において特に重要なのが、個人の秘匿情報が意図せず他者に漏洩することを防ぐ「コンテキスト分離境界」というセキュリティ設計です。
OpenClawでは、個人の役割や権限が記されたMEMORY.mdはダイレクトメッセージ(DM)でのみ自動ロードされ、共有チャンネルでは読み込まれない仕様が徹底されています。
この境界設計があるおかげで、例えばSlackのパブリックチャンネルでAIを呼び出した際に、自分だけの機密性の高い決定事項やプライベートな業務メモがプロンプトへ露出するリスクを構造的に回避できます。
これは複数のユーザーが参加するチーム環境において、個人のプライバシーと組織の共有知を明確に分けるための防波堤として機能します。
機密情報を扱う上でのリスク管理については、生成AIのセキュリティ完全解説でも触れられている通り、ツール側の設計レベルでの対策が最も効果的です。
こうしたプライバシー配慮型のアーキテクチャこそが、OpenClawを単なる趣味のツールではなく、ビジネスインフラとして選定する決定打となるはずです。
より高度なセキュリティ統制や導入事例に興味がある方は、生成AI活用の最前線を読み解くことで、次世代のAIエージェント運用に求められる要件をより深く理解できるでしょう。
高度な検索メカニズム:ハイブリッド検索と時間減衰アルゴリズム
当セクションでは、OpenClaw Memoryが膨大な履歴から最適な情報を抽出するための「高度な検索メカニズム」について解説します。
単なるテキスト検索では、エージェントが過去の膨大なコンテキストを正しく理解し、直近の優先事項を判断することが難しいため、独自のアルゴリズムによる最適化が必要不可欠だからです。
- ベクトル検索とBM25(全文検索)を統合したハイブリッド想起
- 時間減衰(Temporal Decay)による情報の鮮度管理
- MMR(最大限界関連度)による想起内容の多様化
ベクトル検索とBM25(全文検索)を統合したハイブリッド想起
ハイブリッド想起は、意味的な類似性を捉えるベクトル検索と、正確な単語一致を重視するBM25全文検索を高度に統合した手法です。
これにより、文脈の深掘りと特定の専門用語の捕捉を両立し、AIエージェントが過去の情報を極めて正確に再現することが可能になります。
具体的な実装として、SQLite FTS5のtrigramトークナイゼーションを活用し、日本語のようなCJK言語でも漏れのない高速な検索基盤が構築されています。
ドキュメントを400トークンごとに分割し、80トークンのオーバーラップを設ける設定は、情報の断片化を防ぐ上で極めて重要です。
この多角的なアプローチは、複雑なRAGシステムの構築においてもRAG構築のベストプラクティスの一つとして推奨されています。
時間減衰(Temporal Decay)による情報の鮮度管理
時間減衰(Temporal Decay)アルゴリズムは、記憶の鮮度を数学的に評価してコンテキストの優先順位を動的に制御する仕組みです。
過去の記録に対して半減期30日の指数減衰式を適用することで、情報の有用性が時間の経過とともに適切に割り引かれます。
数ヶ月前の陳腐化したメモが直近の重要な決定事項を上書きしてしまうノイズ問題を、この動的なスコアリングが未然に防いでいます。
エージェントが「なぜ古い指示を無視するのか」という疑問の答えは、常に最新の文脈を最優先するというこの時間管理ロジックにあります。
以下の表は、OpenClawにおける時間減衰の基本的な設定値を示したものです。
| 項目 | 詳細(出所: 公式ドキュメント) |
|---|---|
| 基本アルゴリズム | 指数減衰(Exponential Decay) |
| デフォルト半減期 | 30日 |
| 適用対象 | 日次作業ログ(memory/YYYY-MM-DD.md) |
この仕組みにより、蓄積された膨大な日次ログの中から、今まさに必要なエバーグリーンな情報だけが確実にLLMへ提供されます。
MMR(最大限界関連度)による想起内容の多様化
MMR(最大限界関連度)を導入することで、検索結果の重複を排除し、プロンプト内へ注入する情報の多様性を担保しています。
類似したログばかりが想起結果を独占すると、AIが参照できる視点が偏り、思考の柔軟性が失われてしまうためです。
適合性と多様性のバランスを計算するこの技術は、限られたトークン予算の中でコンテキストの密度を極限まで高める役割を担います。
同じような古いメモばかりが引用される失敗を避け、幅広い背景情報を踏まえた精度の高い回答を生成するにはこの設定が欠かせません。
多様な知識を効率よく活用することが、OpenClawを単なるチャットボットから真の自律型アシスタントへと昇華させる鍵となります。
自律型エージェントの能力を最大限に引き出すためには、生成AI 最速仕事術で紹介されているような、AIツールの組み合わせとプロンプト技術の習得も併せて検討すると良いでしょう。
自律的知識整理「Dreaming」:記憶の蒸留と昇格プロセス
当セクションでは、OpenClawの最もユニークな機能の一つである「Dreaming」パイプラインの詳細について説明します。
AIエージェントが長期間の業務を支えるためには、日々の些末な会話から真に重要な決定事項を抽出し、知識を純粋化する自律的な整理メカニズムが不可欠だからです。
- 浅い睡眠から深い睡眠へ:Dreamingの3段階フェーズ
- 長期記憶への昇格を決定する「6つの加重評価指標」
- 「夢日記(DREAMS.md)」の監査と可逆的なロールバック
浅い睡眠から深い睡眠へ:Dreamingの3段階フェーズ
OpenClawには人間の睡眠サイクルを工学的に模倣した、自律的な記憶整理システム「Dreaming」が備わっています。
日々の膨大な対話データから不要なノイズを削ぎ落とし、純粋な業務ロジックだけを抽出して長期記憶へ定着させる必要があるためです。
具体的には、毎日午前3時に起動するパイプラインがLight・REM・Deepの3段階を経て、重複情報の排除や内省的サマリーの生成を実行します。
この多層的な処理により、エージェントはビジネス上の重要事項を失うことなく、常にクリーンな状態のコンテキストを維持できるのです。
例えば、Ollamaを用いたローカルLLM連携環境であっても、このバックグラウンド処理はリソースを最適化しながら自律的に完遂されます。
長期記憶への昇格を決定する「6つの加重評価指標」
記憶が長期記憶層へ昇格するかどうかは、客観的な「6つの加重評価指標」に基づく厳格な計算によって決まります。
単なる情報の新しさだけでなく、検索時の適合性や出現頻度といった多角的な軸で情報の価値をスコアリングする仕組みが、RAGの精度維持に直結しているからです。
判定には、検索適合性(0.30)や出現頻度(0.24)、クエリ多様性(0.15)などの重み付けが用いられ、これら全ての閾値を突破した精鋭知識のみが「MEMORY.md」へと追記されます。
このような高度な評価アルゴリズムは、一般的なRAG構築のベストプラクティスと比較しても、情報の鮮度と重要性のバランスにおいて極めて優れた設計と言えます。
もし特定の知識を強制的に定着させたい場合は、日常的にその情報を繰り返し参照させるか、あるいはファイルを直接編集する運用ハックも有効です。
「夢日記(DREAMS.md)」の監査と可逆的なロールバック
AIが何を学び、なぜその結論に至ったのかというプロセスは、すべて「DREAMS.md」と呼ばれる夢日記を通じて可視化されています。
自律的な学習には誤学習のリスクが伴うため、人間がいつでも内容を監査し修正できる透明性を確保することが、企業導入における安全運用の鍵となります。
AIが意図しないルール変更を行った場合でも、以下のコマンドを実行することで、記憶の状態を安全に過去へ巻き戻すことが可能です。
openclaw memory rem-backfill --rollbackログの確認とロールバック機能を活用することで、エージェントの暴走を防ぎながら信頼性の高い独自のナレッジベースを育て上げることができます。
より高度なエージェント運用を目指すなら、生成AI 最速仕事術を参考に、AIとの効率的な協業プロセスを体系化することをおすすめします。
2026年最新:OpenClawの導入コストと推奨インフラ要件
当セクションでは、OpenClawの導入にかかるコスト構造と、安定稼働に不可欠な推奨インフラ要件について詳しく解説します。
オープンソースである本システムはライセンス料が無料である一方、推論APIの従量課金やホストサーバーのスペックが運用コストに直結するため、事前のシミュレーションが導入成功の鍵となるからです。
- MITライセンスによる「基本無料」の費用構造と運用TCO
- 推論エンジンの選択:商用API利用 vs 完全ローカル運用の比較
- Node.js環境とDockerによる隔離環境のセットアップ
MITライセンスによる「基本無料」の費用構造と運用TCO
OpenClawはMITライセンスの下で公開されており、ソフトウェア自体の利用に伴う固定のライセンス費用は一切発生しません。
非営利組織であるOpenClaw Foundationがプロジェクトの中立的なガバナンスを担っているため、ユーザー数やエージェント数に応じて課金が膨らむSaaS型サービスとは根本的に異なるコスト構造を持っています。
具体的な運用コストは、ホストとなるVPS等のインフラ費用と、LLM(大規模言語モデル)の推論API利用料のみに集約されるのが大きな特徴です。
| コスト項目 | 商用APIモデル利用 | 完全ローカル運用 |
|---|---|---|
| ソフトウェア | 無料(MIT License) | 無料(MIT License) |
| インフラ費用 | 月額 約5ドル〜(VPS等) | 初期投資(GPUサーバー等) |
| 推論API費用 | 従量課金(例: Claude Sonnet 4.6) | 0円 |
| Embedding費用 | 数セント / 1Mトークン | 0円 |
(参考: SFAI Labs)
この柔軟なTCO(総保有コスト)モデルにより、企業はアカウント課金に縛られることなく、自律型エージェントを組織全体へスケールさせることが可能になります。
推論エンジンの選択:商用API利用 vs 完全ローカル運用の比較
エージェントの「知能」となる推論エンジンの選定は、業務の機密性と予算のバランスを考慮して慎重に行うべきです。
高い日本語推論能力を求めるならClaude Sonnet 4.6等の商用APIが最短の選択肢となりますが、社外秘データを扱う場合は外部通信を遮断したローカルモデルの運用が必須条件となります。
業務実用レベルのレスポンスを確保するには、VRAM 16GB以上のGPUを搭載したサーバーでOllamaやllama.cppを稼働させる構成が推奨され、詳細はOpenClawとローカルLLM環境構築の完全ガイドで詳しく解説されています。
トークン消費量を節約するメモリ圧縮(Compaction)機能を併用しつつ、プロジェクトのセキュリティポリシーに合致した最適なエンジン構成を構築しましょう。
Node.js環境とDockerによる隔離環境のセットアップ
安定した長期記憶の保持とシステムの安全性を両立させるには、Dockerを用いた隔離環境でのセットアップを標準構成とすべきです。
OpenClawはOS権限下でファイル操作やコマンド実行を行う強力なエージェントであるため、物理的なホスト環境を論理的に隔離することがセキュリティ防衛の要となります。
Node.js 24.16+必須などのバージョン要件を遵守しつつ、公式ドキュメントに基づいたコンテナ構築を行うことで、環境依存のエラーを最小限に抑えた再現性の高い導入が可能です。
初心者が陥りやすい「環境変数PATHの通し忘れ」などのトラブルについては、OpenClawインストール完全ガイドのチェックリストを参考に事前対策を講じておきましょう。
Docker Sandboxによるサンドボックス化は、万が一のプロンプトインジェクション時にも影響範囲を限定できるため、エンタープライズ運用における必須要件と言えます。
自律型エージェントをビジネスの現場で使いこなすための本質的な知見は、生成AI 最速仕事術でも体系的に学ぶことができます。
セキュリティ統制:企業導入で必須となる多層防御の設定
当セクションでは、OpenClawを企業環境へ安全に導入するためのセキュリティ統制と多層防御の設定について解説します。
OpenClawはシェル権限を持つ強力なエージェントであるため、適切な隔離と認証、承認プロセスの確立が、組織的なガバナンスと安全性を担保する上で必須の要件となるからです。
- Docker Sandboxによる「爆発半径」の極小化
- Gateway Tokenとプライベートネットワーク境界の構築
- 「実行承認(Exec Approvals)」による人間介在型のワークフロー
Docker Sandboxによる「爆発半径」の極小化
自律型エージェントの実行環境を物理的に隔離することは、セキュリティの根幹を支える最も重要な防護策です。
AIが悪意あるプロンプトインジェクションの影響を受け、OSに対して破壊的なコマンドを生成・実行してしまうリスクを完全に排除することは困難であるためです。
具体的には、Dockerを用いたマイクロVM技術を活用し、ホストマシンのルートディレクトリをマウントせず限定的なワークスペースのみを公開する設定を標準構成とします。
詳しいコンテナ構成のベストプラクティスについては、OpenClawをDockerで構築する完全ガイドでも詳しく解説されています。
このようなSandbox環境を構築し影響範囲(爆発半径)を極小化することで、万が一の際も基幹システムや機密データへの被害を食い止めることが可能になります。
Gateway Tokenとプライベートネットワーク境界の構築
制御プレーンへのアクセス経路を厳格に管理し、ネットワーク的な境界線を引くことが外部攻撃への有効な対策となります。
過去にはポートの外部公開を突いた遠隔コード実行(RCE)の脆弱性が報告されており、不用意なエンドポイントの露出は深刻なリスクを招くからです。
運用の際は、すべてのAPIリクエストに対して厳格なGateway Tokenによる検証を強制し、さらにTailscaleやVPNを用いた閉域網内での通信に限定する必要があります。
詳細なネットワーク設定手順や認証の強化については、OpenClaw Gateway完全解説に記載されたガイドラインが参考になります。
認証と物理的なアクセス制限を組み合わせた多層防御を敷くことで、インターネット上の脅威からエージェントを確実に保護できます。
「実行承認(Exec Approvals)」による人間介在型のワークフロー
リスクの高い特定の操作に対して「人間による最終的な承認」を必須とするプロセスは、企業のガバナンス維持に不可欠です。
ファイルの不可逆な削除や外部への一斉メール送信といった処理をAIに独断で任めることは、業務継続性の観点から大きなリスクを伴うためです。
OpenClawにはExec Approvals(実行承認)という機能が備わっており、リスクのあるツール実行前にSlackやターミナル経由で管理者の許可を求めるフローを定義できます。
このような「Human-in-the-loop」の仕組みを導入することで、AIの生産性を享受しつつ、予期せぬ挙動による暴走を物理的に阻止できます。
企業のDX推進においてセキュリティ意識を高めるためには、生成AI活用の最前線などの専門知見を取り入れ、リスク管理と活用のバランスを最適化することが推奨されます。
自律性と監督を適切に使い分ける運用ルールこそが、AIエージェントを組織の正式な一員として迎えるための成功要因となります。
まとめ:OpenClawで「進化し続けるAI」をその手に
本記事では、OpenClaw Memoryが実現する「忘れないAI」の核心である、ローカルファーストな多層ストレージ設計やハイブリッド検索、そして自律的な知識蒸留「Dreaming」について詳しく解説しました。
機密データを自社で管理しながら、使えば使うほど個別の業務に最適化されるこのシステムは、次世代の生産性向上における決定打となります。
セキュリティと利便性を両立させたエージェント構築は、もはやSFではなく、今日からあなたが踏み出せる現実のステップです。
もし、実装の技術的な壁やセキュリティ設計に不安を感じる場合は、専門のサポートを検討してみてください。
OpenClawを活用した「記憶を持つAI自律エージェント」の構築・導入支援は、Saiteki AIにお任せください。
あなたの業務に最適化したMEMORY.mdの設計や、安全なDocker環境の構築、ローカルLLMの選定までを専門コンサルタントが伴走サポートします。
【無料相談】OpenClaw導入支援・DXコンサルティングのお問い合わせはこちら
また、自律型エージェントを使いこなすための基礎スキルを磨きたい方には、以下のリソースも強く推奨します。
生成AI 最速仕事術でプロンプト技術の本質を学び、エンジニアとしてスキルを深めたい方はAidemyやバイテック生成AIで実践的な開発・運用スキルを習得することをお勧めします。
あなたの第一歩が、組織の未来を大きく変える原動力になることを心より応援しています。