(最終更新日: 2026年09月06日)
「手元のOllamaを最新バージョンへ安全にアップデートしたいけれど、具体的なコマンドや手順がわからない」「本体を更新すると、これまでにダウンロードした数十GBのモデルや設定が消えてしまわないか不安」「アップデートを実行したのにエラーが出て更新が止まってしまう」とお困りではありませんか?
オープンソースLLM(大規模言語モデル)をローカルで手軽に動かせるOllamaは、世界中の開発者の手によって驚異的なスピードで進化を続けています。最新バージョンへアップデートすることで、Flash Attentionによる推論速度の劇的な向上や、構造化出力(JSON Schema)のサポート、Llama 4やDeepSeek-R1などの次世代モデルへの即時対応など、膨大なメリットを享受できます。
本記事では、2026年最新のOllama環境におけるバージョンの確認方法から、Windows・macOS・Linux・Docker各OS別の本体アップデート手順、保存済みモデルの更新テクニック、Ollama Cloud連携、そしてアップデート失敗時のトラブルシューティングまでをわかりやすく徹底解説します。
Ollamaの最新アップデートが重要な理由とバージョンの確認方法
Ollamaは急速なペースでアップデートが配信されており、新モデル対応や推論速度の高速化、新APIの追加が行われています。本章では、現在のバージョン確認方法と最新版へ更新すべき理由を解説します。
- 現在のバージョンを確認する基本コマンド(ollama –version)
- 最新バージョンへの更新で得られる恩恵(Flash Attention・推論高速化・構造化出力)
- 本体アップデート時における既存モデルデータ・設定の安全性
現在のバージョンを確認する基本コマンド(ollama –version)
まずは現在インストールされているOllamaのバージョンを確認しましょう。ターミナル(PowerShellやBash)で以下のコマンドを実行します。
$ ollama --version
# または短縮形
$ ollama -v実行すると、ollama version is 0.13.4のように現在稼働中のバージョン番号が表示されます。
GitHubの公式リリースページ(ollama/ollama releases)と見比べることで、手元の環境が最新版に追従しているかを即座に判定できます。
最新バージョンへの更新で得られる恩恵(Flash Attention・推論高速化・構造化出力)
Ollamaを最新版に保つ最大のメリットは、コアエンジンの最適化によるパフォーマンス向上です。
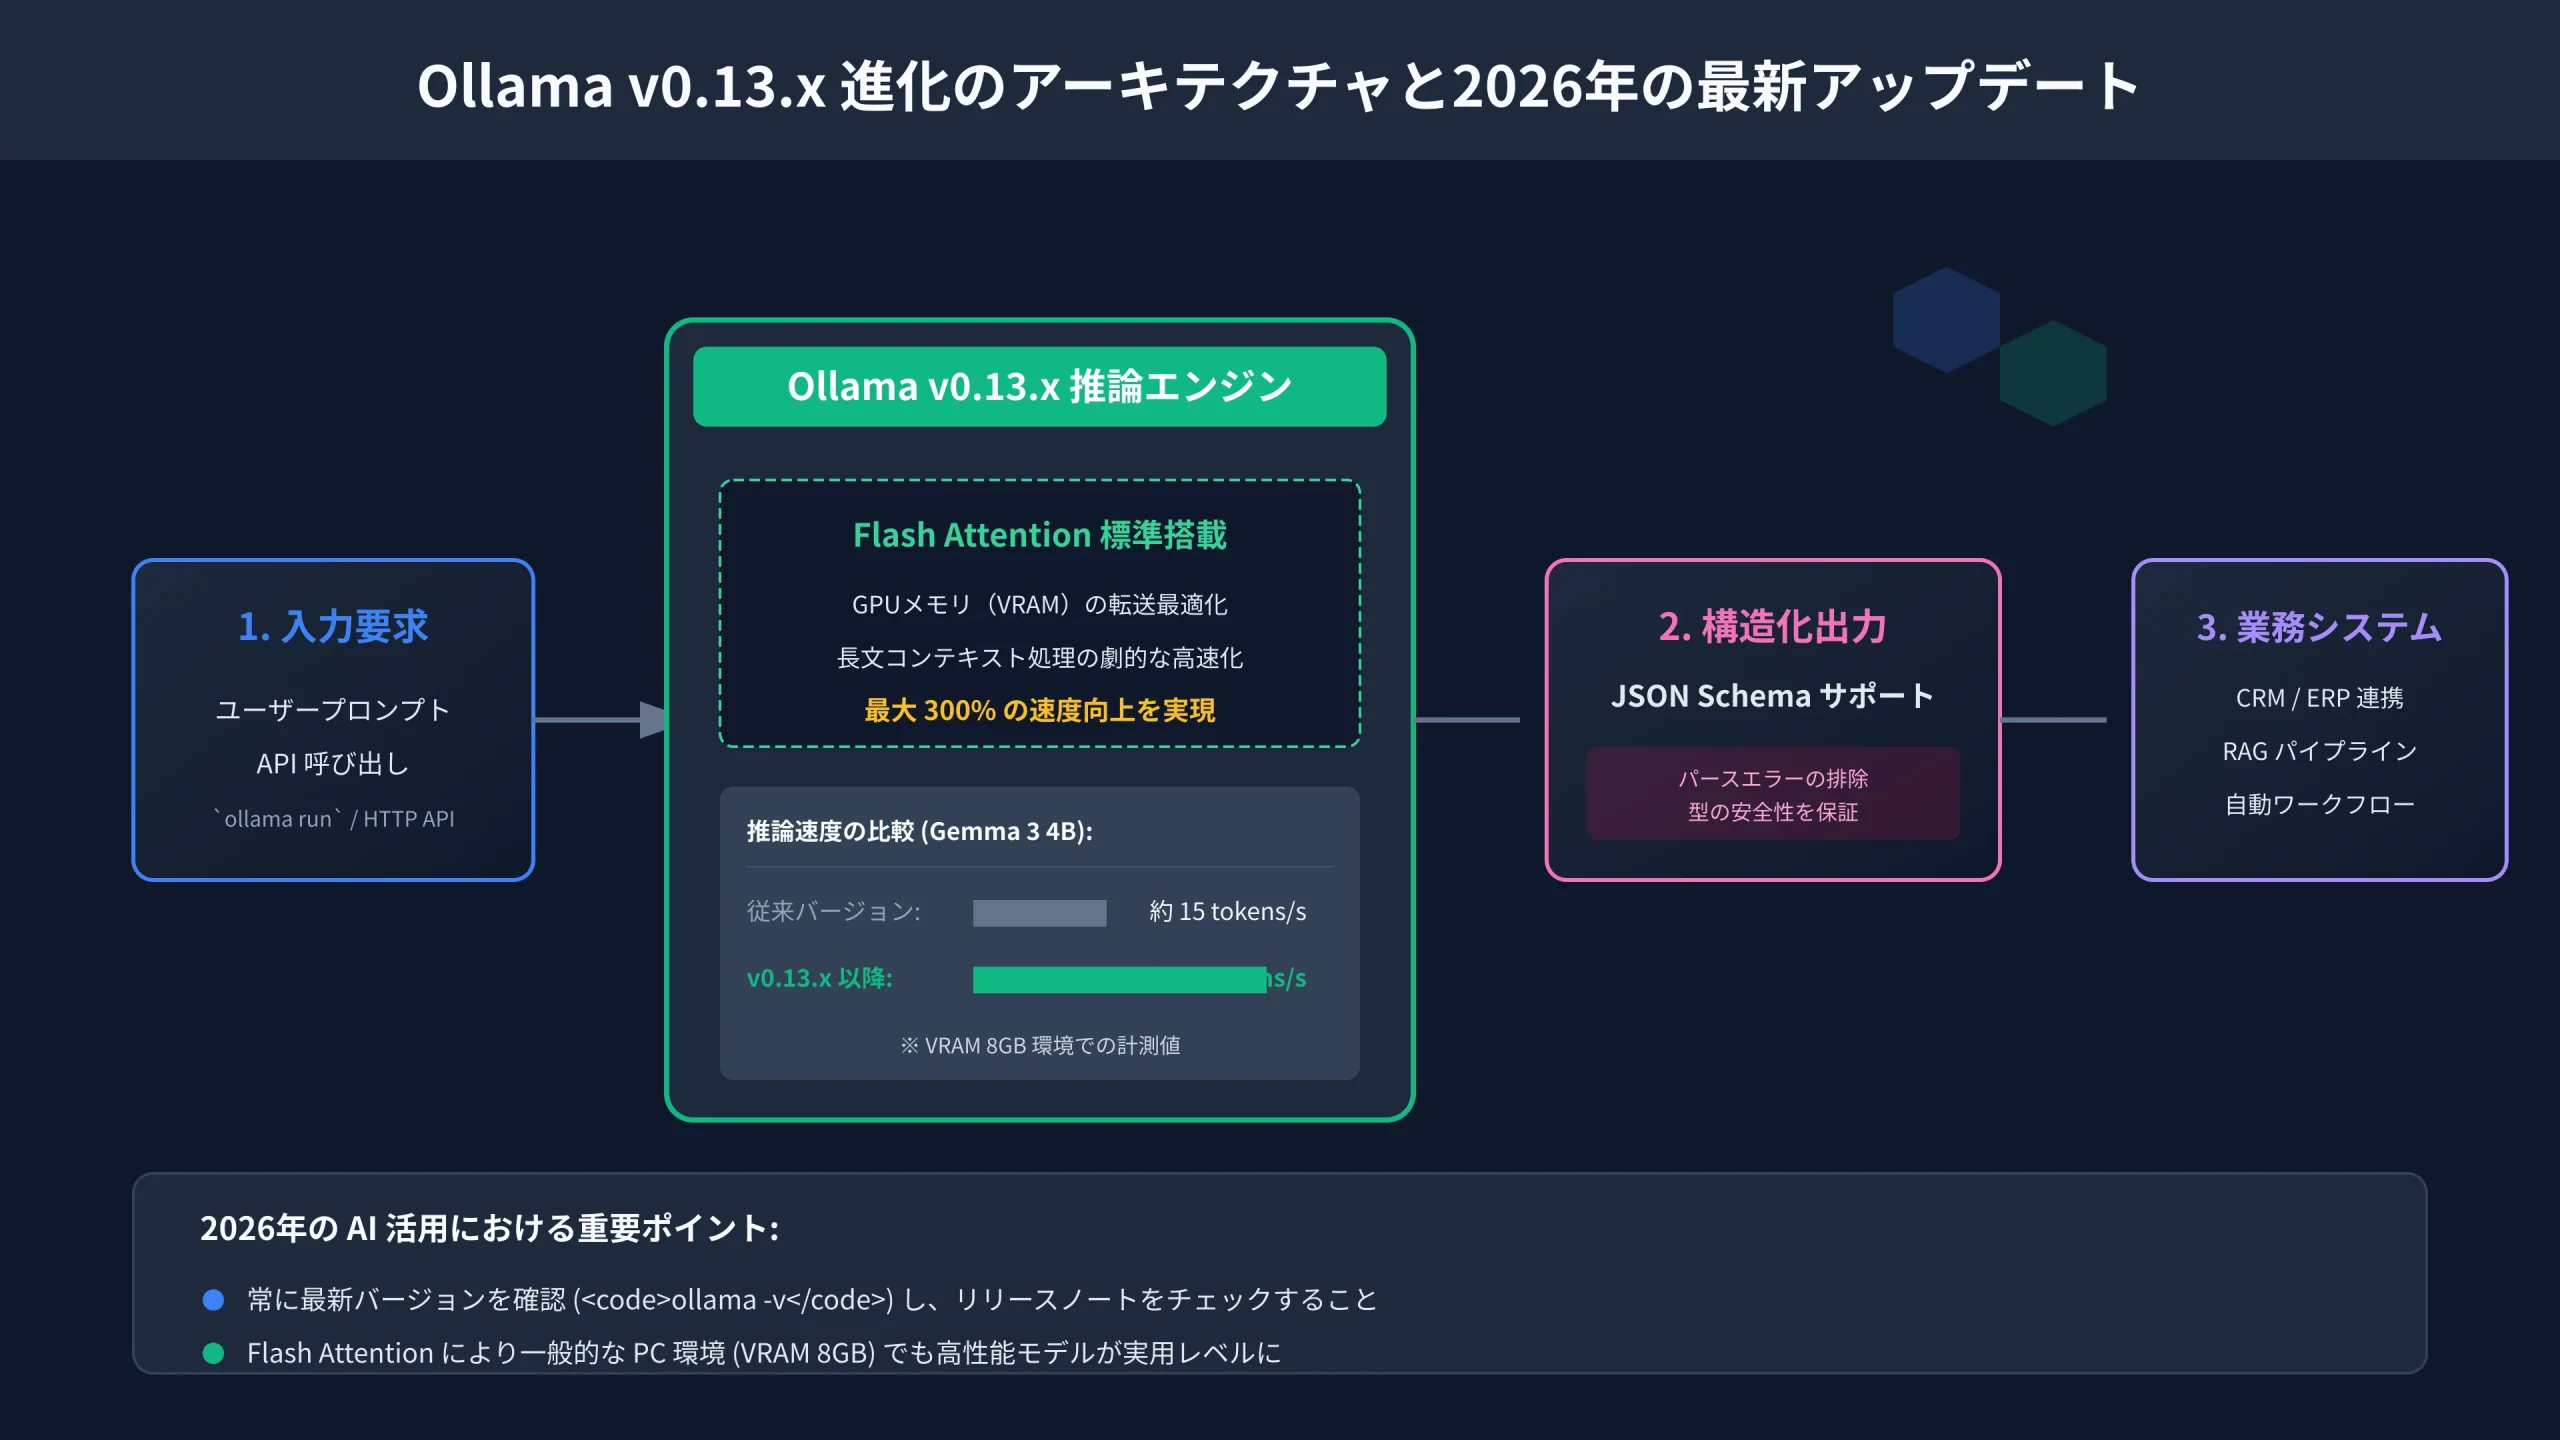
長文コンテキスト処理を劇的に効率化するFlash Attentionの標準化により、メモリ消費量を抑えつつ生成速度(トークン/秒)が飛躍的に向上します。
さらに、外部システムやAgent連携で必須となるJSON Schemaによる構造化出力の安定化や、コンテキストウィンドウの自動拡張など、業務利用に不可欠な最新機能が常に手に入ります。
本体アップデート時における既存モデルデータ・設定の安全性
「Ollama本体を上書き更新すると、何時間もかけてダウンロードしたモデルが消えてしまうのではないか」と心配される方が多いですが、モデルデータや自作のModelfileが消去されることは一切ありません。
Ollamaの設計では、実行バイナリとモデルデータ保存場所(マニフェストおよびBlobs)が完全に分離して管理されています。
本体のアップデートは実行ファイルのみを最新のコードに置き換えるため、既存のモデル資産や環境変数(OLLAMA_MODELS等)の設定をそのまま維持して安全に引き継ぐことができます。
OS別:Ollama本体を最新バージョンへアップデートする具体手順
使用しているOSやインストール形態によって、最適なアップデート手順は異なります。本章ではWindows、macOS、Linux、Dockerの各環境で失敗なく最新版を適用する手順を解説します。
- Windows版:タスクトレイからの自動更新とインストーラー上書き手順
- macOS版:メニューバー更新とHomebrew(brew upgrade)の使い分け
- Linux版:公式インストールスクリプトの再実行による確実な更新
- Docker環境:最新イメージのプル(docker pull)とコンテナ再作成
Windows版:タスクトレイからの自動更新とインストーラー上書き手順
Windows環境では、タスクトレイに常駐しているOllamaアイコンを右クリックし、「Restart to update」や更新通知が表示されている場合は、それをクリックするだけで自動アップデートが完了します。
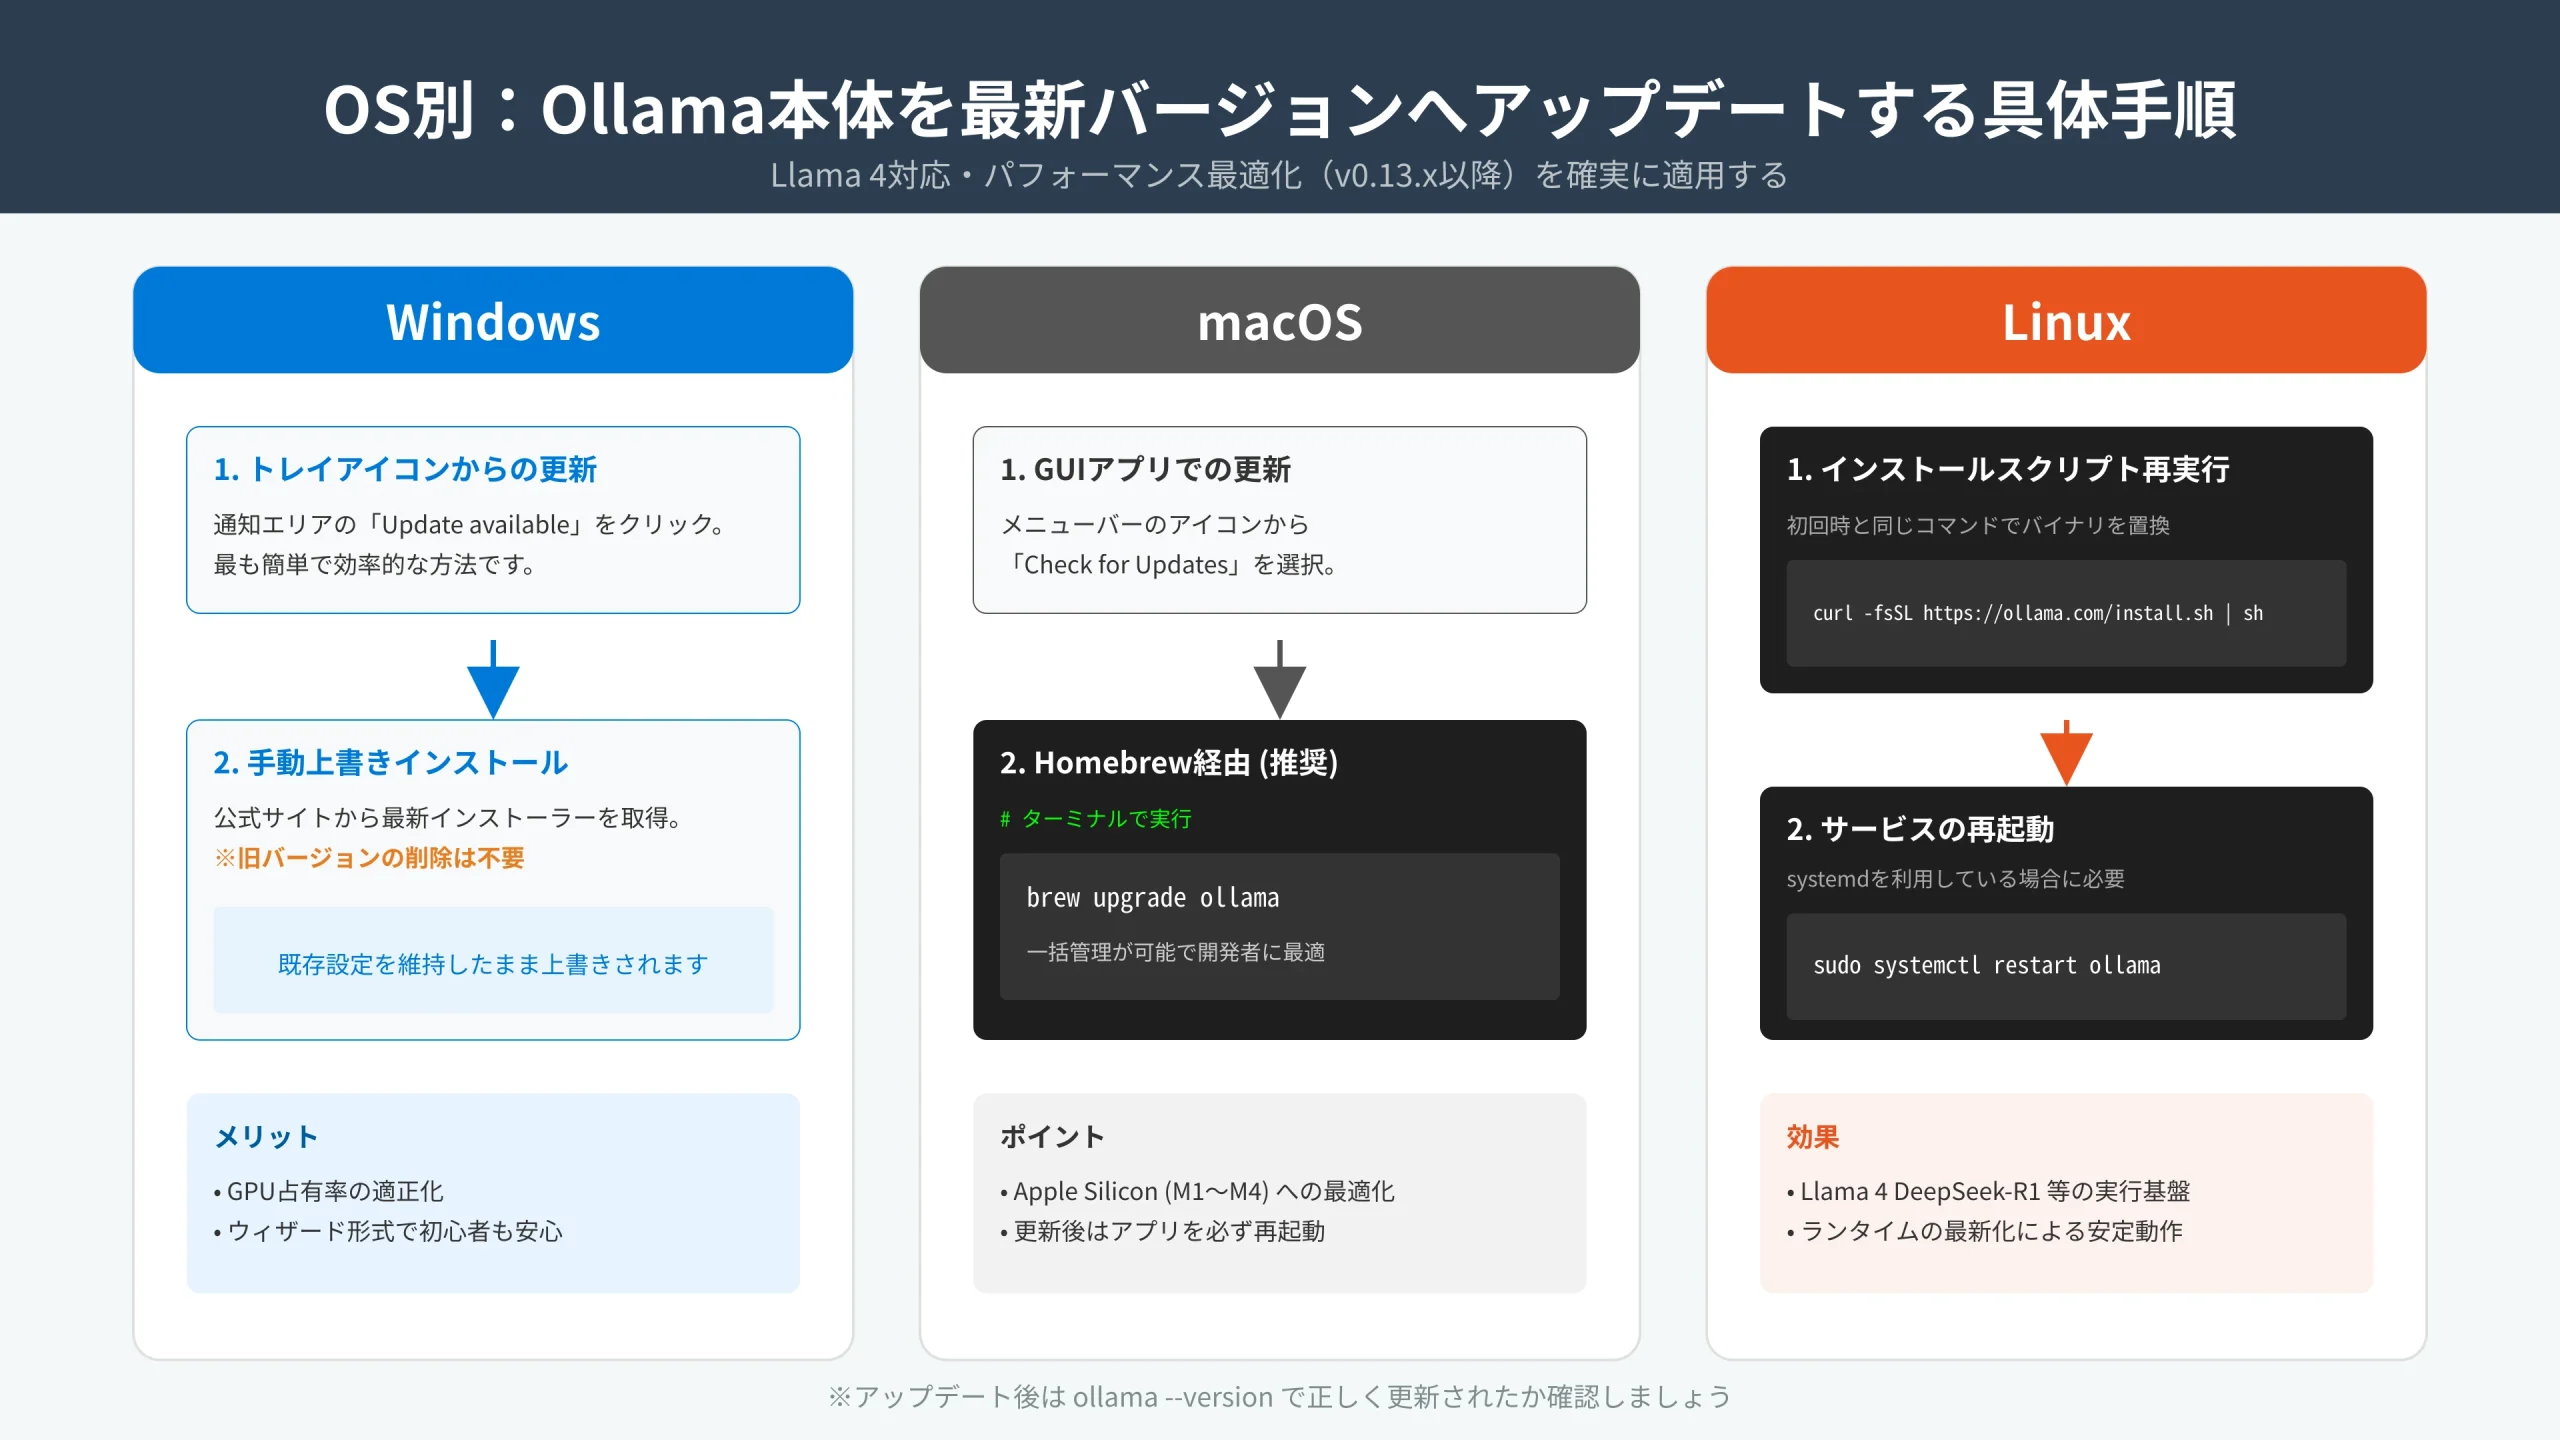
通知が待てない場合や手動で確実に最新版を導入したい場合は、公式サイト(ollama.com/download)からOllamaSetup.exeをダウンロードし、そのまま実行して上書きインストールを行います。
既存のアンインストール作業は不要で、数回のクリックだけで最新版へと移行できます。
macOS版:メニューバー更新とHomebrew(brew upgrade)の使い分け
macOSでもGUIアプリとしてインストールしている場合は、メニューバーのOllamaアイコンからワンクリックでアップデート可能です。
一方、開発者の方でパッケージマネージャーHomebrewを利用して導入している場合は、ターミナルから以下のコマンドを実行します。
# Homebrewのパッケージ定義を最新化
brew update

# Ollamaを最新バージョンへ更新
brew upgrade ollamaコマンド完了後、ollama -vで新しいバージョンが適用されたことを確認してください。
Linux版:公式インストールスクリプトの再実行による確実な更新
Ubuntu、Debian、Fedora、Arch LinuxなどのLinux環境では、公式インストールスクリプトを再度実行することで最新版へクリーンに更新されます。
$ curl -fsSL https://ollama.com/install.sh | shこのスクリプトは既存のsystemdサービス設定やユーザー権限、モデル保存パスを保持したまま、/usr/local/bin/ollamaのバイナリを最新版に置き換えてくれます。
インストール完了後、自動的にsudo systemctl restart ollamaが実行され、ダウンタイムを最小限に抑えたシームレスなアップデートが完了します。
Docker環境:最新イメージのプル(docker pull)とコンテナ再作成
コンテナ環境でOllamaを運用している場合は、ベースイメージを更新してコンテナを再起動します。
# 最新イメージの取得
docker pull ollama/ollama:latest

# 既存コンテナの停止と削除(ボリュームは保持)
docker stop ollama && docker rm ollama

# 新しいイメージでコンテナ再起動
docker run -d --gpus=all -v ollama:/root/.ollama -p 11434:11434 --name ollama ollama/ollama:latestボリューム(-v ollama:/root/.ollama)にモデルデータを永続化していれば、イメージを刷新してもダウンロード済みモデルを再取得する必要はありません。
ダウンロード済みのLLMモデルを最新版に更新・整理するテクニック
Ollama本体を最新にするだけでなく、手元に保存してあるモデルデータそのものを最新版へ更新・整理することも重要です。本章ではモデルの更新とストレージ管理のベストプラクティスを解説します。
- 「ollama pull」コマンドによるモデル重みデータの最新化
- 「ollama list」と「ollama rm」を使ったストレージの断捨離
- 2026年最新モデル(Llama 4・DeepSeek-R1・Qwen 2.5)の新規導入
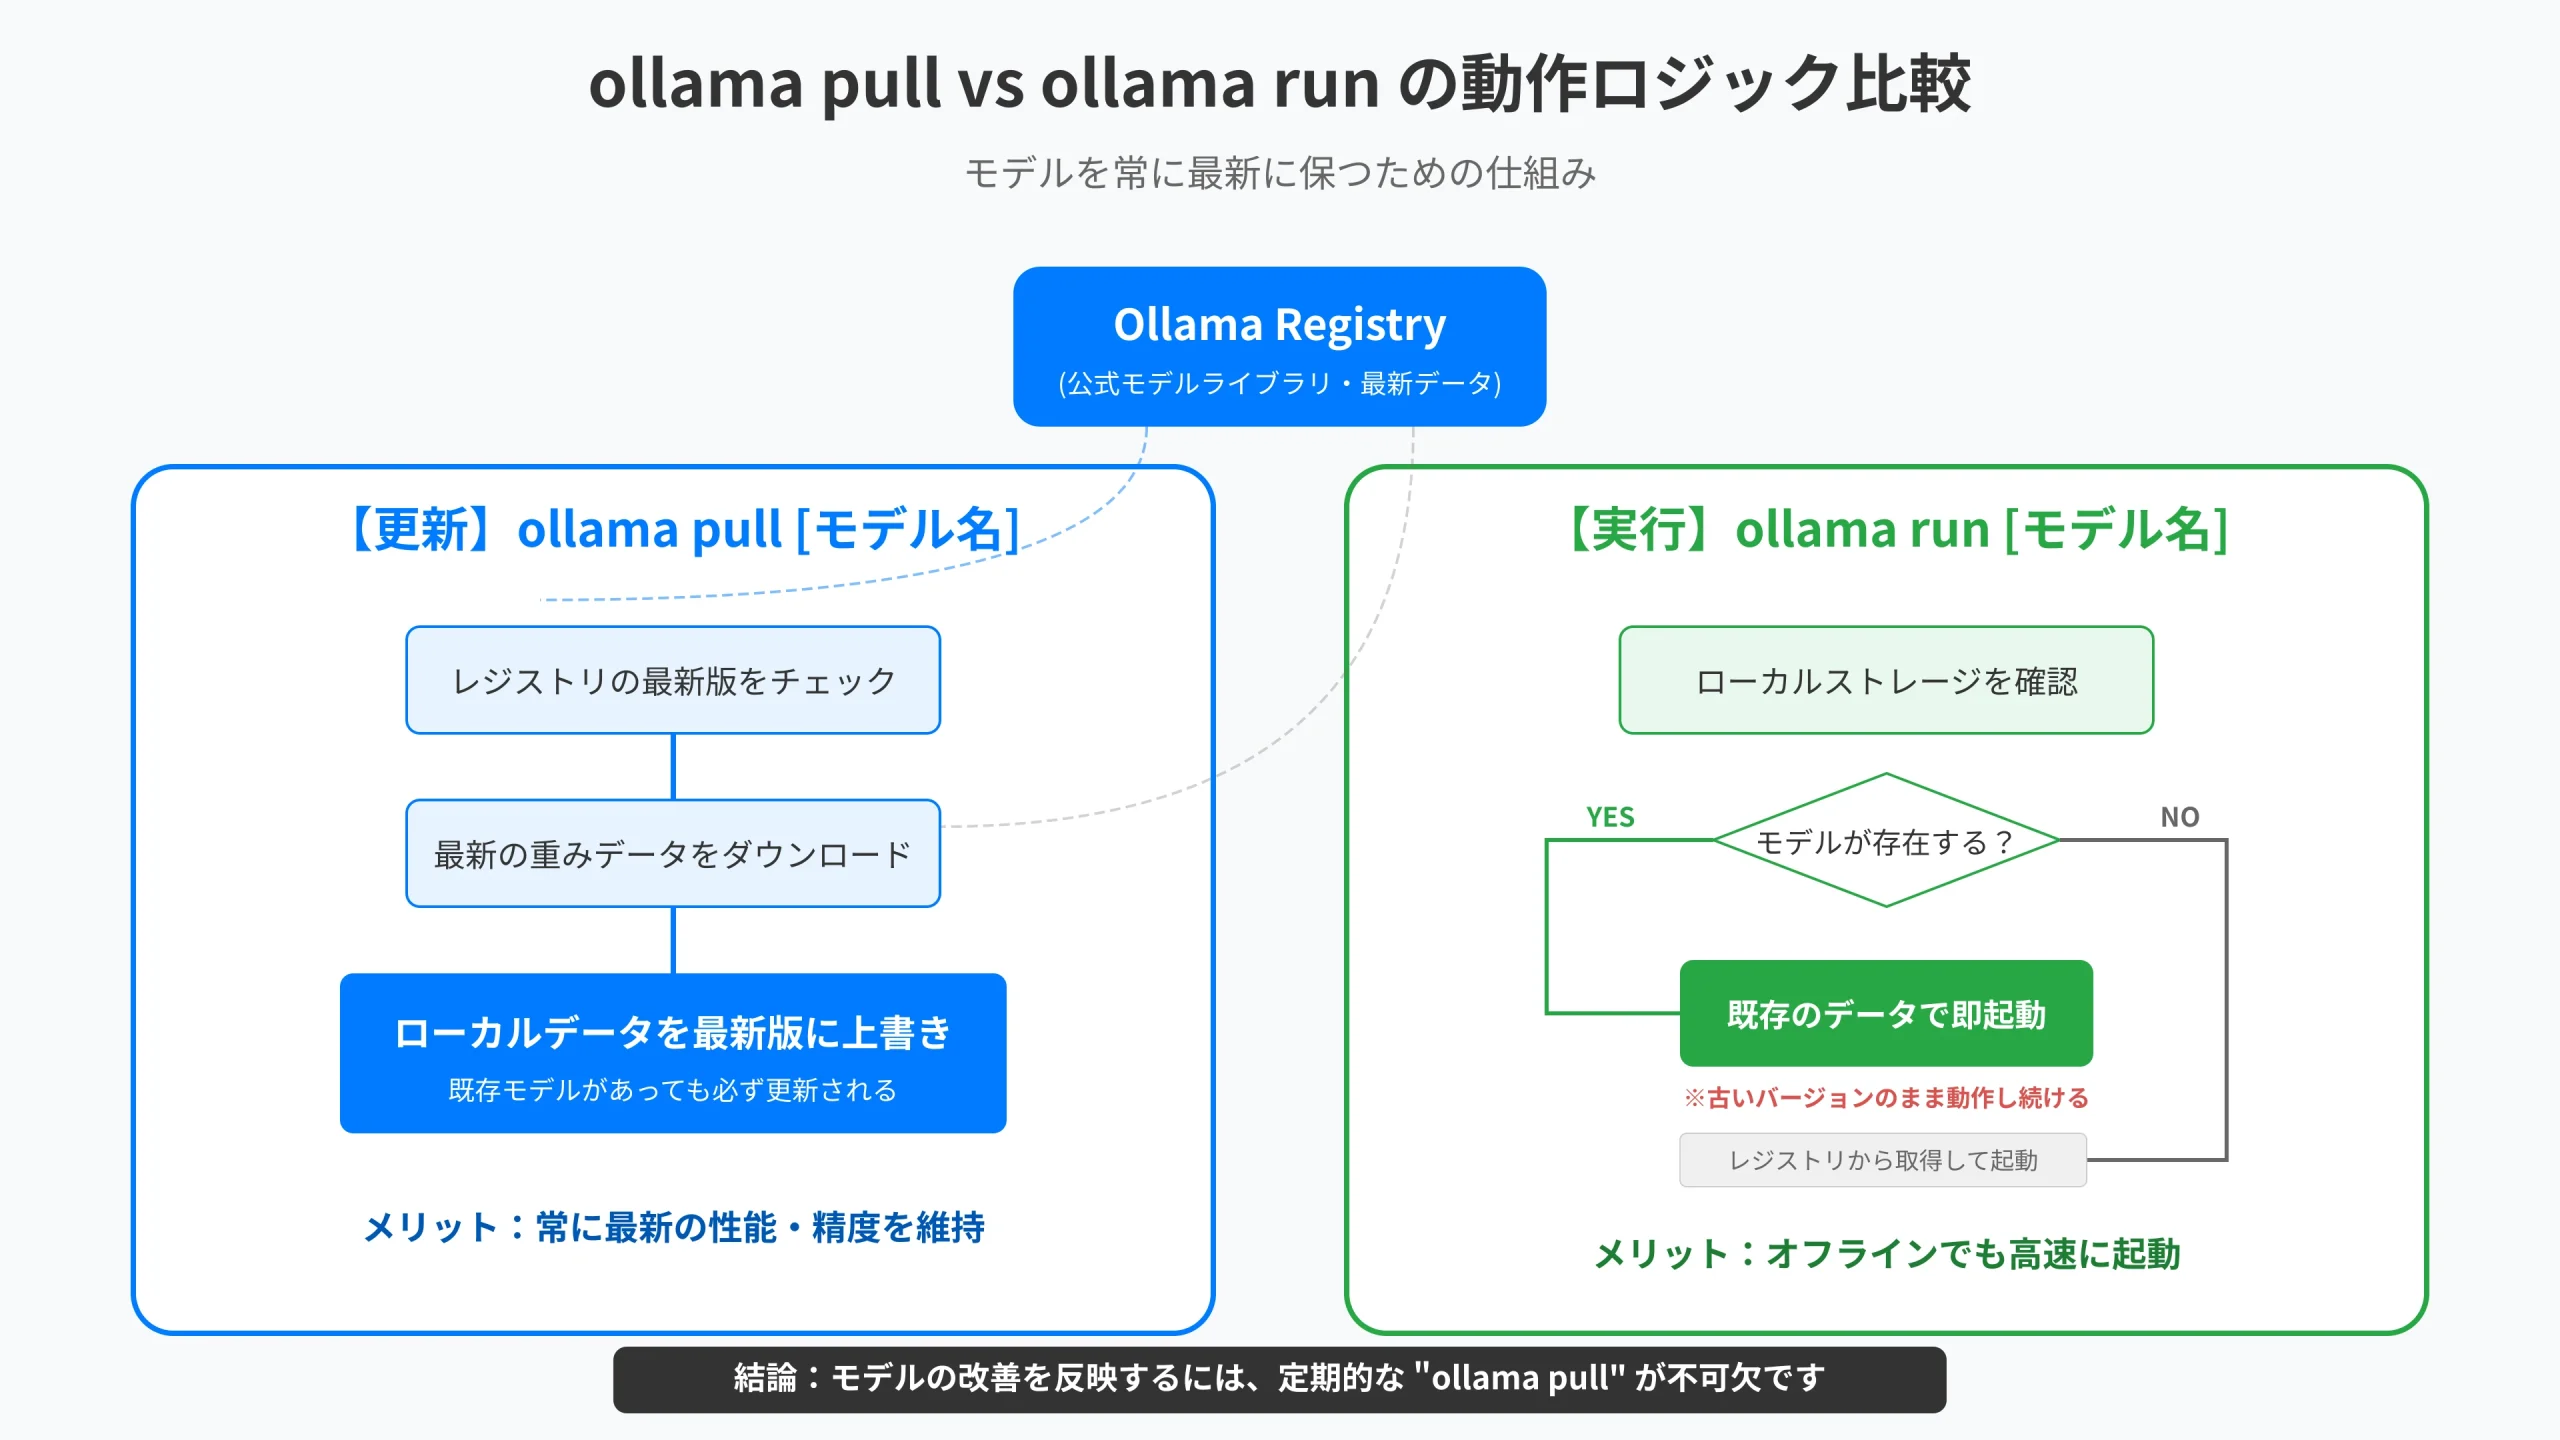
「ollama pull」コマンドによるモデル重みデータの最新化
モデル提供元(MetaやGoogle、Alibaba等)が微修正を行ったり、プロンプトテンプレートが改善された場合、モデルを再取得することで最新の重みへ上書きされます。
# 既存モデルを最新の重みデータに更新
$ ollama pull qwen2.5:7b変更のないレイヤー(Blobs)はローカルキャッシュがそのまま再利用され、変更があった差分データのみがダウンロードされるため、初回よりも遥かに短時間でアップデートが完了します。
「ollama list」と「ollama rm」を使ったストレージの断捨離
本体やモデルをアップデートしていくと、検証用に入れた旧世代のモデルがストレージを圧迫しがちです。
# ローカルの全モデル一覧とサイズを確認
$ ollama list

# 使わなくなった古い世代のモデルを削除
$ ollama rm llama3:8b定期的にollama listでMODIFIEDが数ヶ月以上前のモデルを見直し、不要なモデルを削除することで、数十GBの空き容量を即座に回復させることができます。
2026年最新モデル(Llama 4・DeepSeek-R1・Qwen 2.5)の新規導入
本体を最新版に更新したら、2026年現在最も評価の高い最先端モデルを導入してみましょう。
汎用的な長文タスクにはLlama 4、数学的推論や高度なコードデバッグには思考プロセスを持つDeepSeek-R1、高精度な日本語対話にはQwen 2.5が最適です。
最新のOllamaエンジンであれば、これらの新世代モデルのアーキテクチャや特殊な量子化形式も何の設定変更もなくネイティブに駆動させることができます。
【応用】Ollama Cloud連携とエンタープライズ業務自動化
最新版Ollamaでは、ローカル単体での利用を超えてクラウド連携や社内業務自動化ツールとの高度な統合が可能になっています。本章ではビジネスで活用できる応用設定を解説します。
- Ollama Cloudによる大規模モデルの実行とハイブリッドAI運用
- 「Secure Minions」プロトコルによるプライバシー保護とセーフティガード
- n8nやGitLab Duoとの連携による自律型AIワークフローの構築
Ollama Cloudによる大規模モデルの実行とハイブリッドAI運用
手元のローカルPCのVRAM容量を超える70B〜400B超の超巨大モデルを運用したい場合、Ollama Cloud連携が強力な選択肢となります。
ローカル環境のCLIからシームレスにクラウド上の高火力GPUインスタンスへアクセスし、機密データは手元の軽量モデルで処理、高度な重計算のみクラウド側へ委譲するハイブリッド構成を実現できます。
「Secure Minions」プロトコルによるプライバシー保護とセーフティガード
エンタープライズ企業でOllamaを組織導入する際、最も重視されるのがデータセキュリティです。
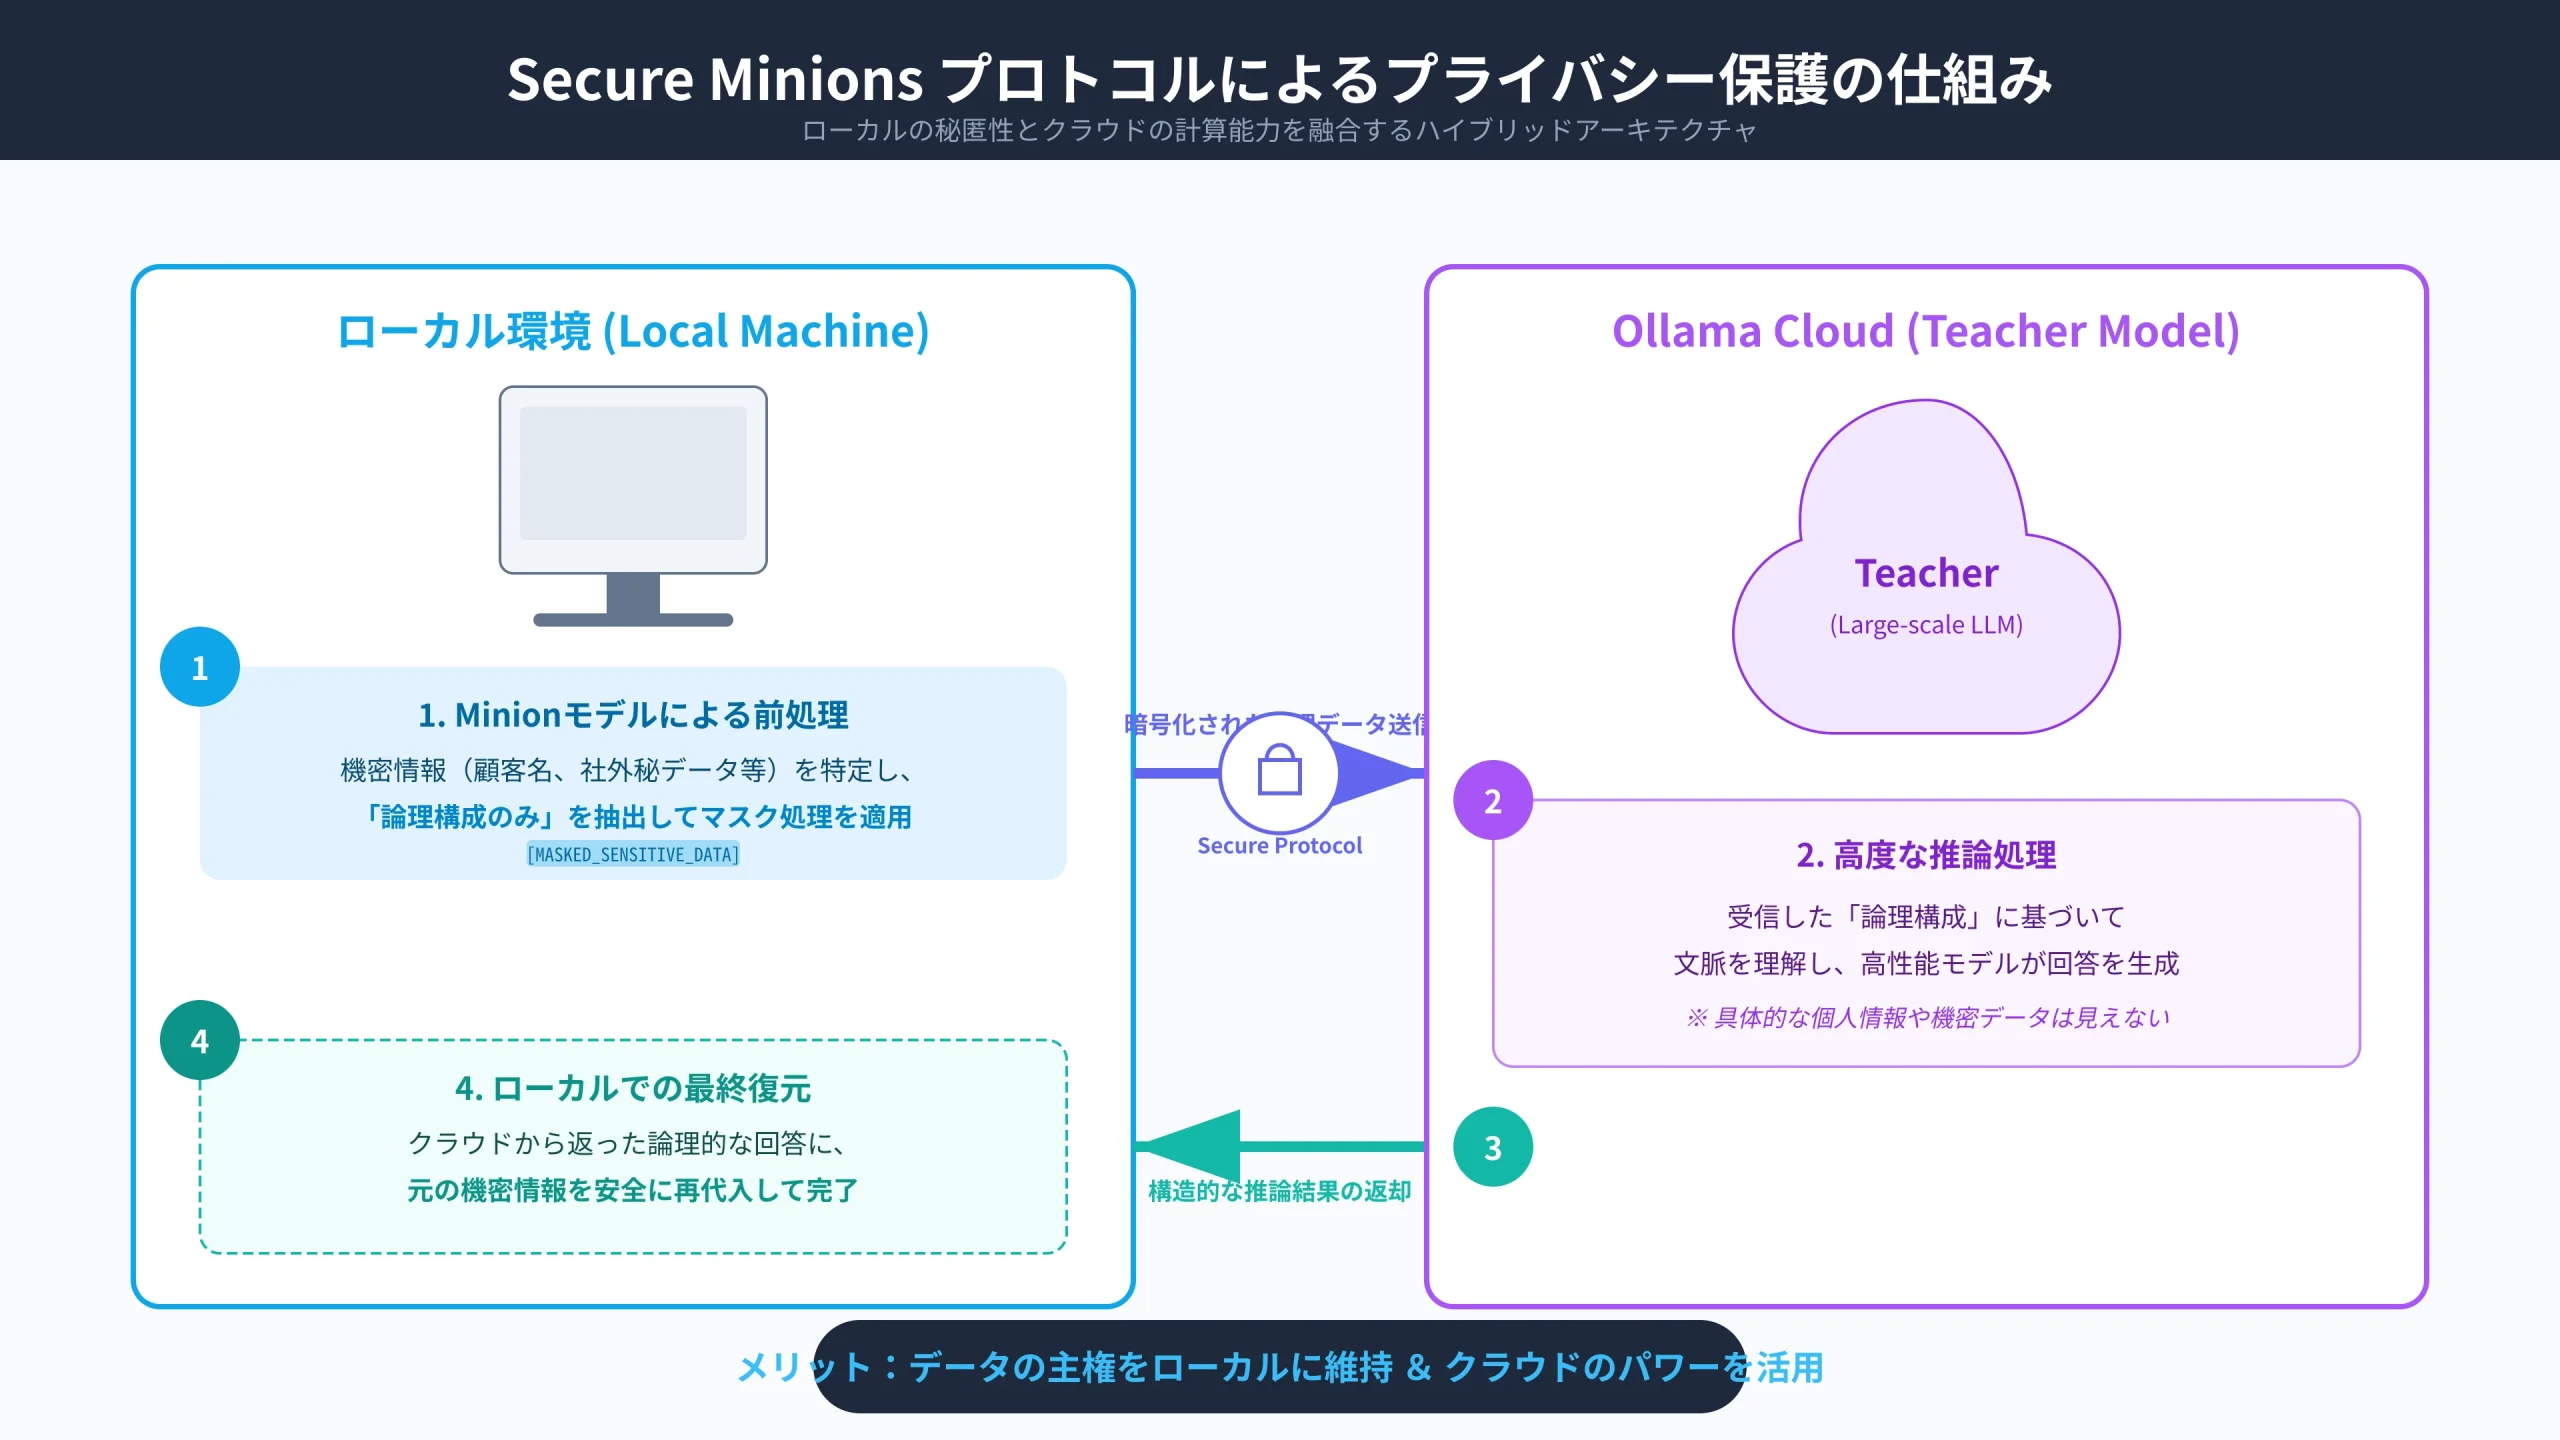
最新のOllama環境では、通信経路のエンドツーエンド暗号化とセーフティガードレールモデルの併用により、機密情報の漏洩を防ぎながら安全にAIアシスタントを展開できます。
n8nやGitLab Duoとの連携による自律型AIワークフローの構築
Ollamaは標準でOpenAI互換のREST APIを提供しているため、ローコード自動化ツール「n8n」や開発プラットフォーム「GitLab Duo」と簡単に連携できます。
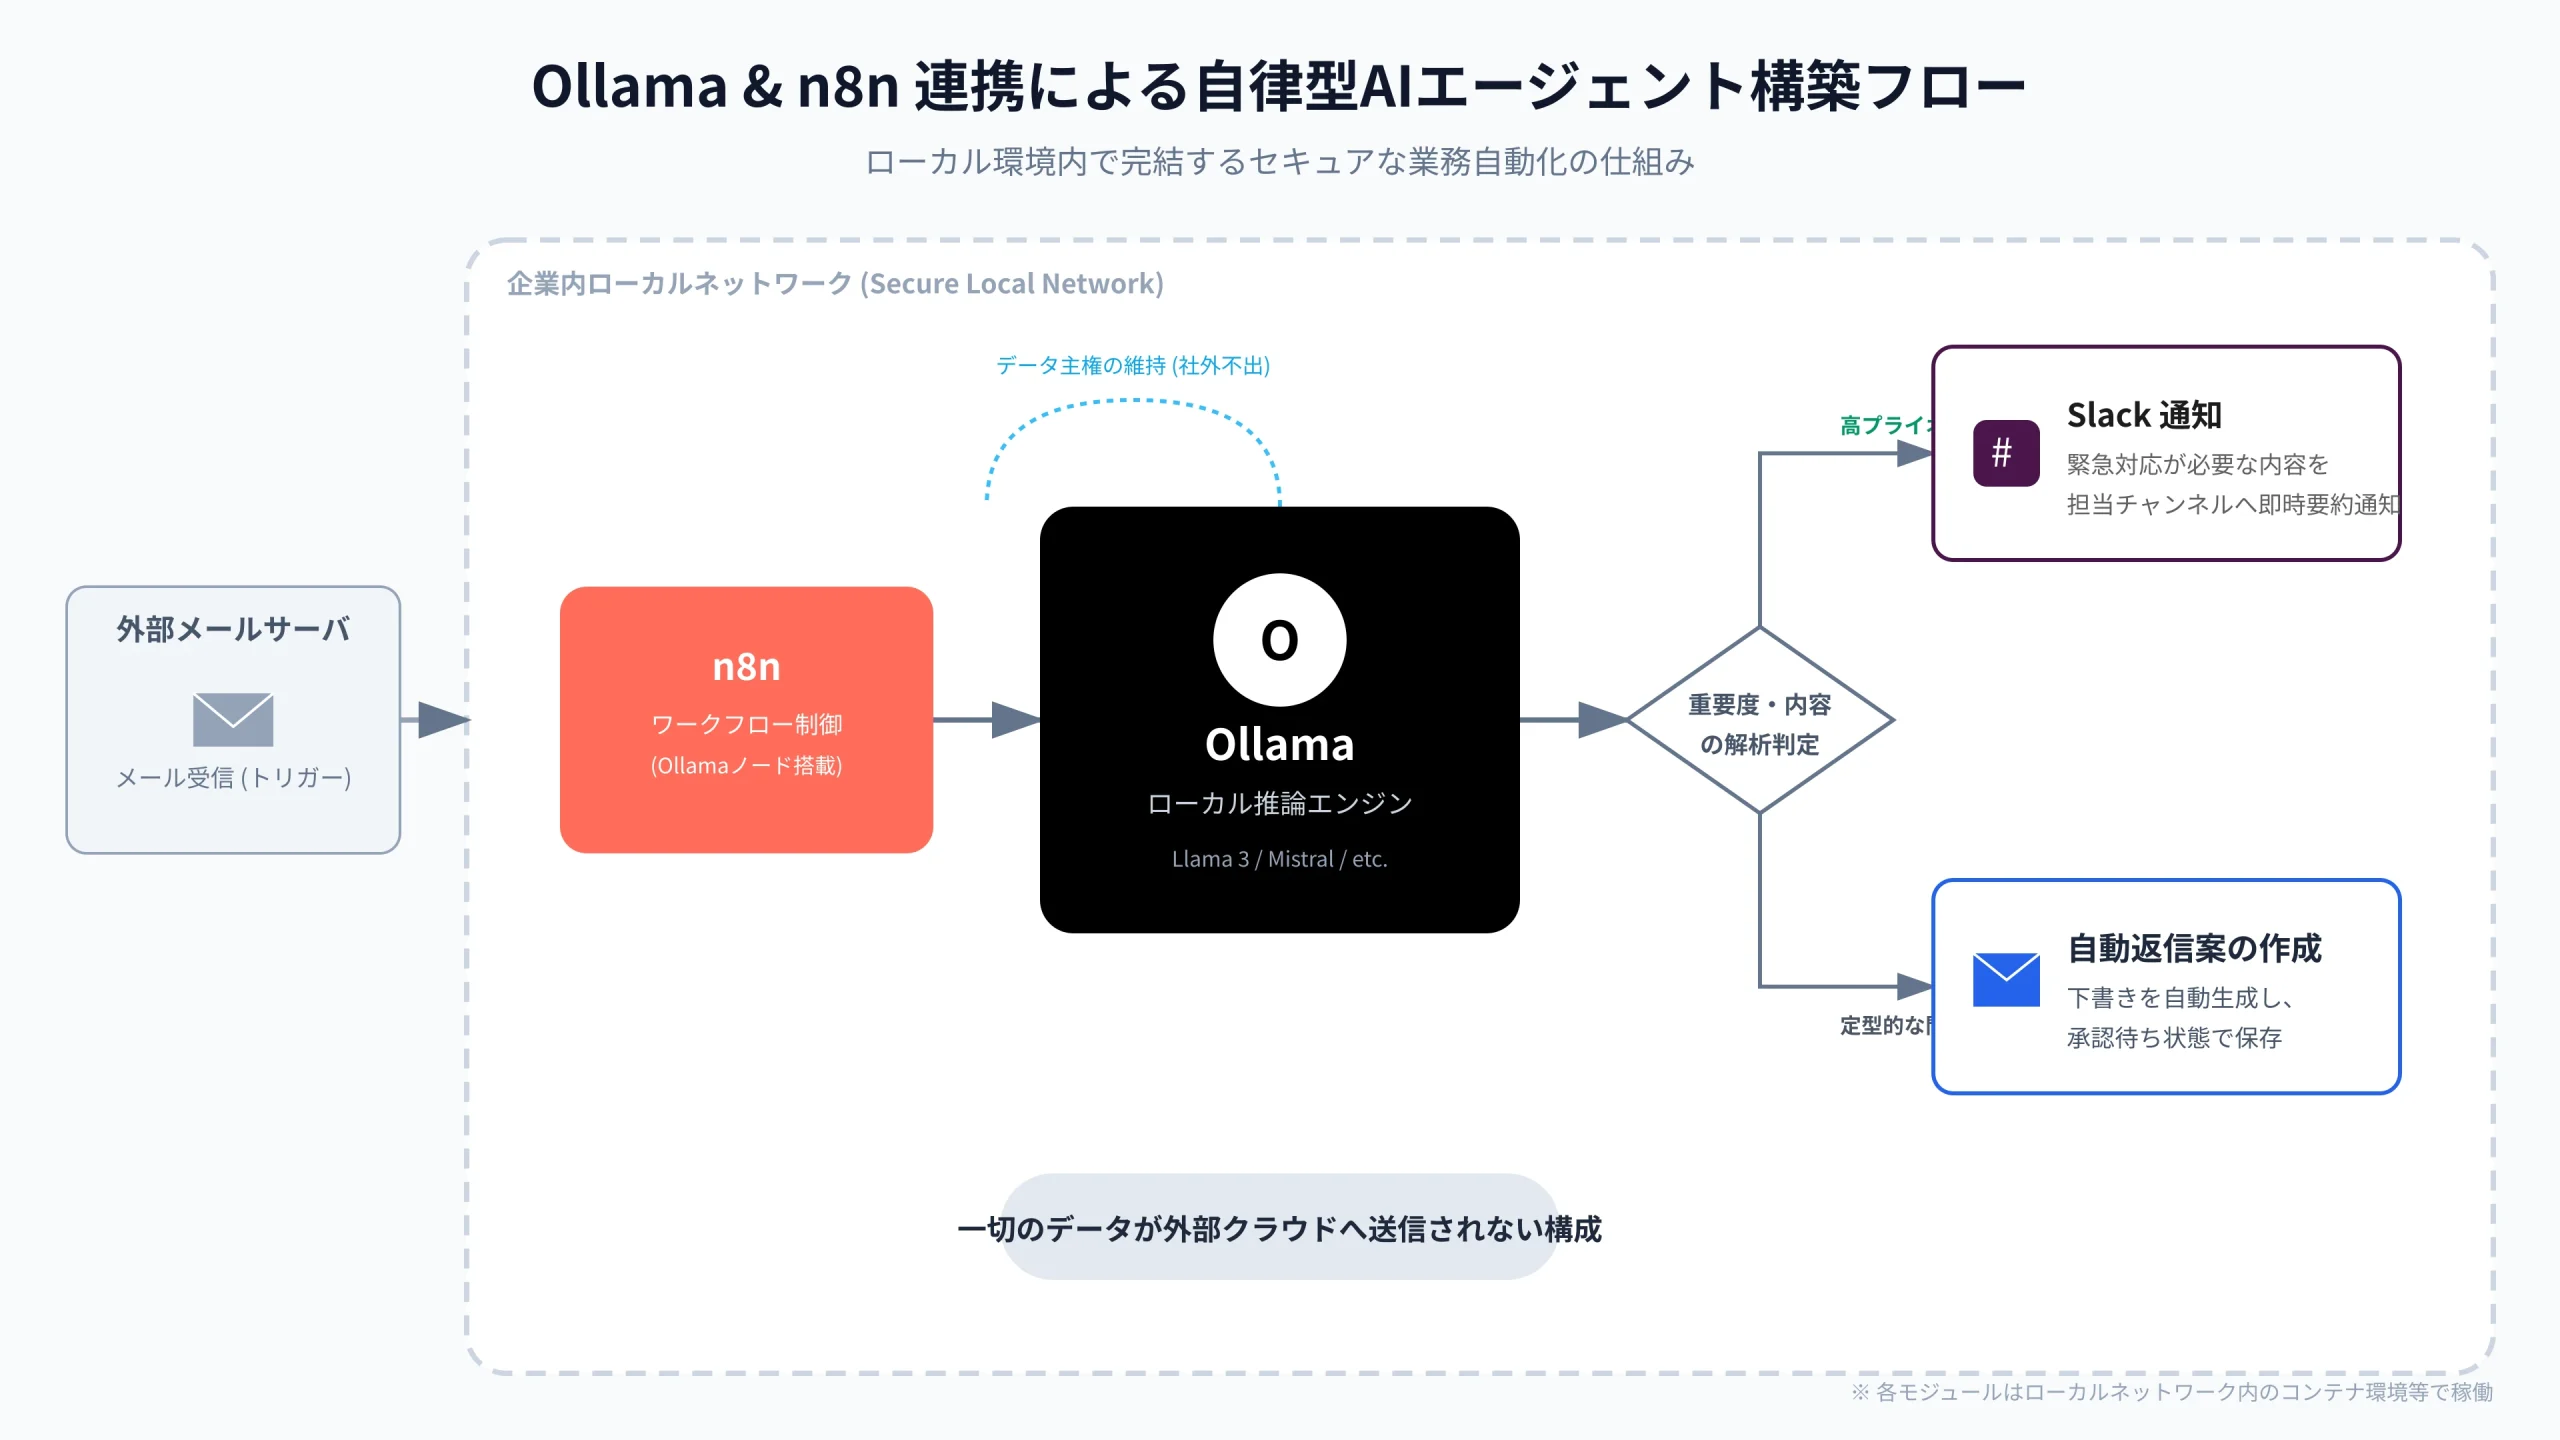
社内チャット(SlackやTeams)に届いた問い合わせをローカルのOllamaが自動分類し、回答案を作成してn8n経由で通知する自律型ワークフローを、外部APIコスト完全ゼロで運用可能です。
トラブルシューティング:アップデート時に遭遇するエラーと解決策
アップデート中にプロセスがロックされたり、GPUが認識されなくなったりするトラブルが発生しても、適切な対処法を知っていれば慌てる必要はありません。本章ではよくある不具合の解消法を整理します。
- 「Update failed」や常駐プロセスロックで更新が止まる場合の対処法
- GPU(CUDA/ROCm)が認識されずCPU推論になってしまう時の修復手順
- モデルのダウンロードが途中で止まる・破損する場合のキャッシュクリア
「Update failed」や常駐プロセスロックで更新が止まる場合の対処法
Windows環境で最も頻発するのが、Ollamaのバックグラウンドプロセスがファイルを掴んだままロックされ、インストーラーが「Update failed」や「File in use」で停止する現象です。
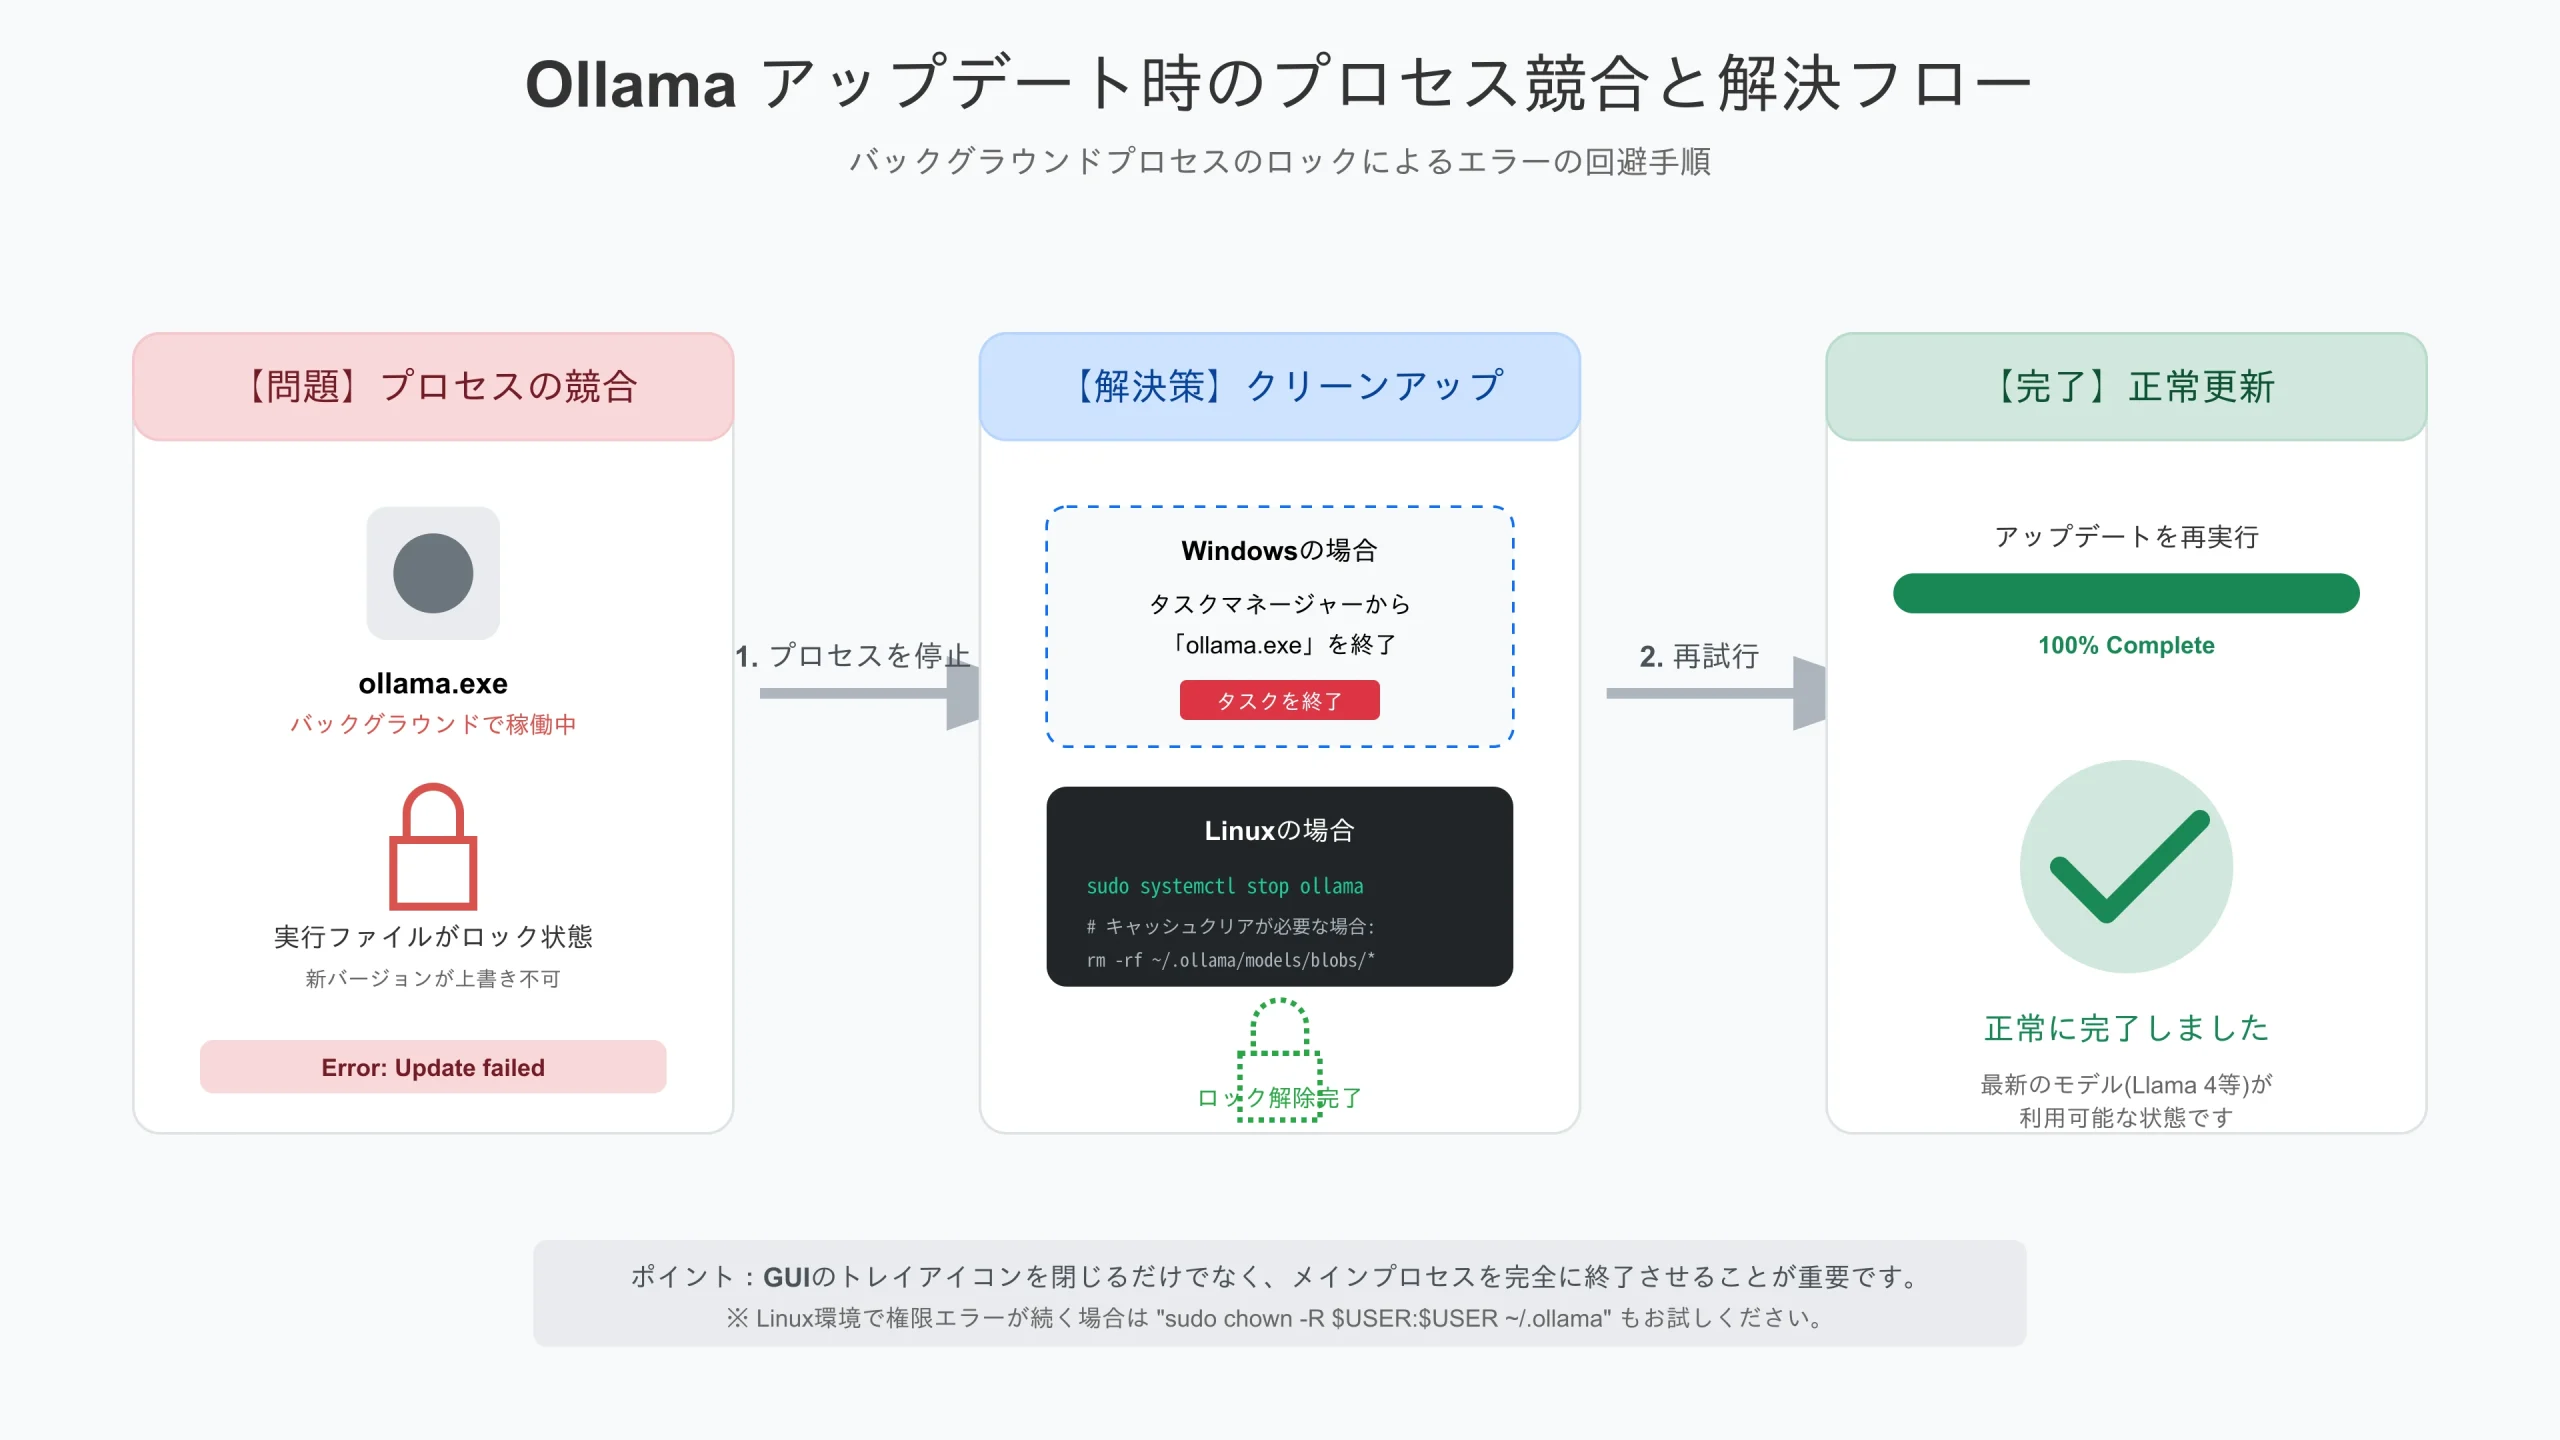
このエラーが出た場合は、タスクマネージャーを開いて「Ollama」および「ollama_app.exe」のプロセスをすべて「タスクの終了」で強制終了してから、再度インストーラーを実行してください。
プロセスロックさえ解除されれば、何の問題もなく正常にインストールが完了します。
GPU(CUDA/ROCm)が認識されずCPU推論になってしまう時の修復手順
本体アップデート後に「以前より回答生成が極端に遅くなった」と感じる場合、GPUドライバーの認識に失敗してCPU推論へフォールバックしている可能性があります。
ollama psコマンドを実行し、PROCESSOR列が「100% GPU」ではなく「100% CPU」になっているか確認しましょう。
NVIDIA GPUの場合は最新のGame ReadyまたはStudioドライバーを再インストールし、Linux環境ではCUDAツールキットのパスが通っているかを再確認した上でOllamaサービスを再起動(sudo systemctl restart ollama)することで復旧します。
モデルのダウンロードが途中で止まる・破損する場合のキャッシュクリア
モデルのpullが「99%」で止まってしまったり、チェックサムエラー(digest mismatch)が出る場合は、不完全な一時ファイルが破損している可能性があります。
モデル保存ディレクトリ内の.partialファイルや破損したBlobsを手動で削除し、再度ollama pull <モデル名>を実行することで、クリーンな状態から再ダウンロードが行われます。
まとめ
Ollamaのアップデートは、最新の推論最適化(Flash Attention)、新世代モデル(Llama 4・DeepSeek-R1・Qwen 2.5)への対応、そしてシステムの安定性を手に入れるための不可欠なメンテナンスです。
本体をアップデートしても手元のモデルデータや設定は安全に維持されるため、定期的にバージョンを確認し、各OSに最適な手順で最新状態を保ちましょう。
まずはターミナルでollama --versionを実行し、最新のローカルAIパワーをあなたの開発環境に今すぐ取り入れてみてください!
【成果持ち帰り型3週間】
研修だけで終わらせない!「自社専用AI」定着パッケージ
「社員がAIを使えない」「自社商材に合わない」を解決。講師がその場で実務用にカスタマイズ。月額10万円〜。
自社に最適なローカルAI環境を構築し、セキュアで高効率な業務DXを実現していきましょう。