(最終更新日: 2026年08月28日)
「社内FAQや業務マニュアルをRAG化して業務効率化を図りたいが、ハルシネーションが多くて実用に耐えない」「AIアプリの構築やワークフロー自動化をノーコードで一気通貫に実現したい」とお悩みではありませんか?
2026年現在、AI開発プラットフォーム『Dify』は、単なるプロンプト作成ツールを超えて、エンタープライズ企業の業務効率化を根底から支える統合BaaS(Backend-as-a-Service)基盤へと進化しました。
リランキングやParent-Child階層チャンクによるRAGの精度向上、マルチエージェント協調ワークフロー、Claude 3.7 SonnetやGPT-5.6の柔軟な使い分けにより、実務に直結するAIアプリを最短即日で本番稼働させられます。
本記事では、Difyのコアアーキテクチャから、RAG精度を極限まで高める設計、複雑な業務フローの自動化、エンタープライズ導入時のガバナンス・セキュリティ要件までプロの視点で徹底解説します。
この記事を読めば、自社の業務プロセスをAIで劇的に効率化し、失敗しない全社展開ロードマップを確実に描き出せるようになります!
Difyとは何か:LLMOps時代の「Backend-as-a-Service」的ポジションを整理する
当セクションでは、Difyが提供するLLMOps統合機能とBaaSとしての全体像を解説します。
従来のノーコードツールとの根本的な違いを理解することで、システム設計の無駄を排除できるからです。
なぜ今「LLMOpsプラットフォーム」が必要とされるのか
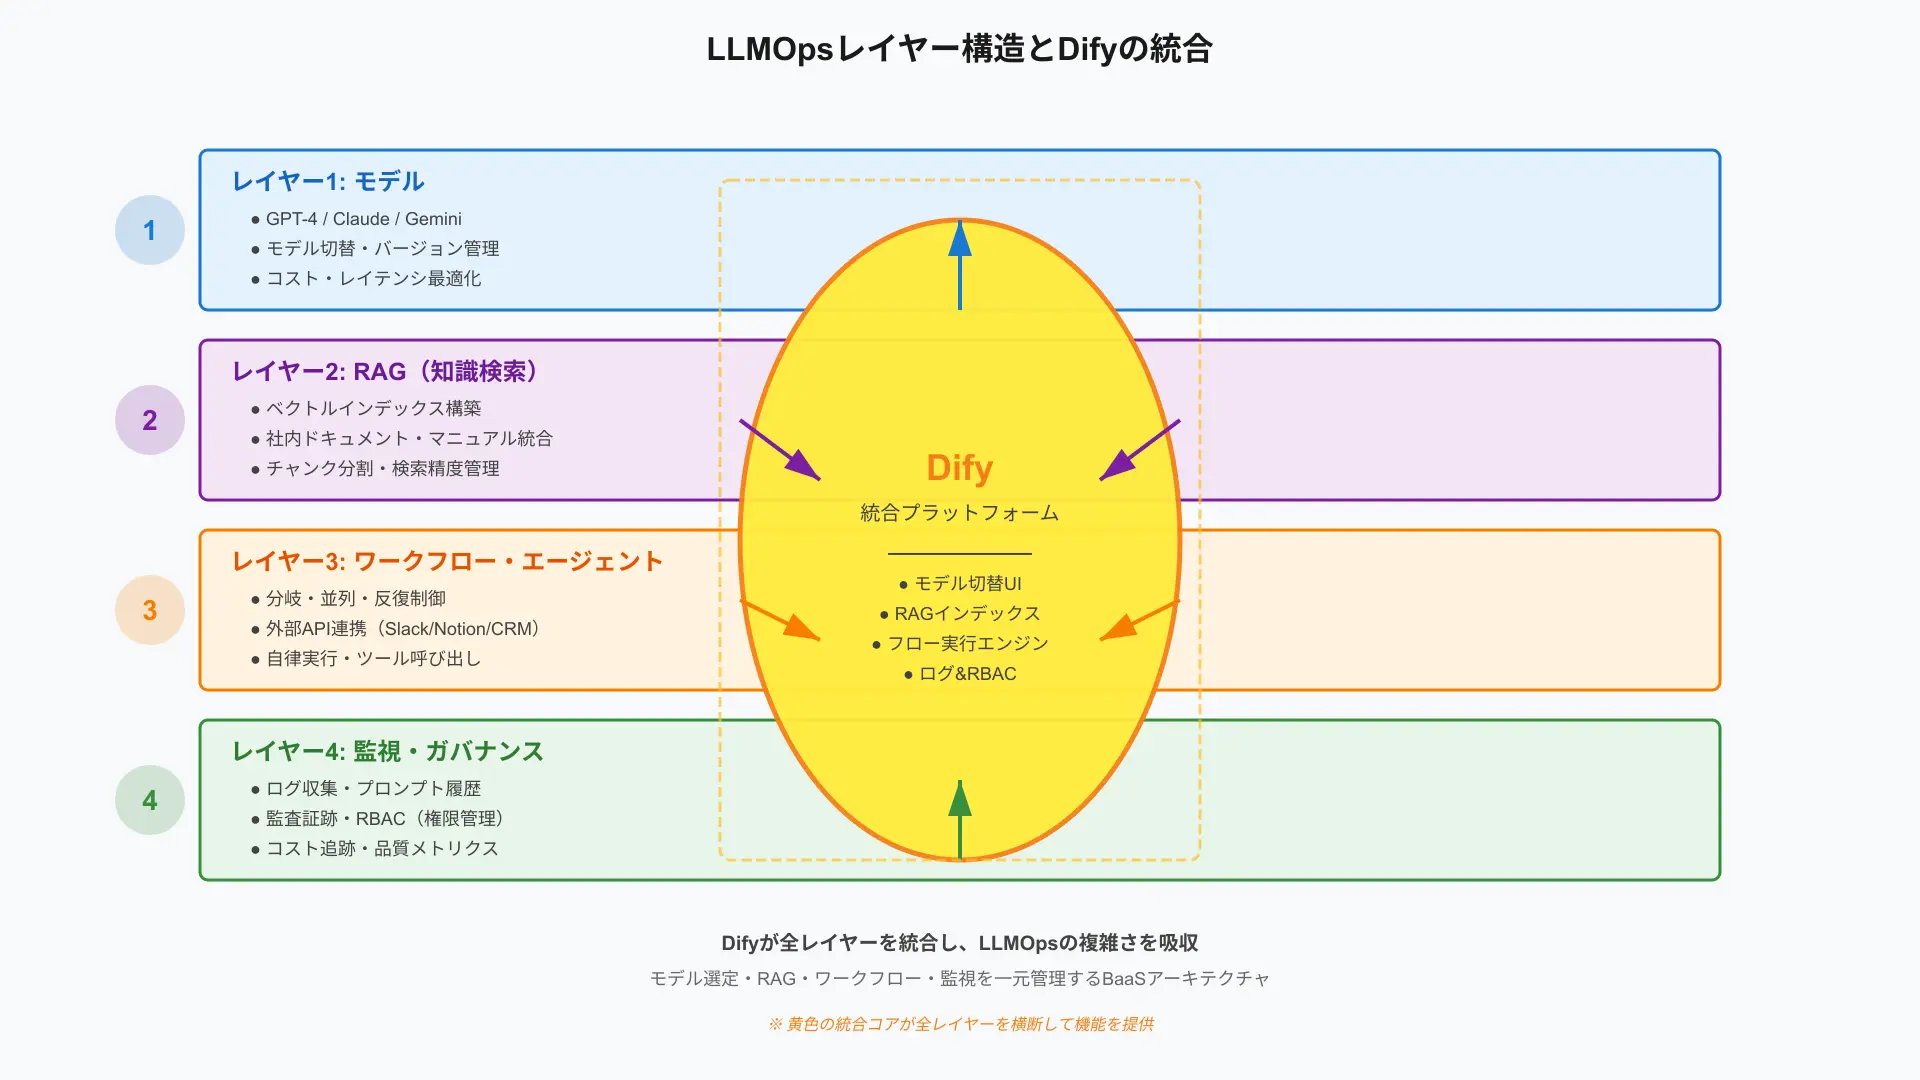
LLMを業務システムへ組み込むには、プロンプトのバージョン管理、ベクトルDBの構築、ログ監視など膨大な周辺インフラ開発が必要です。
これらの運用基盤をゼロから内製すると、開発期間が数ヶ月単位で長期化し、メンテナンスコストが肥大化します。
Difyを導入することで周辺レイヤーの開発工数を90%削減し、真に価値のある業務ロジックの改善だけに集中できます。
ノーコードツールではなく「AIアプリ用BaaS」としての特徴
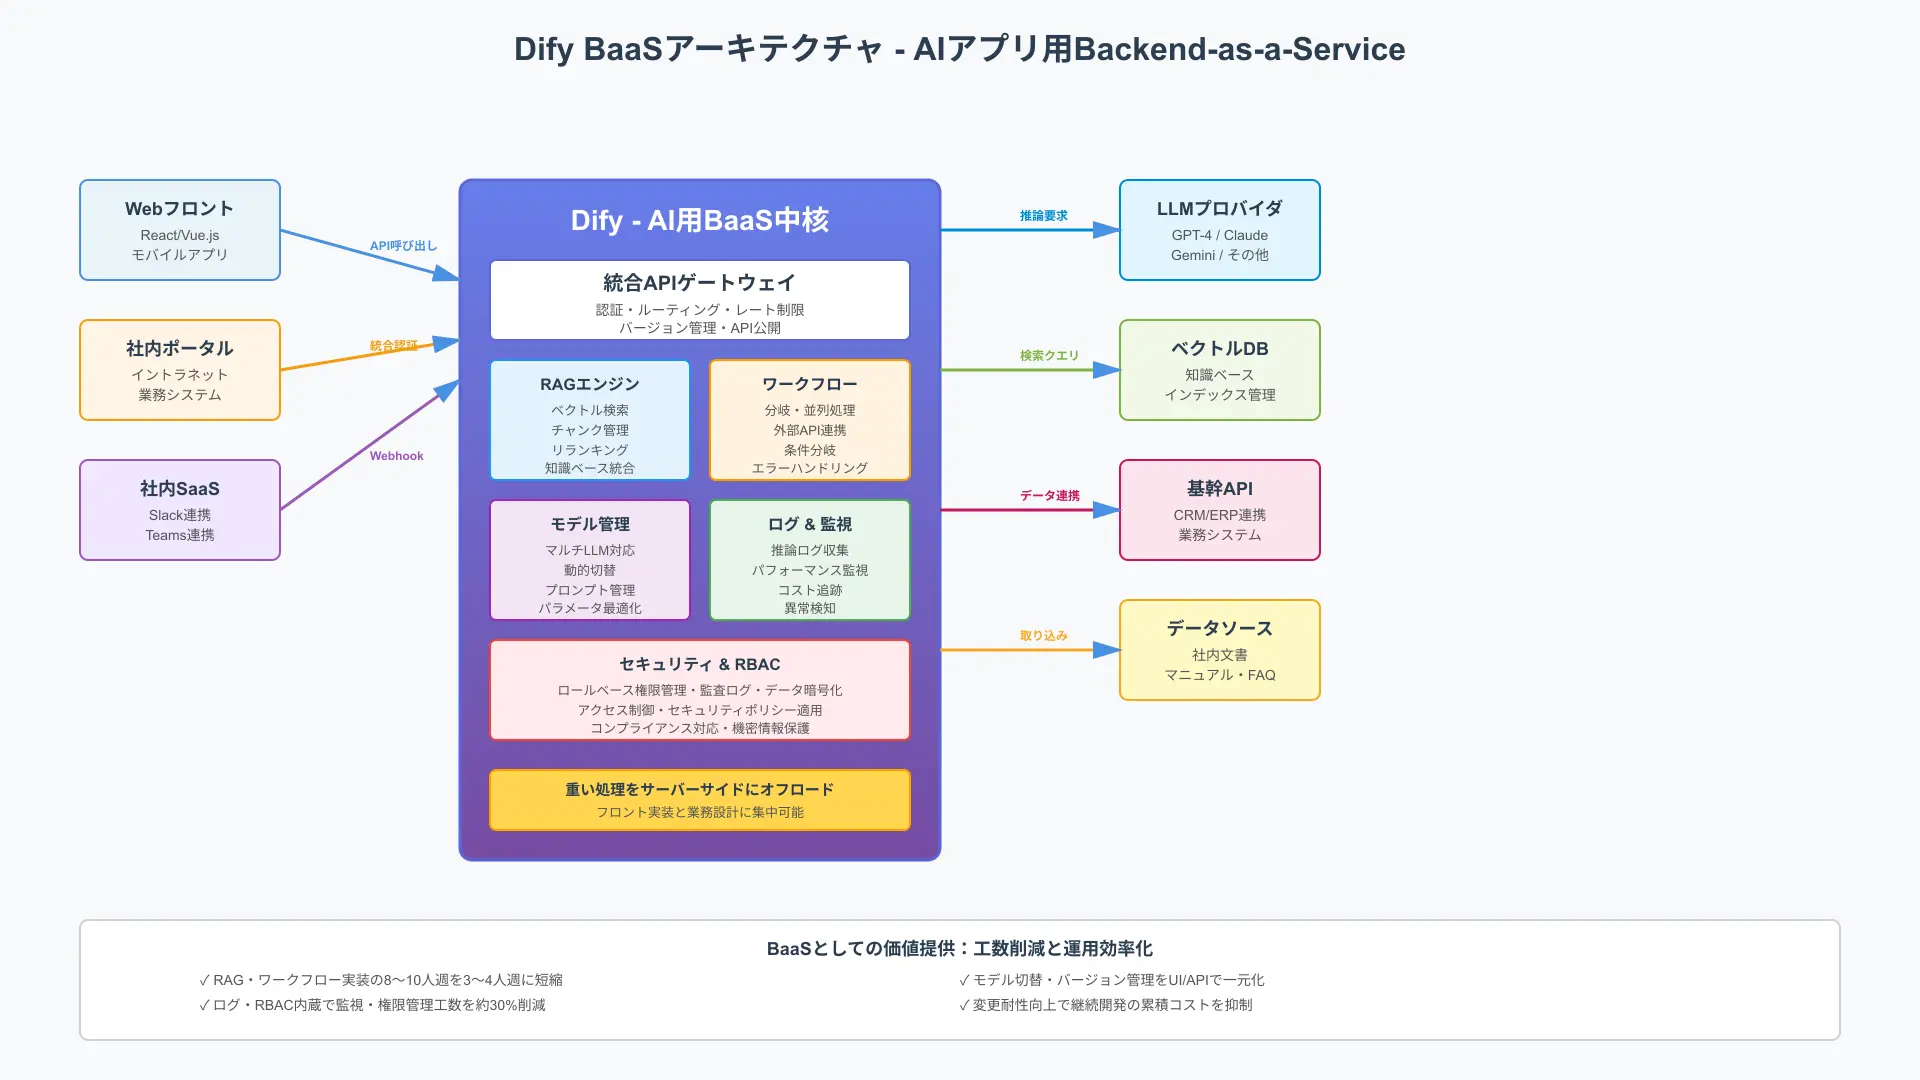
Difyは画面を作るだけのUIビルダーではなく、セキュアなAPIエンドポイントや認証、データベースを内包したBaaSです。
作成したAIロジックは即座にREST APIとして発行され、既存の社内Webシステムやモバイルアプリから呼び出せます。
フロントエンドとAIバックエンドを完全に分離し、組織全体で再利用可能なAIマイクロサービス基盤を確立できます。
4タイプのアプリケーション構造で大半のユースケースをカバー
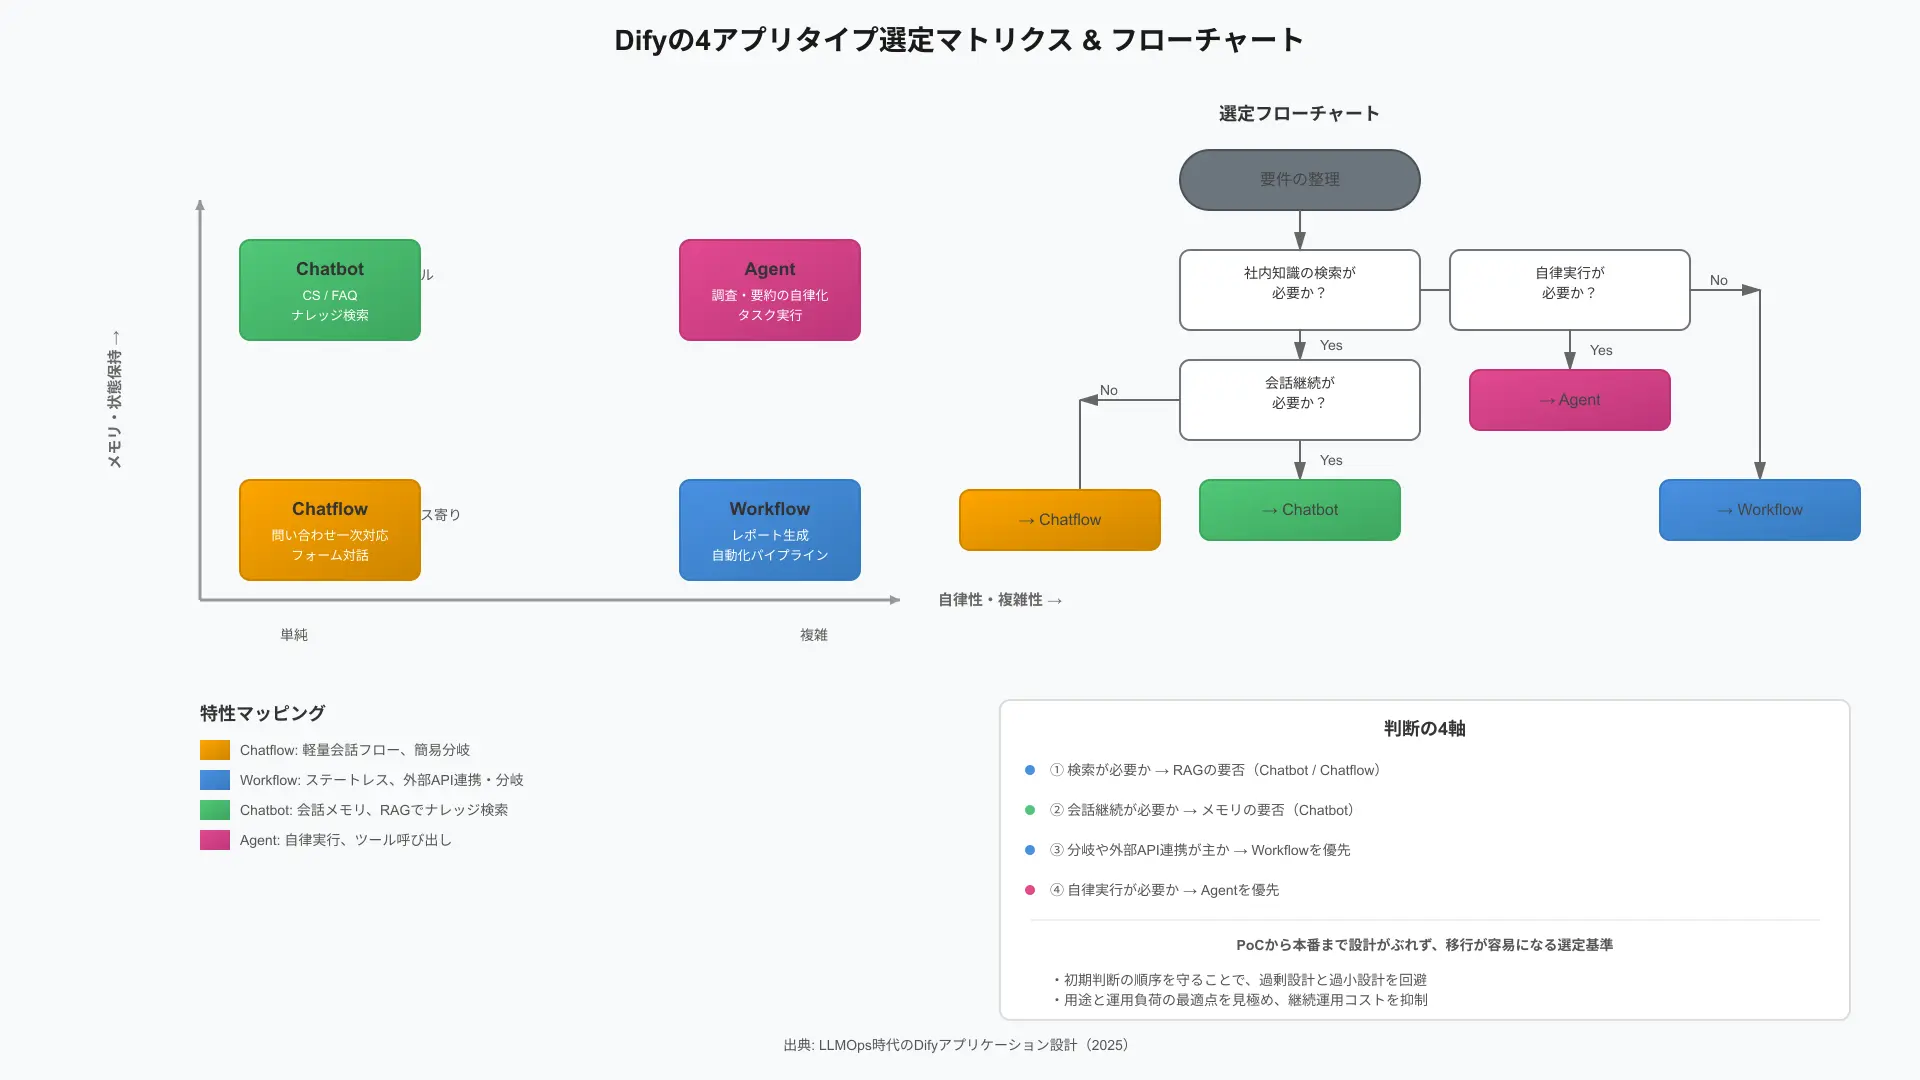
Difyでは「チャットボット」「テキスト生成」「エージェント」「ワークフロー」の4つのアプリ種別を提供しています。
単発の文章校正から複雑な複数ステップの承認業務まで、用途に合わせて最適なアーキテクチャを選択できます。
シンプルな設計思想により、現場の業務担当者からエンジニアまで迷わず目的に合ったアプリを構築できます。
Difyのワークフロー&Studio:業務プロセスをそのままAIフローに落とし込む
当セクションでは、視覚的なワークフローキャンバスを活用した高度な業務自動化の設計手法を解説します。
複雑な条件分岐やデータ処理を自在に組み上げ、実務に即した自動化を実現できるようになるからです。
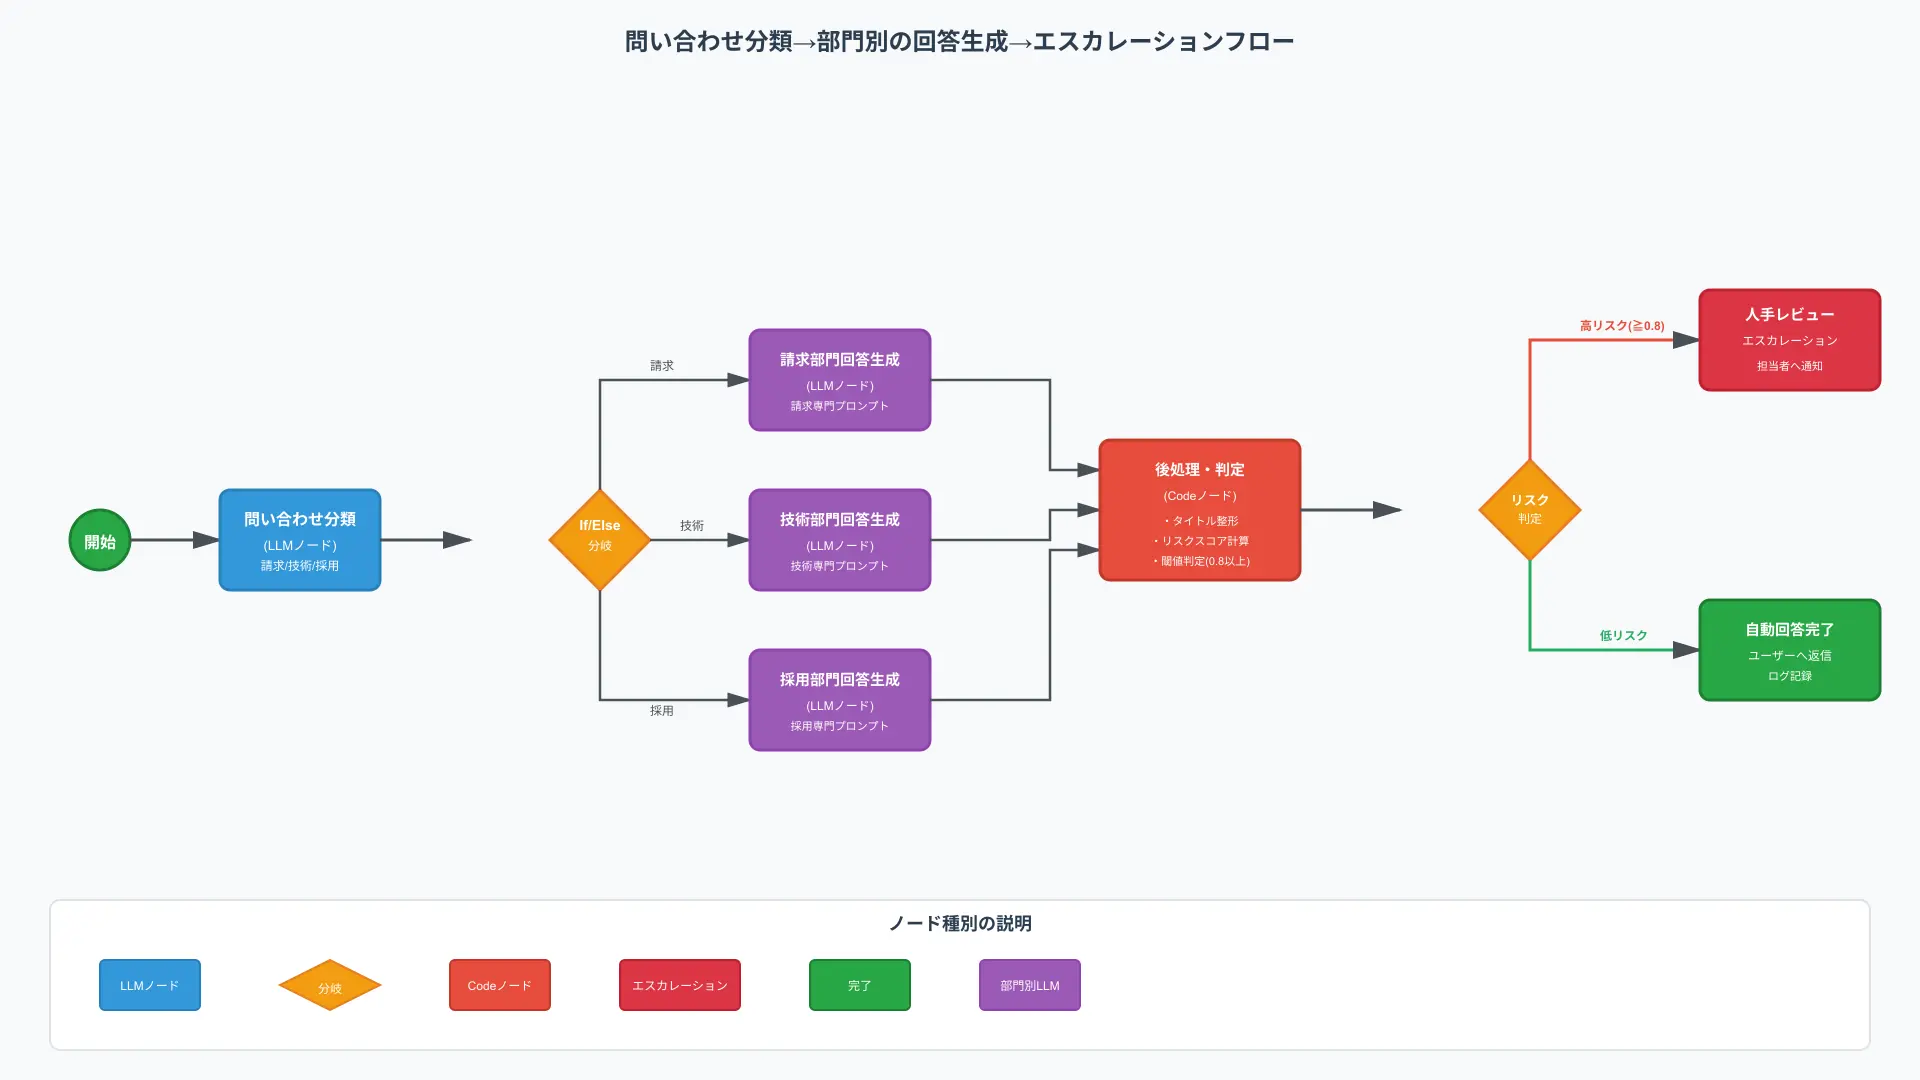
If/Else・Iteration・Codeノードで業務ロジックを再現できる理由
ユーザーの問い合わせ内容に応じて回答モデルを切り替える条件分岐や、リストデータに対するループ処理を直感的に配置できます。
PythonやJavaScriptを実行できるCodeノードを挟むことで、複雑な正規表現処理や数値計算も自在にこなせます。
ノーコードの枠を超えた柔軟な拡張性により、社内の独自業務ルールを100%正確にフロー化できます。
並列処理とパラメータ抽出でユーザー体験を向上させる
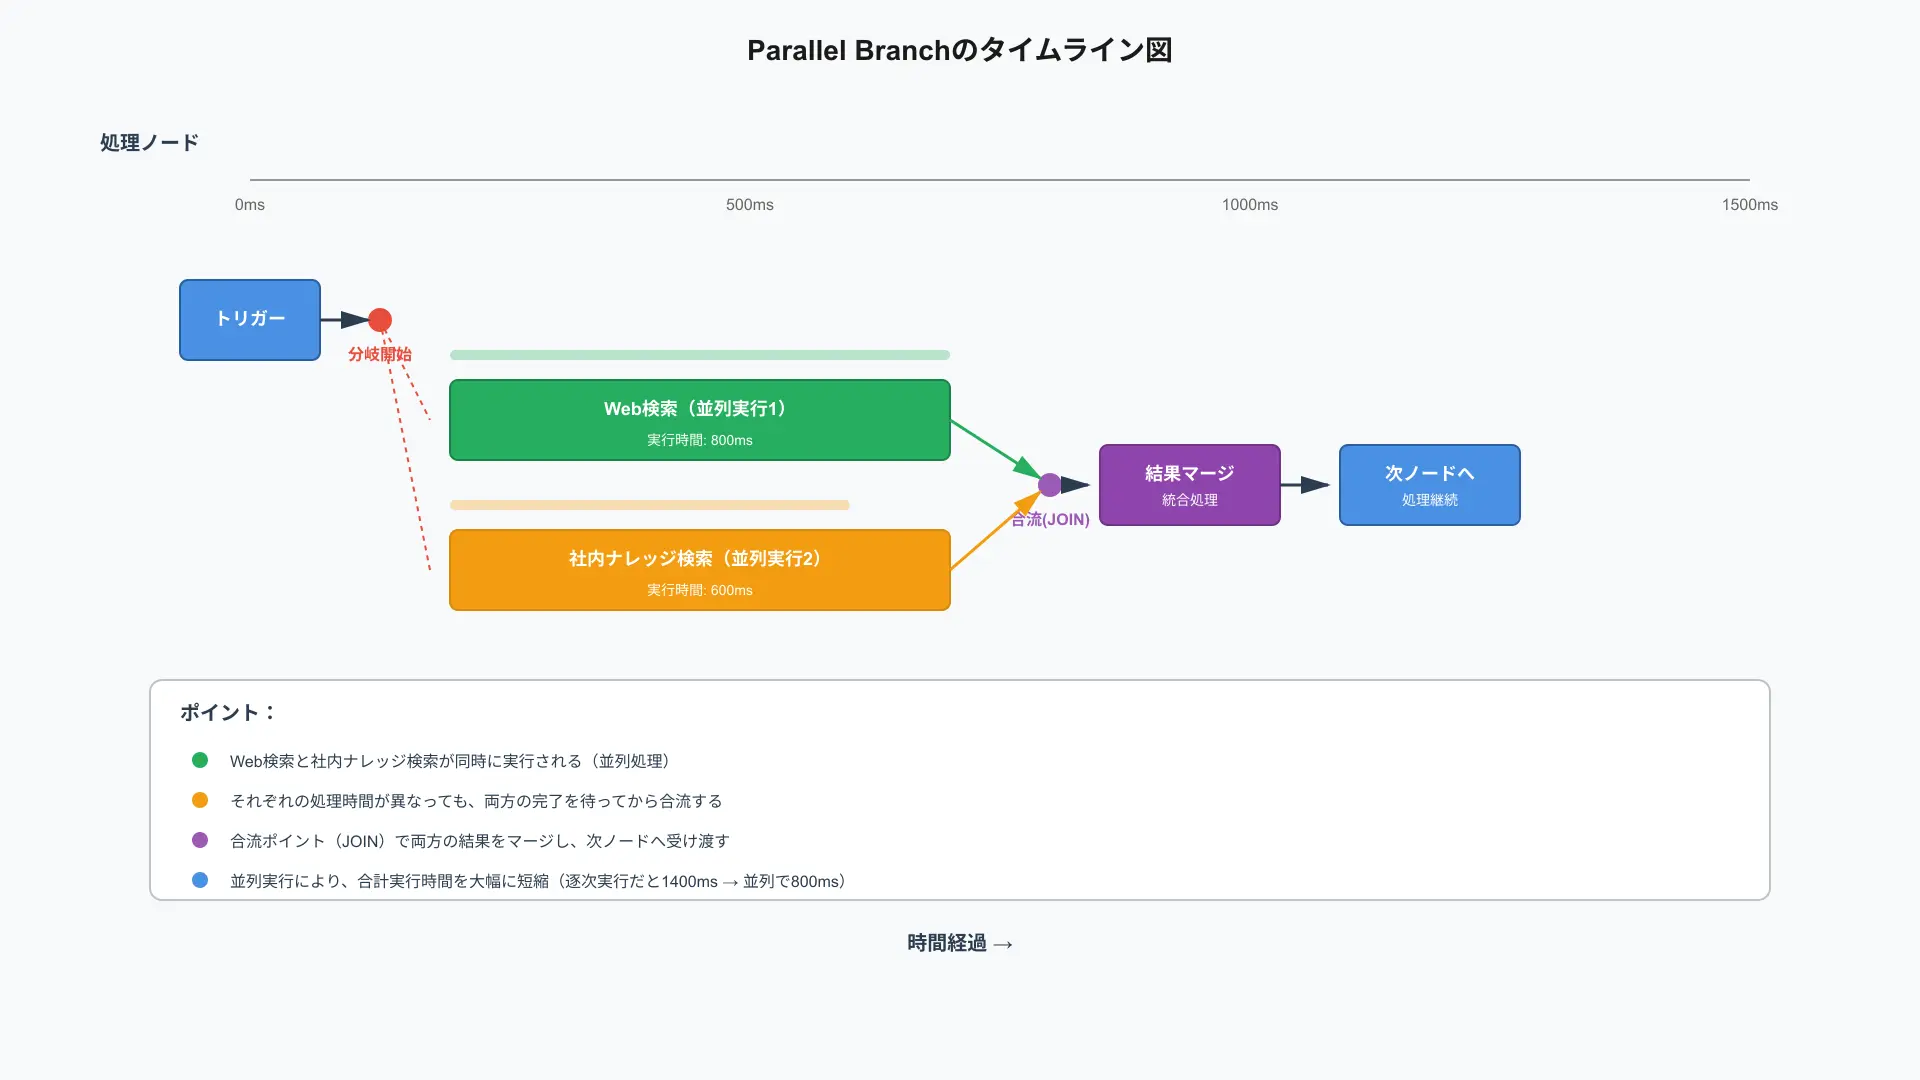
複数のLLM推論や社内API呼び出しを同時に並列実行することで、全体のレスポンス待機時間を大幅に短縮できます。
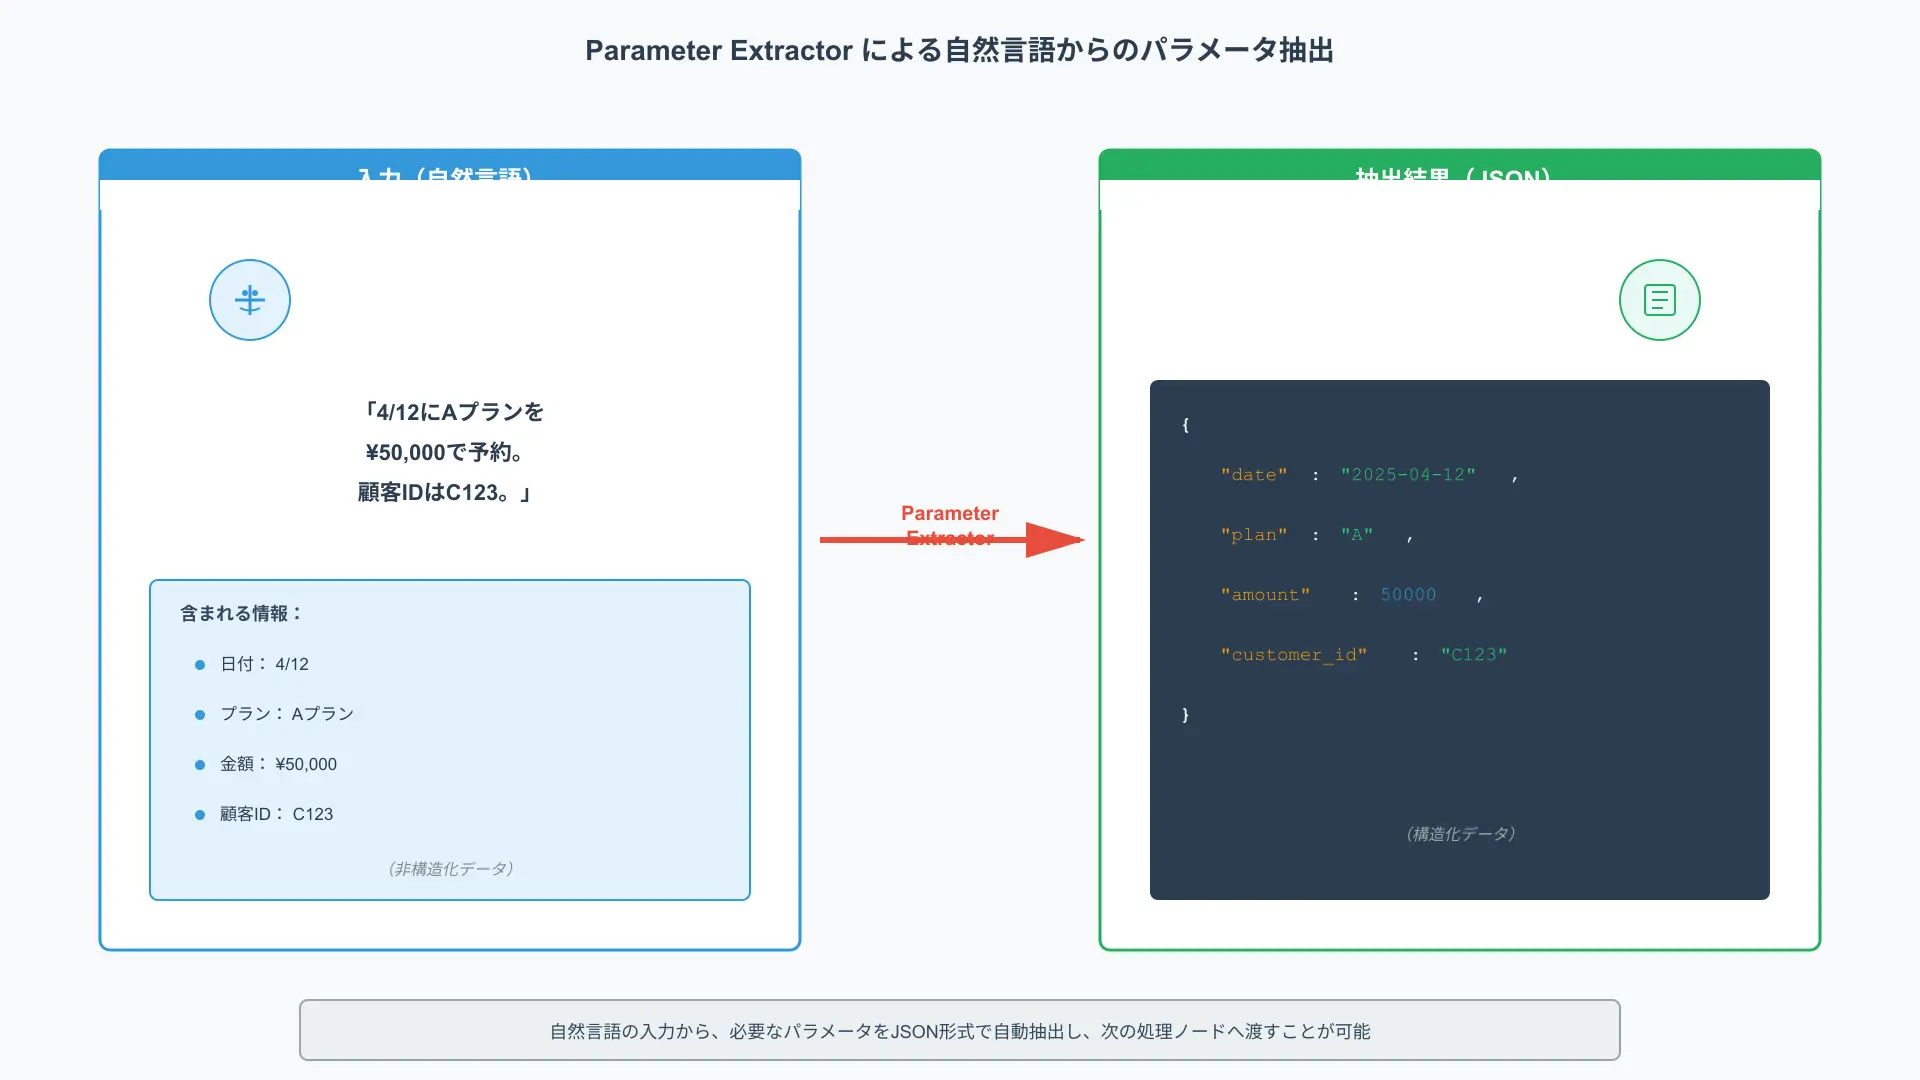
また、パラメータ抽出ノードを用いることで、自由入力文から「日付」「金額」「担当者名」などの構造化データを確実に取得します。
ユーザーとの自然な対話から必要な情報を自動抽出し、後続の基幹システム連携へスムーズにデータを引き渡しられます。
変数とメモリ設計:会話型アプリの“文脈”をどう持たせるか
過去の会話履歴をどの深さまで保持するかを制御するメモリノードや、セッションを跨ぐグローバル変数を設計できます。
直前の文脈を考慮した代名詞の補完を行い、ユーザーの意図を汲み取った的確なフォローアップ質問を生成します。
会話の途切れや文脈の齟齬を防ぎ、まるで人間の専任アシスタントと対話しているような快適な操作感を実現します。
RAG機能の実力:Difyで社内ナレッジを“嘘をつかないAI”に変える
当セクションでは、社内ドキュメントを正確に参照しハルシネーションを根絶するRAG設計手法を解説します。
実用に耐える高精度なナレッジ検索基盤を自前で構築できるようになるからです。
- 多様なデータソースとETLパイプライン:まずはナレッジの入口を整える
- チャンク戦略(General vs Parent-Child)が回答精度を左右する
- ハイブリッド検索+リランク:ハルシネーションを現実的に抑え込む設計
多様なデータソースとETLパイプライン:まずはナレッジの入口を整える
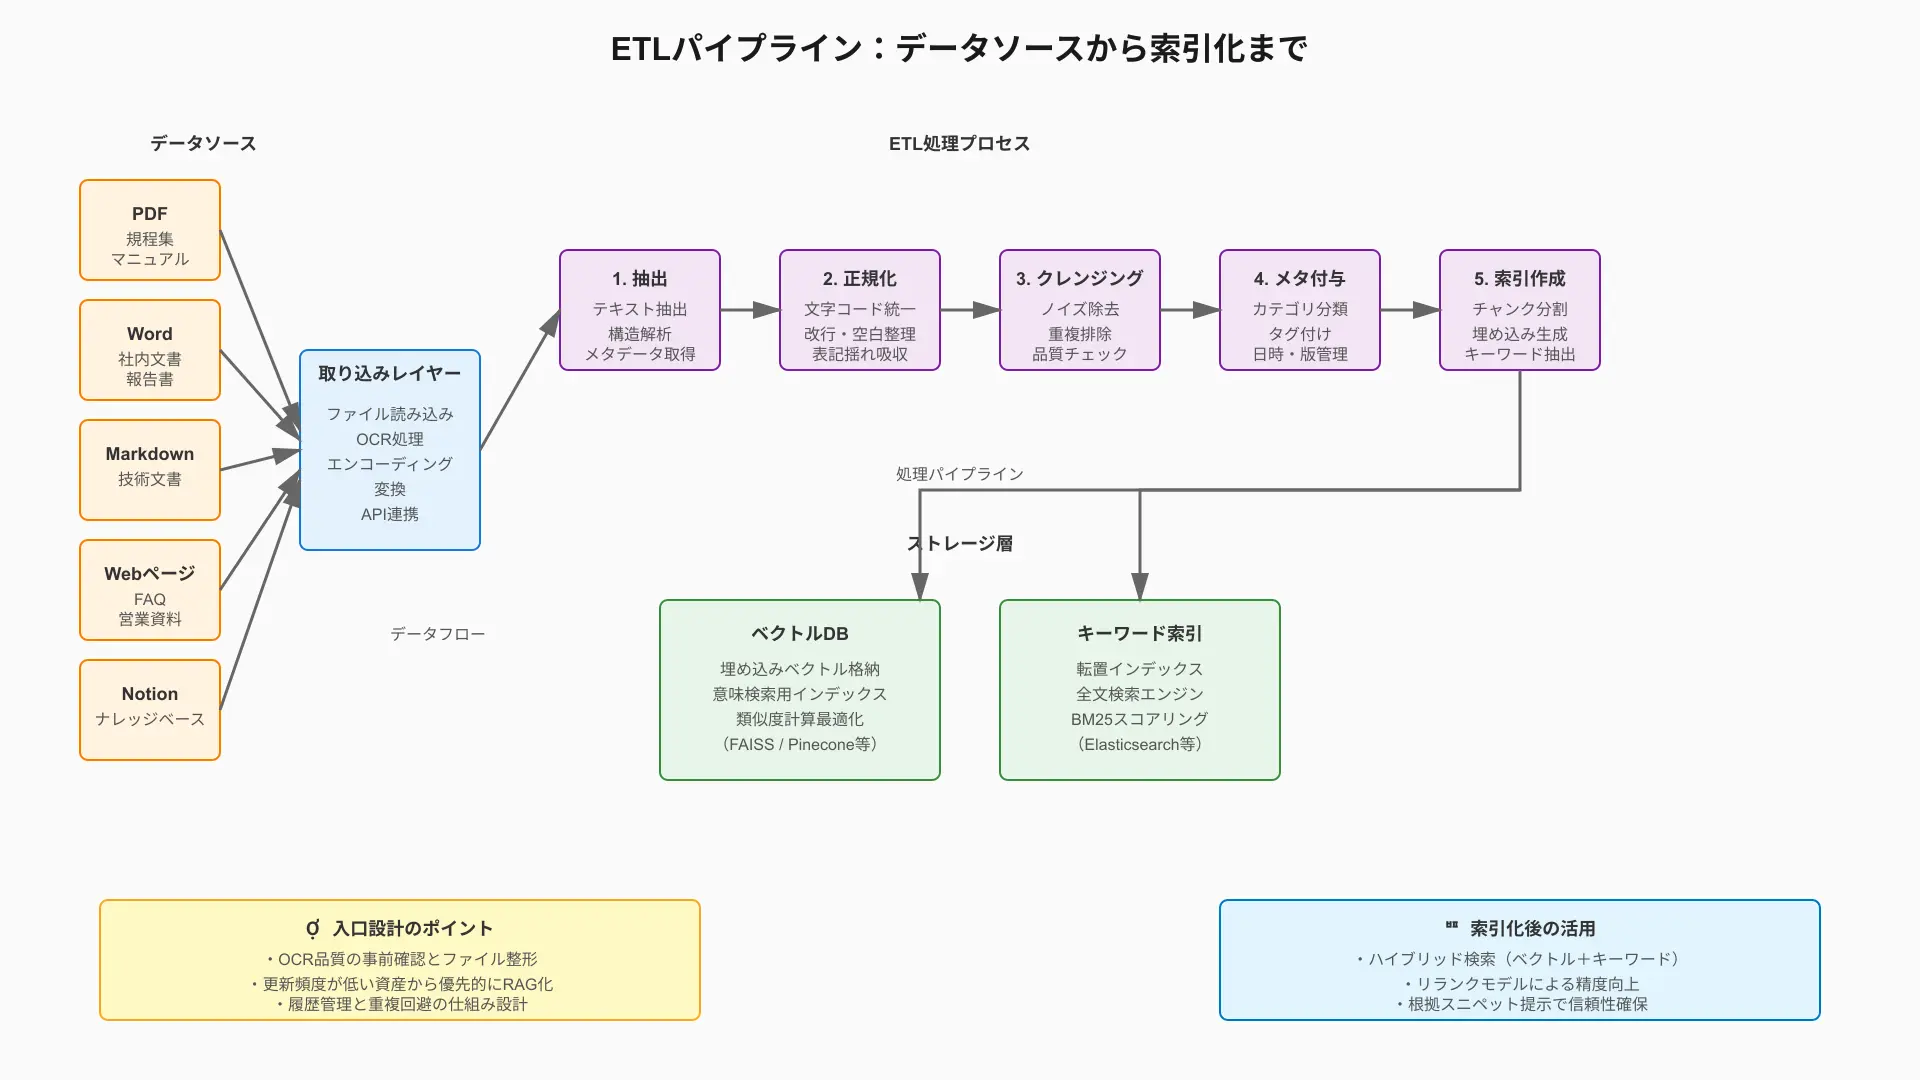
PDF、Word、Notion、WebサイトのURLなど、多様な形式のドキュメントを自動でパースして取り込めます。
不要なヘッダーやフッター、空白行のクレンジング処理をインポート時に自動実行します。
ノイズの少ない綺麗なテキストデータを蓄積し、検索精度の土台となる高品質なナレッジベースを整備できます。
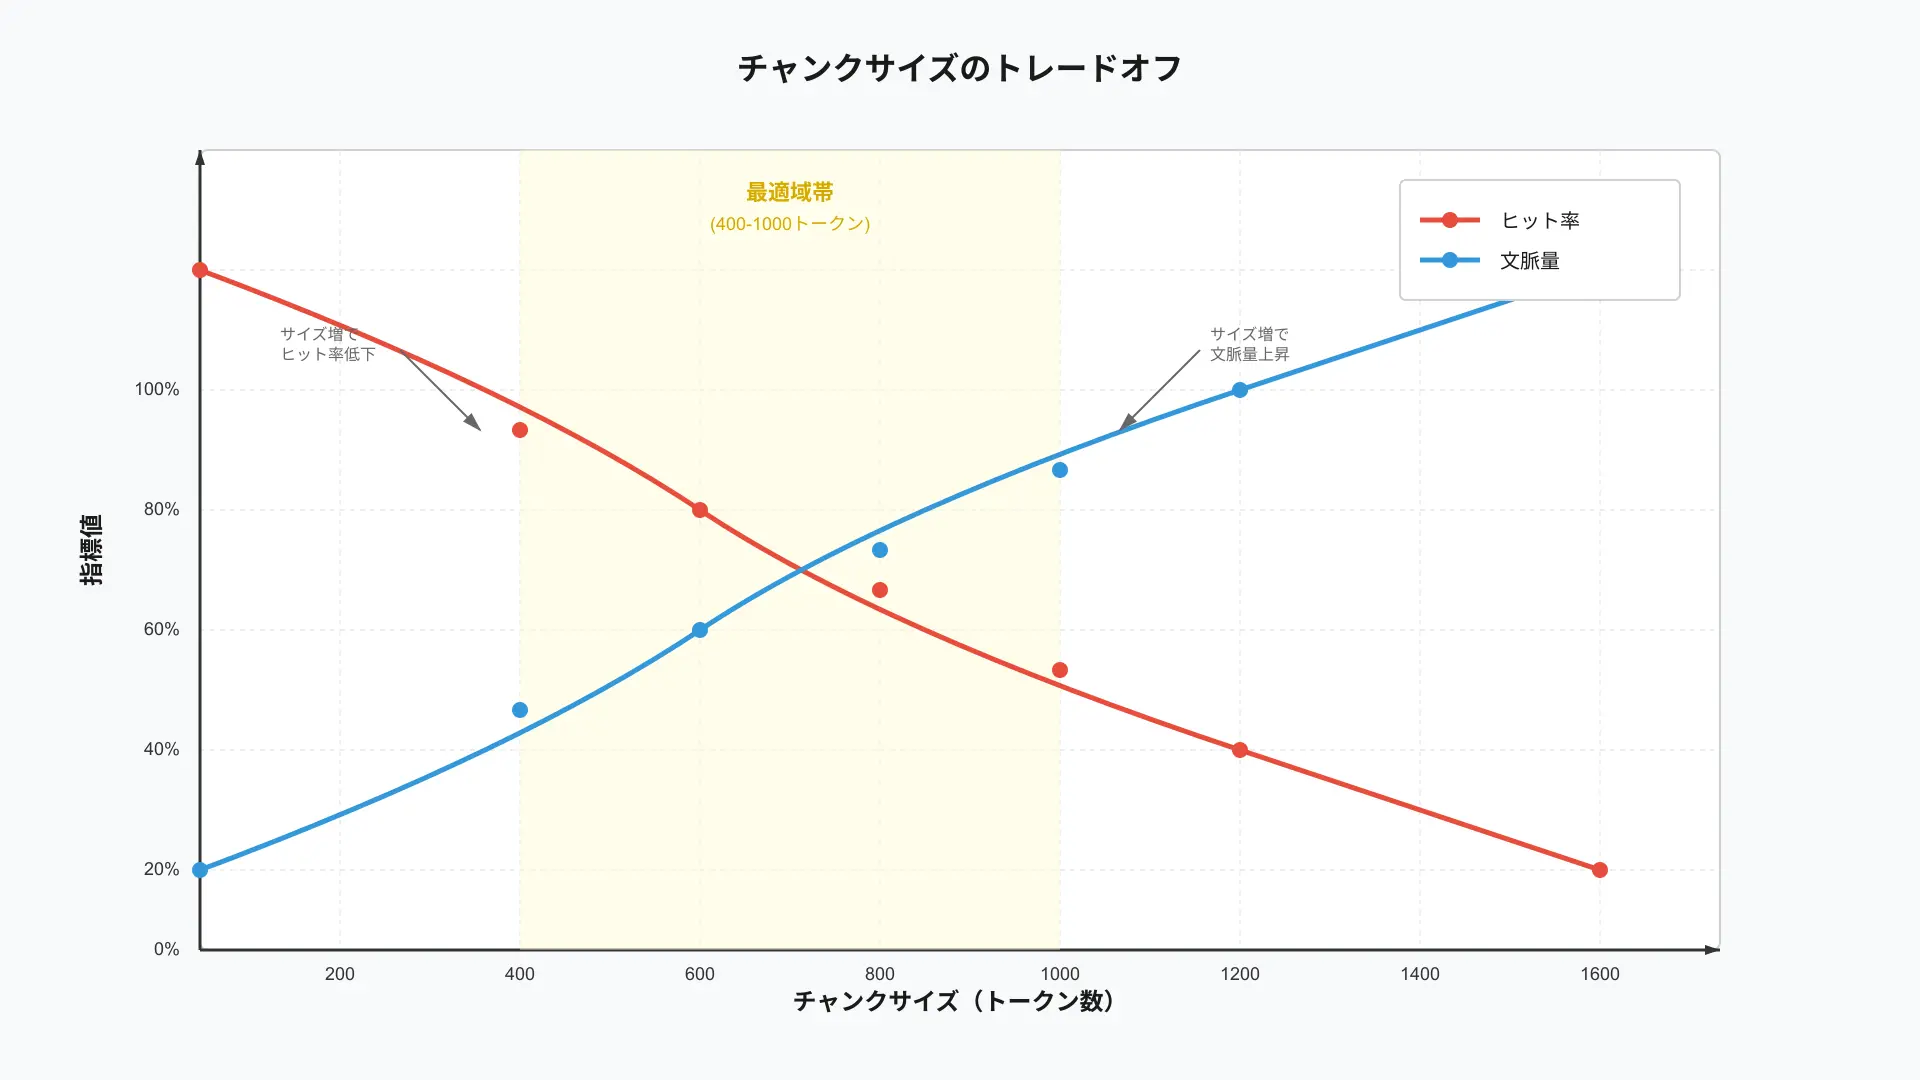
チャンク戦略(General vs Parent-Child)が回答精度を左右する
単純な固定長分割では文脈が途切れてしまい、正しい意味を検索エンジンが捉えられなくなります。
検索用の小さな子チャンクと、LLMへ渡す文脈保持用の親チャンクを分ける「Parent-Child(階層)チャンク」が有効です。
ピンポイントな検索ヒット率と豊かな文脈把握を両立させ、回答の根拠抜けや誤読を劇的に防止できます。
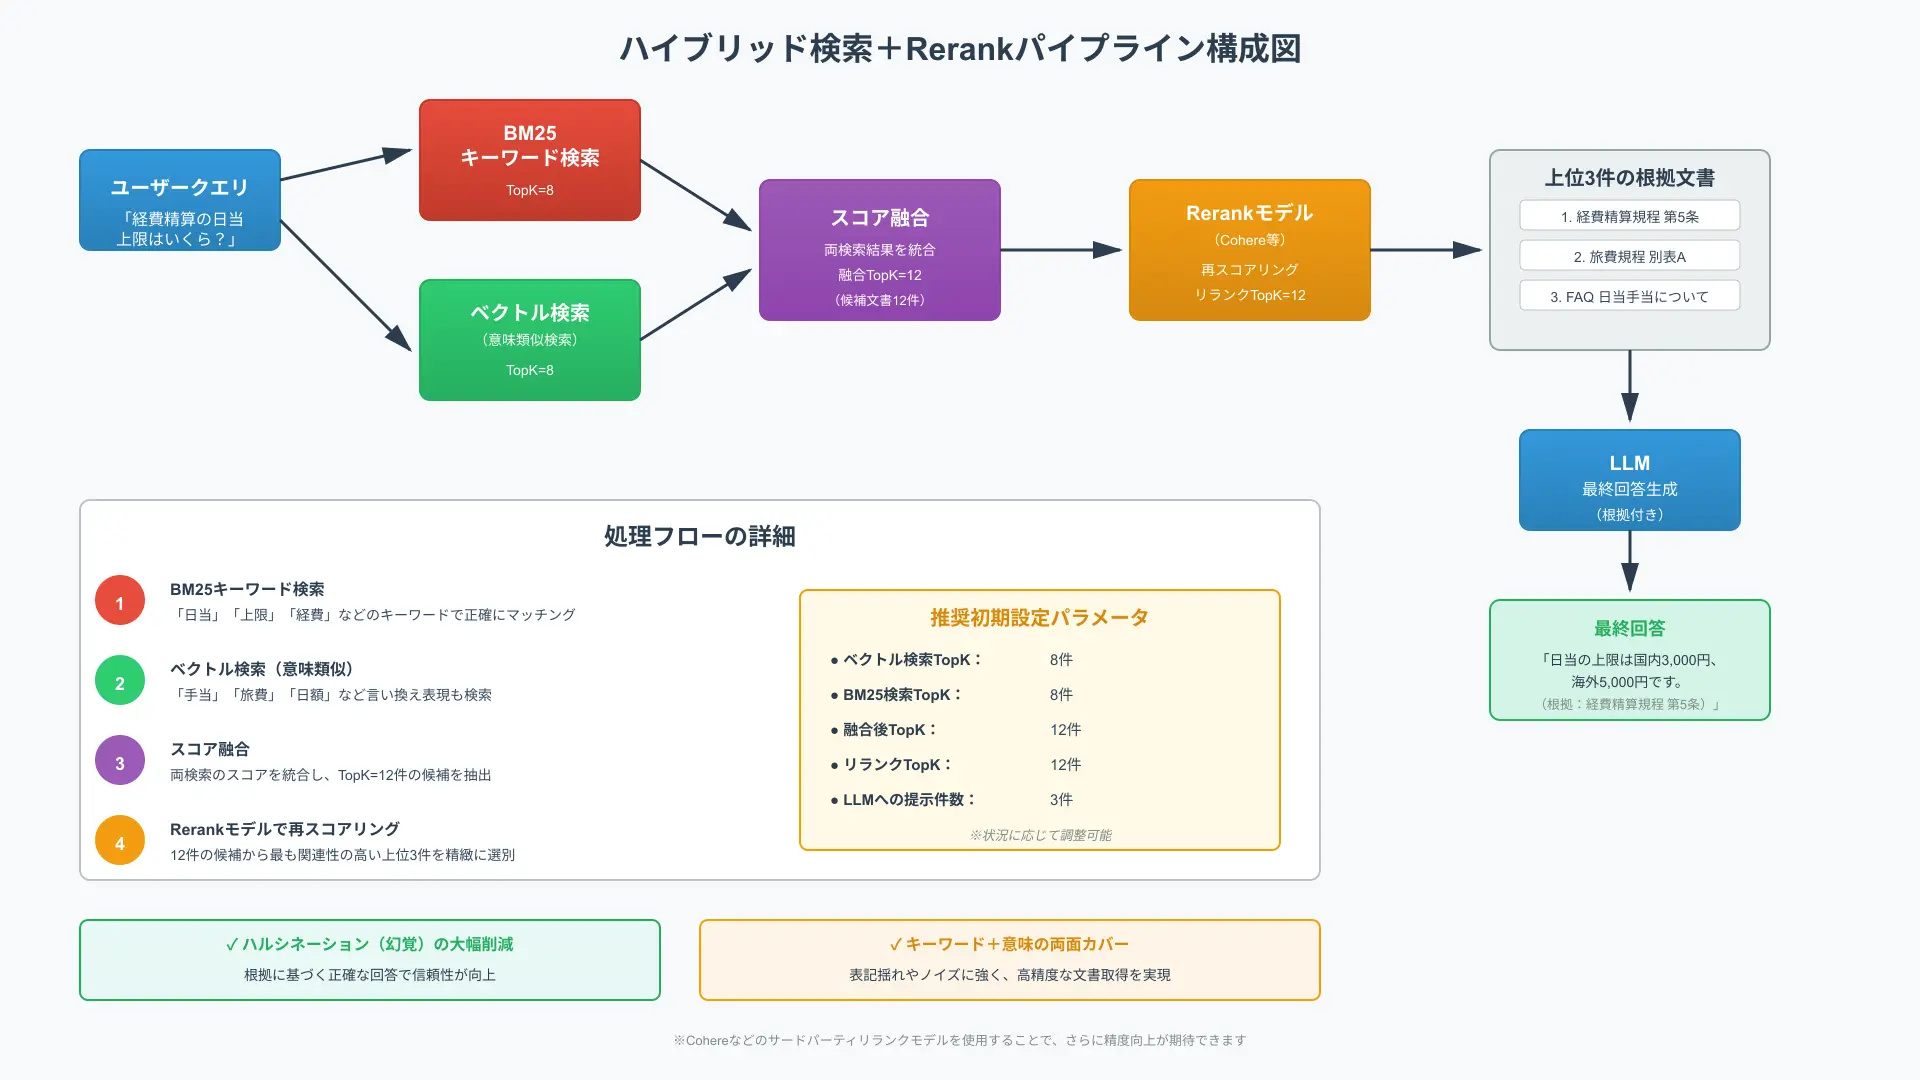
ハイブリッド検索+リランク:ハルシネーションを現実的に抑え込む設計
意味の近さを測るベクトル検索と、完全一致キーワードを拾うBM25検索を組み合わせたハイブリッド検索を実行します。
抽出された候補群に対してBGE-RerankerやCohere Rerankモデルを通し、関連度順に再スコアリングします。
専門用語や型番の取りこぼしを完全に排除し、常に最も正しい社内文書を引用する信頼性の高いAIが完成します。
モデルニュートラル設計:ベンダーロックインを避けつつ最適モデルを使い分ける
当セクションでは、マルチモデルの柔軟な使い分けと耐障害性(レジリエンス)設計を解説します。
コスト最適化とサービス停止リスクの回避を同時に達成できるようになるからです。
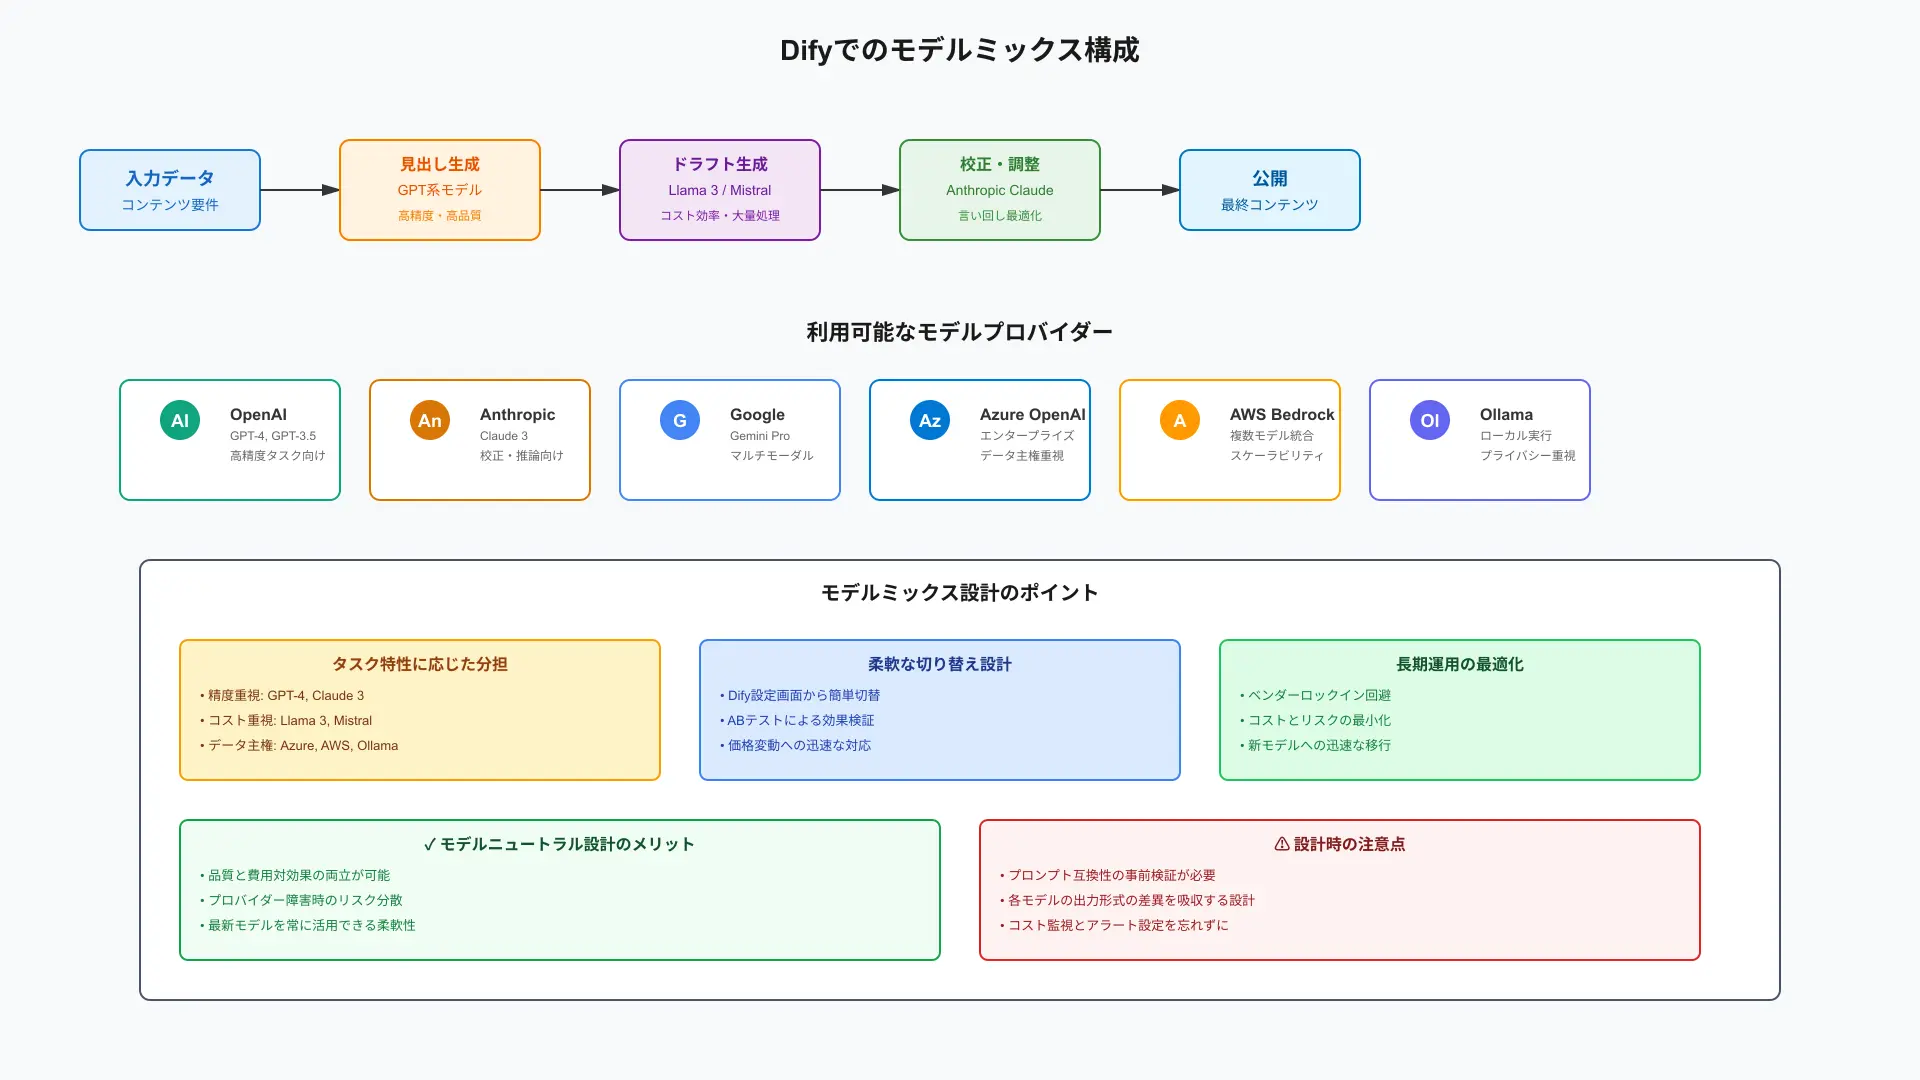
Difyで扱える主なモデルプロバイダーと使い分けの考え方
OpenAI、Anthropic、Google Gemini、ローカルのOllamaまで、あらゆるプロバイダーを1クリックで接続できます。
日常の簡易要約には安価な軽量モデルを、複雑な契約書チェックにはClaude 3.7 Sonnetを割り当てます。
タスクの難易度に応じた最適なモデルルーティングを行い、高い知能と圧倒的な低コスト運用を両立できます。
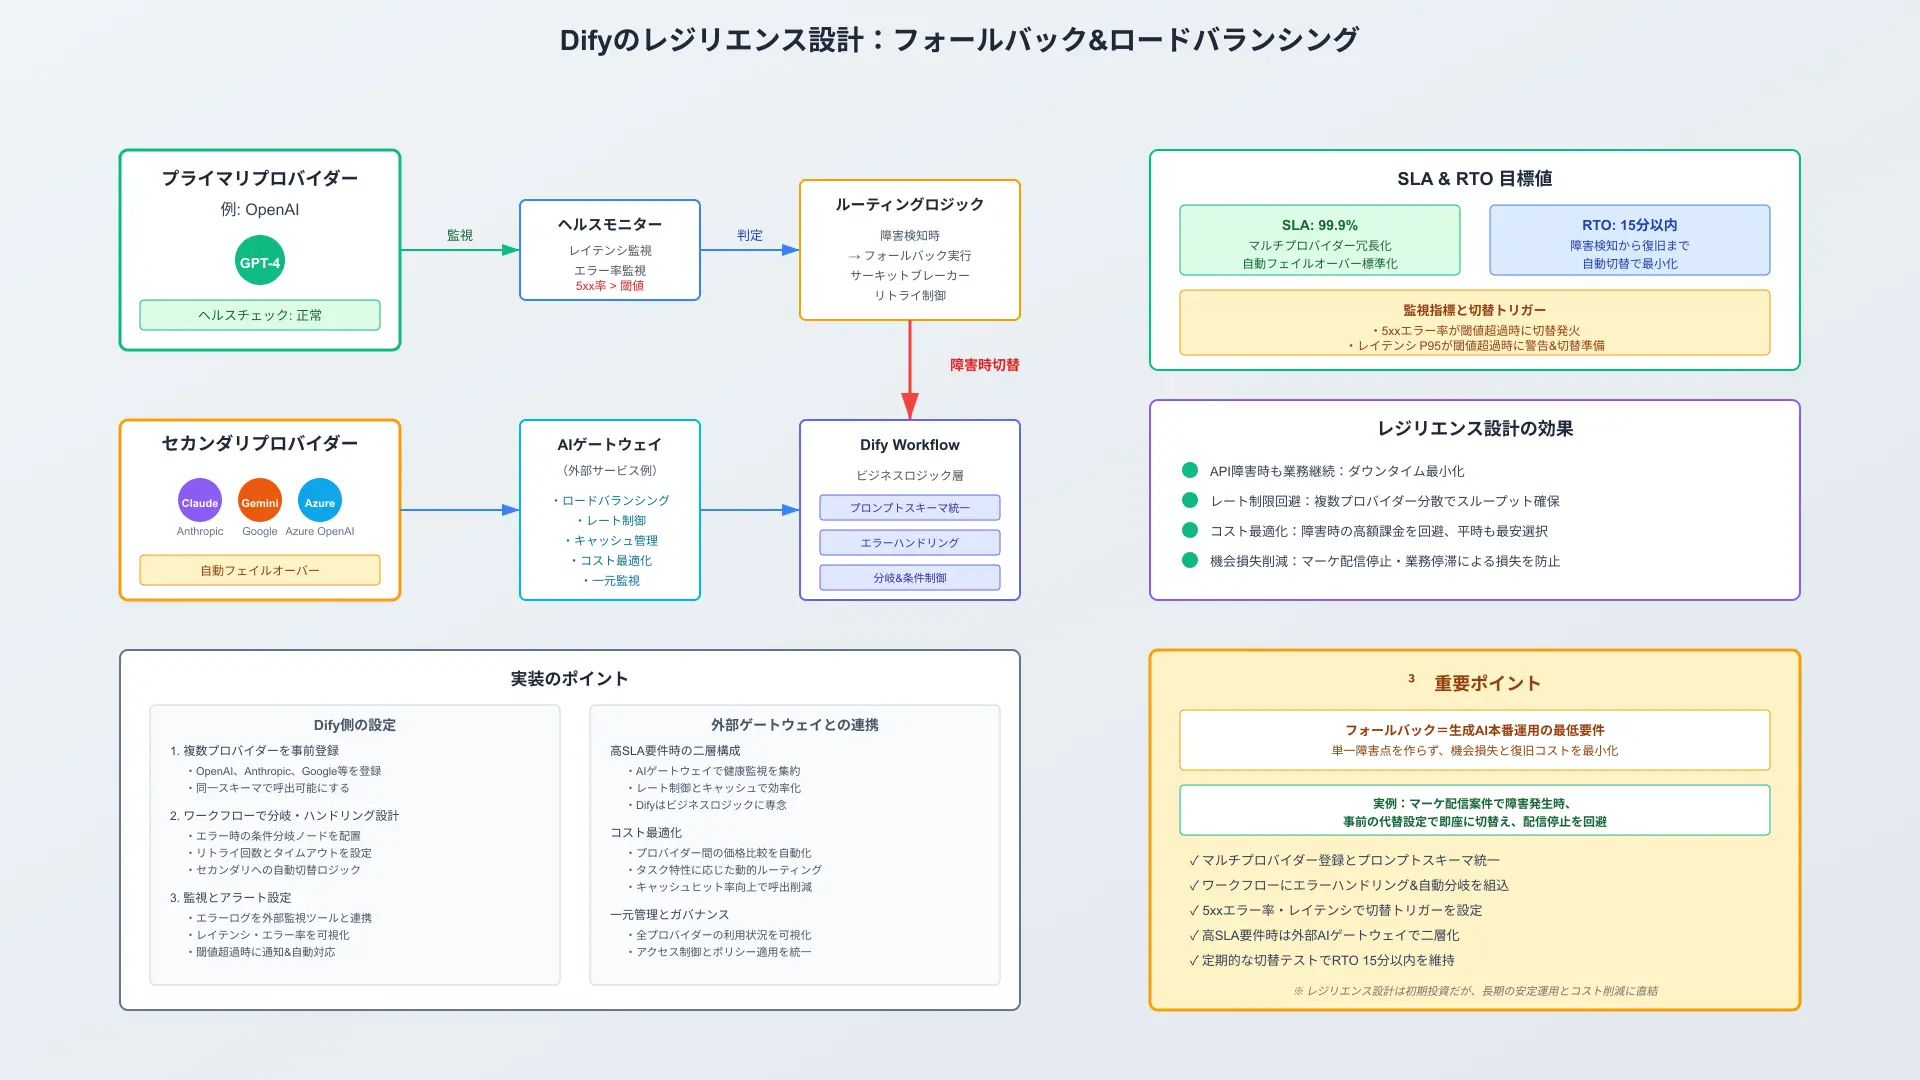
フォールバックとロードバランシング:API障害時のレジリエンス設計
特定のLLMベンダーでAPI障害やレートリミットが発生した際、自動的に代替モデルへ切り替えるフォールバックを設定できます。
また、複数のAPIキーを登録して負荷分散(ロードバランシング)を行うことで、大量アクセスを安定処理します。
単一障害点(SPOF)を排除し、24時間365日止まらない堅牢なエンタープライズAIサービスを運用できます。
AIエージェントとDeep Researchワークフロー:人間のリサーチをどこまで代替できるか
当セクションでは、AIエージェントによる自律的な情報収集と調査業務の自動化手法を解説します。
高度なデスクリサーチや競合分析にかかる時間を大幅に圧縮できるようになるからです。
- ReAct的な思考プロセスとツール利用をDifyでどう表現するか
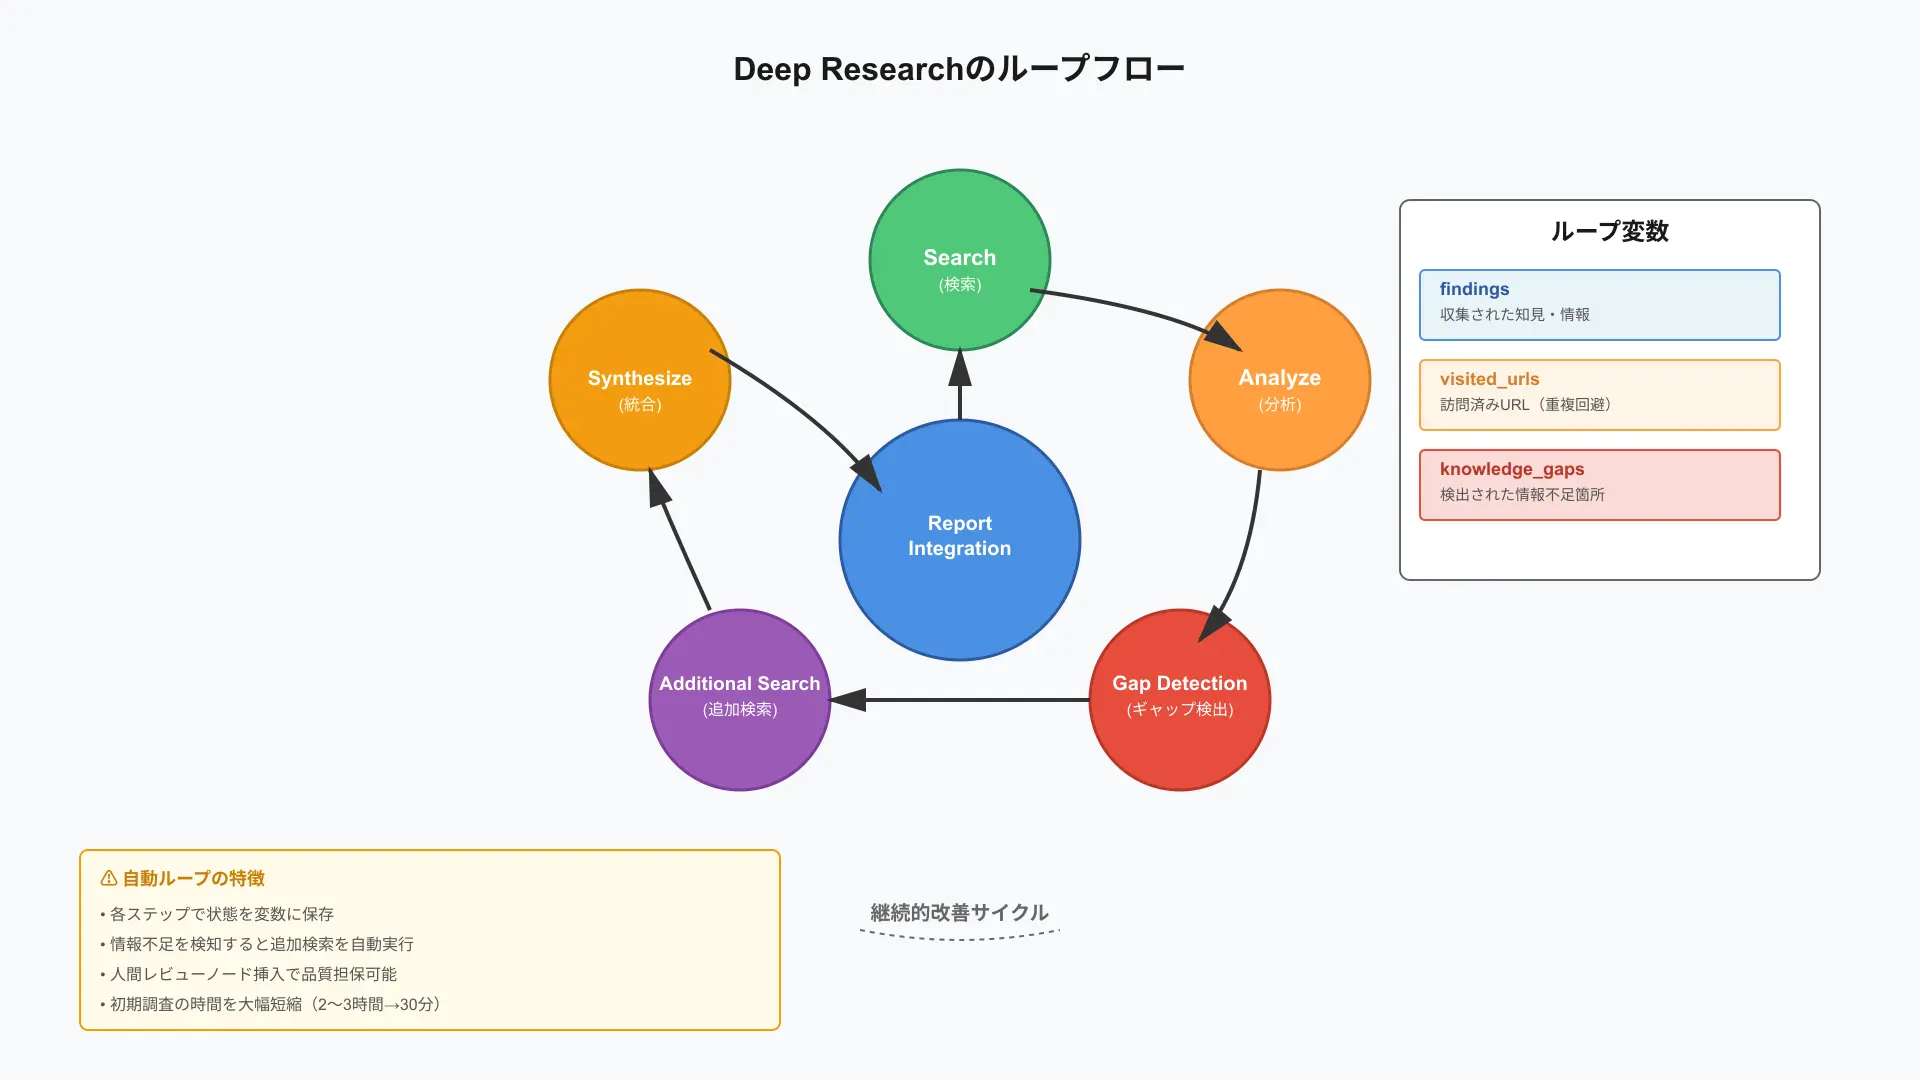
- Deep Researchテンプレート:調査→分析→追加調査→レポートを自動ループさせる
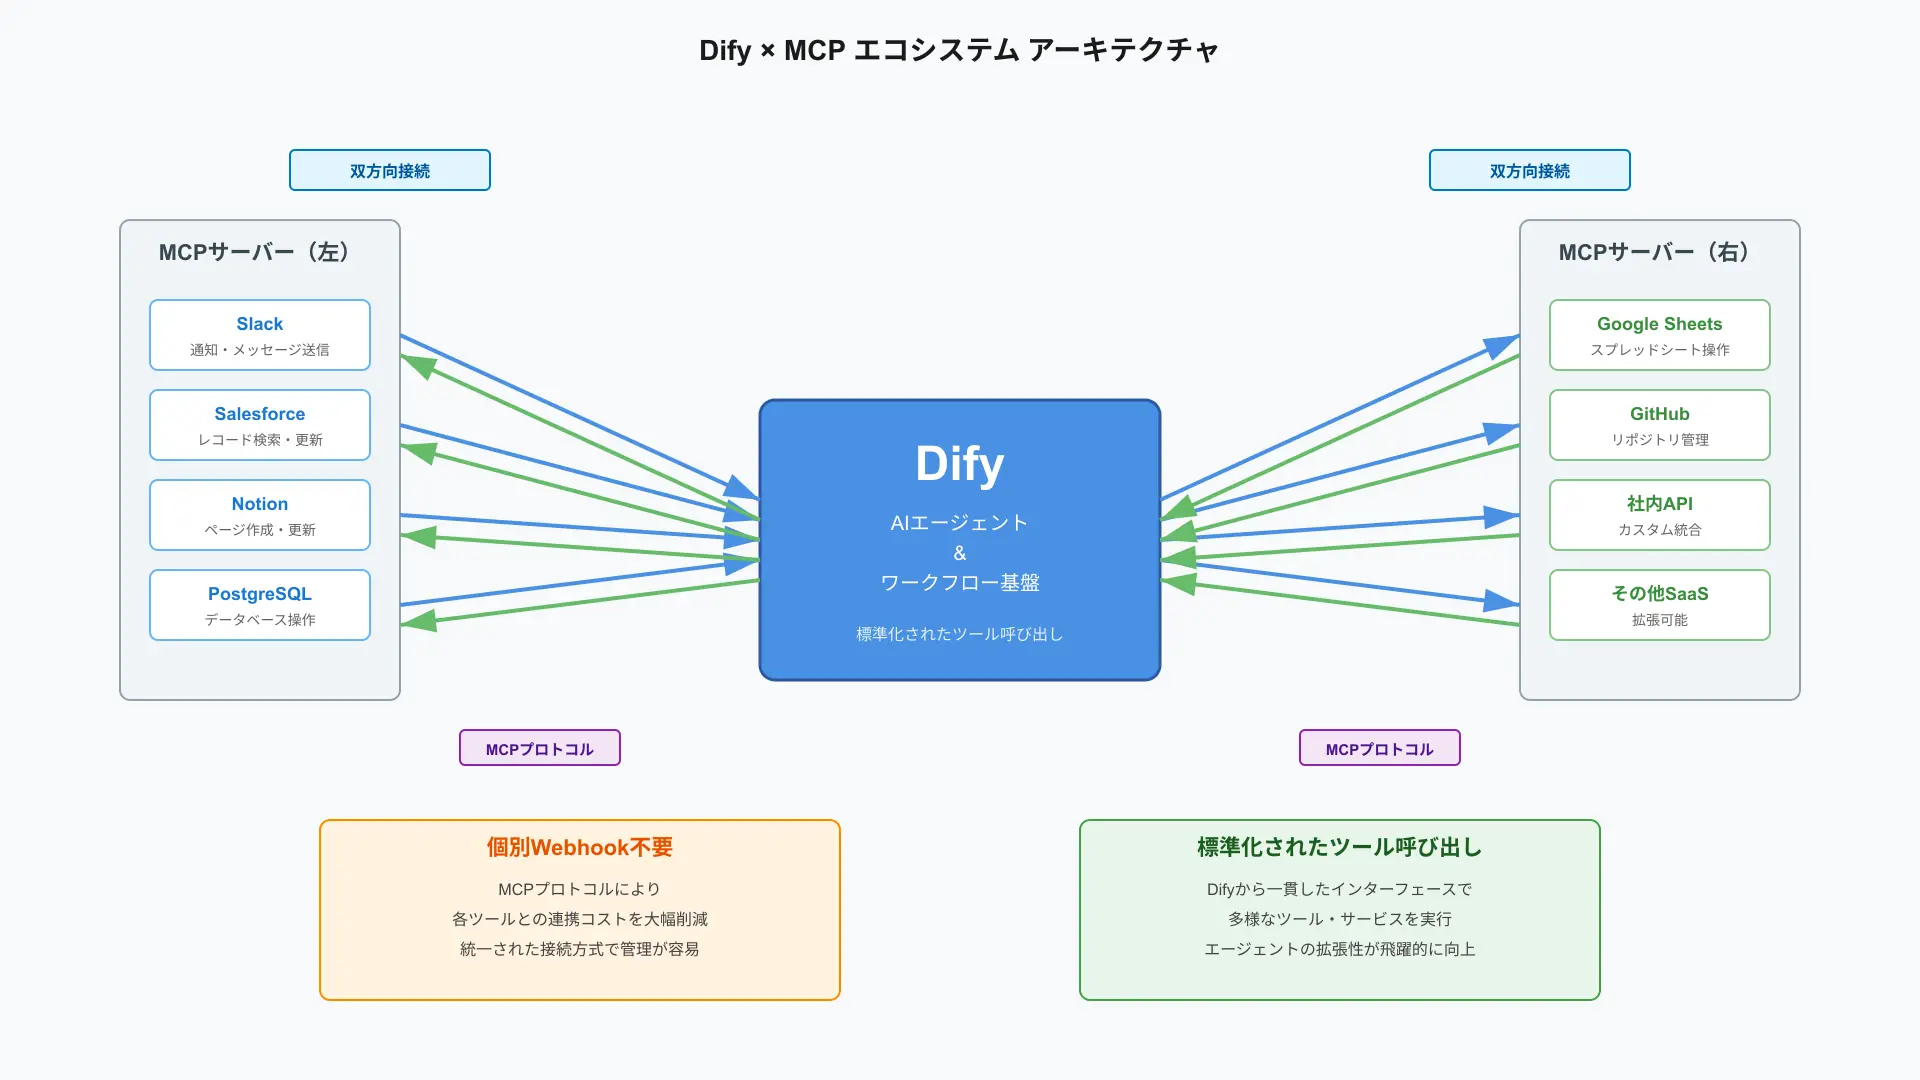
- MCP対応で広がるエコシステム:ツール連携コストをどう下げられるか
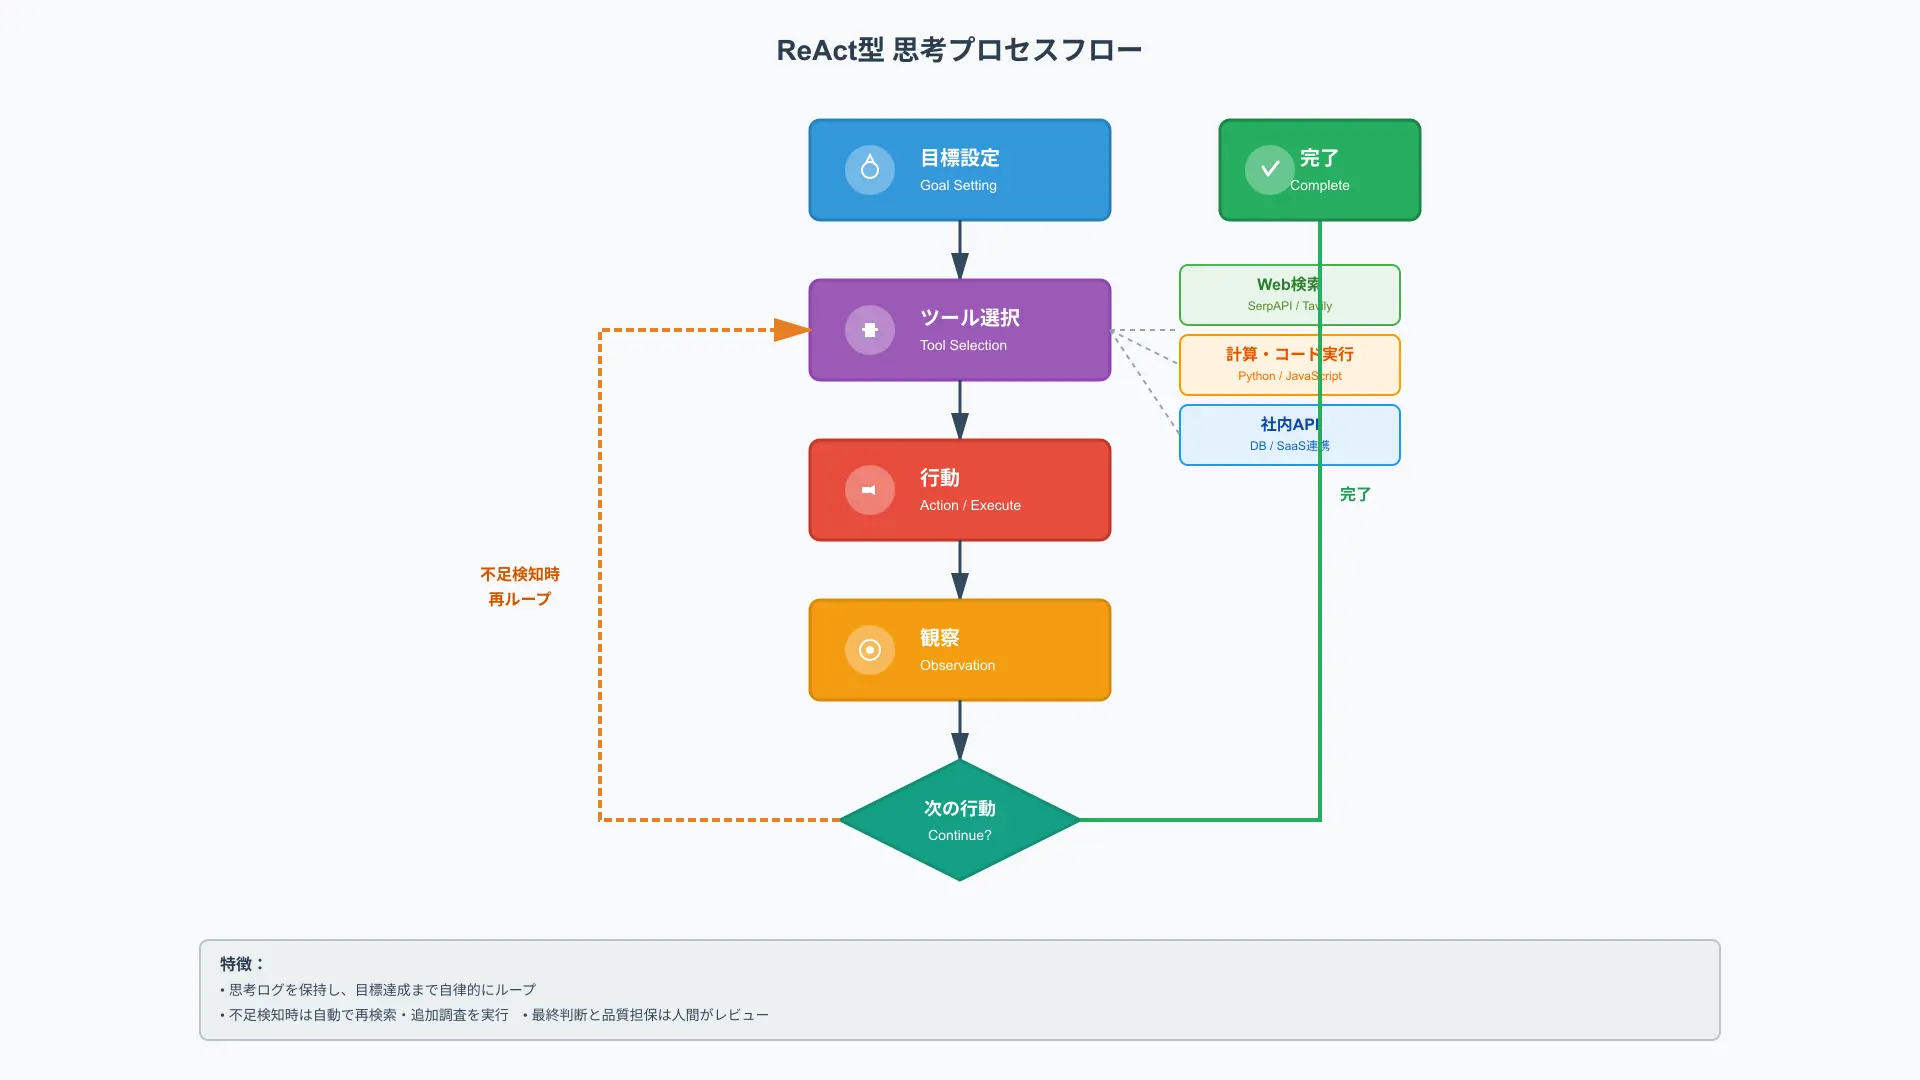
ReAct的な思考プロセスとツール利用をDifyでどう表現するか
エージェントはユーザーの指示に対し「思考(Thought)」「行動(Action)」「観察(Observation)」のサイクルを自律的に繰り返します。
必要に応じて社内DBやGoogle検索ツールを自ら呼び出し、得られた結果を基に次の行動を決定します。
人間が手作業で指示を出さなくても、複雑なゴールに向かって自律的にタスクを完了する高度なAIパートナーが誕生します。
Deep Researchテンプレート:調査→分析→追加調査→レポートを自動ループさせる
初期の検索結果から不足情報を特定し、さらに深掘りのクエリを投げて多角的な情報を集めるループ処理を構築できます。
集約した数十件のWeb記事や文献データを要約し、体系的な構成の調査レポートを一括生成します。
数時間かかっていた市場調査や競合動向の分析をわずか数分で完結させ、意思決定のスピードを劇的に加速させられます。
MCP対応で広がるエコシステム:ツール連携コストをどう下げられるか
業界標準のMCP(Model Context Protocol)を導入することで、外部ツールとの接続仕様を共通化できます。
個別のAPI連携コードを書くことなく、SlackやGitHub、各種SaaSの機能をプラグイン感覚で追加できます。
社内のあらゆるツールとAIエージェントをシームレスに統合し、真に実用的な業務実行ハブを構築できます。
エンタープライズ導入の現実解:クラウドかセルフホストか、セキュリティ要件との兼ね合い
当セクションでは、導入形態(Cloud vs Self-Host)の選定基準とセキュリティ対策を解説します。
社内の情報セキュリティ規定をクリアし、安全に全社導入を推進できるようになるからです。
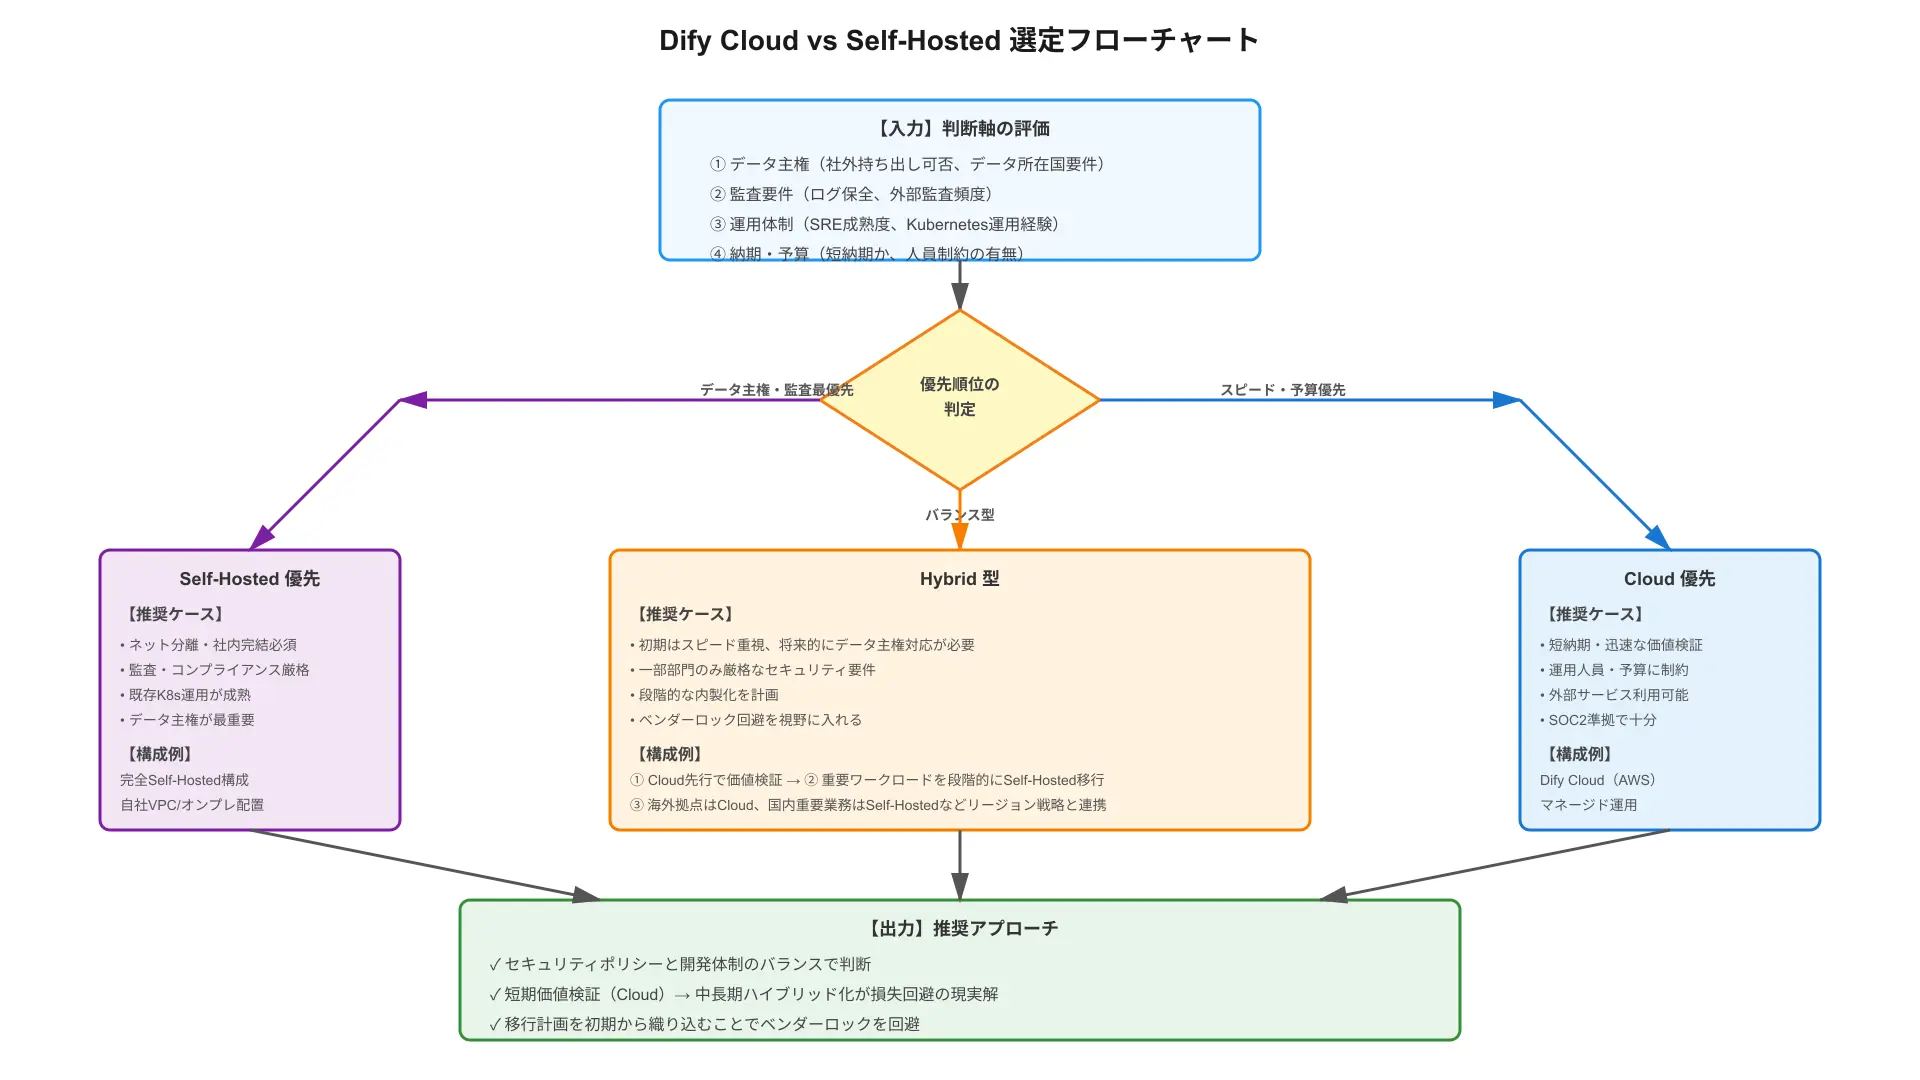
- Dify Cloud vs Self-Hosted:どちらを選ぶべきかの判断軸
- 認証・権限管理・監査ログ:PoCから本番に上げるときに必須のガバナンス機能
- 導入・運用フローの実例:小さく始めて全社展開するステップ
Dify Cloud vs Self-Hosted:どちらを選ぶべきかの判断軸
インフラ保守の手間を省き即座にスタートしたい場合は、手軽なDify Cloudが最適です。
社外秘データの完全隔離や閉域網運用が必須の場合は、自社AWS/GCP環境でのセルフホストを選択します。
企業のセキュリティポリシーと運用リソースを客観的に比較し、最も現実的で持続可能な運用形態を決定します。
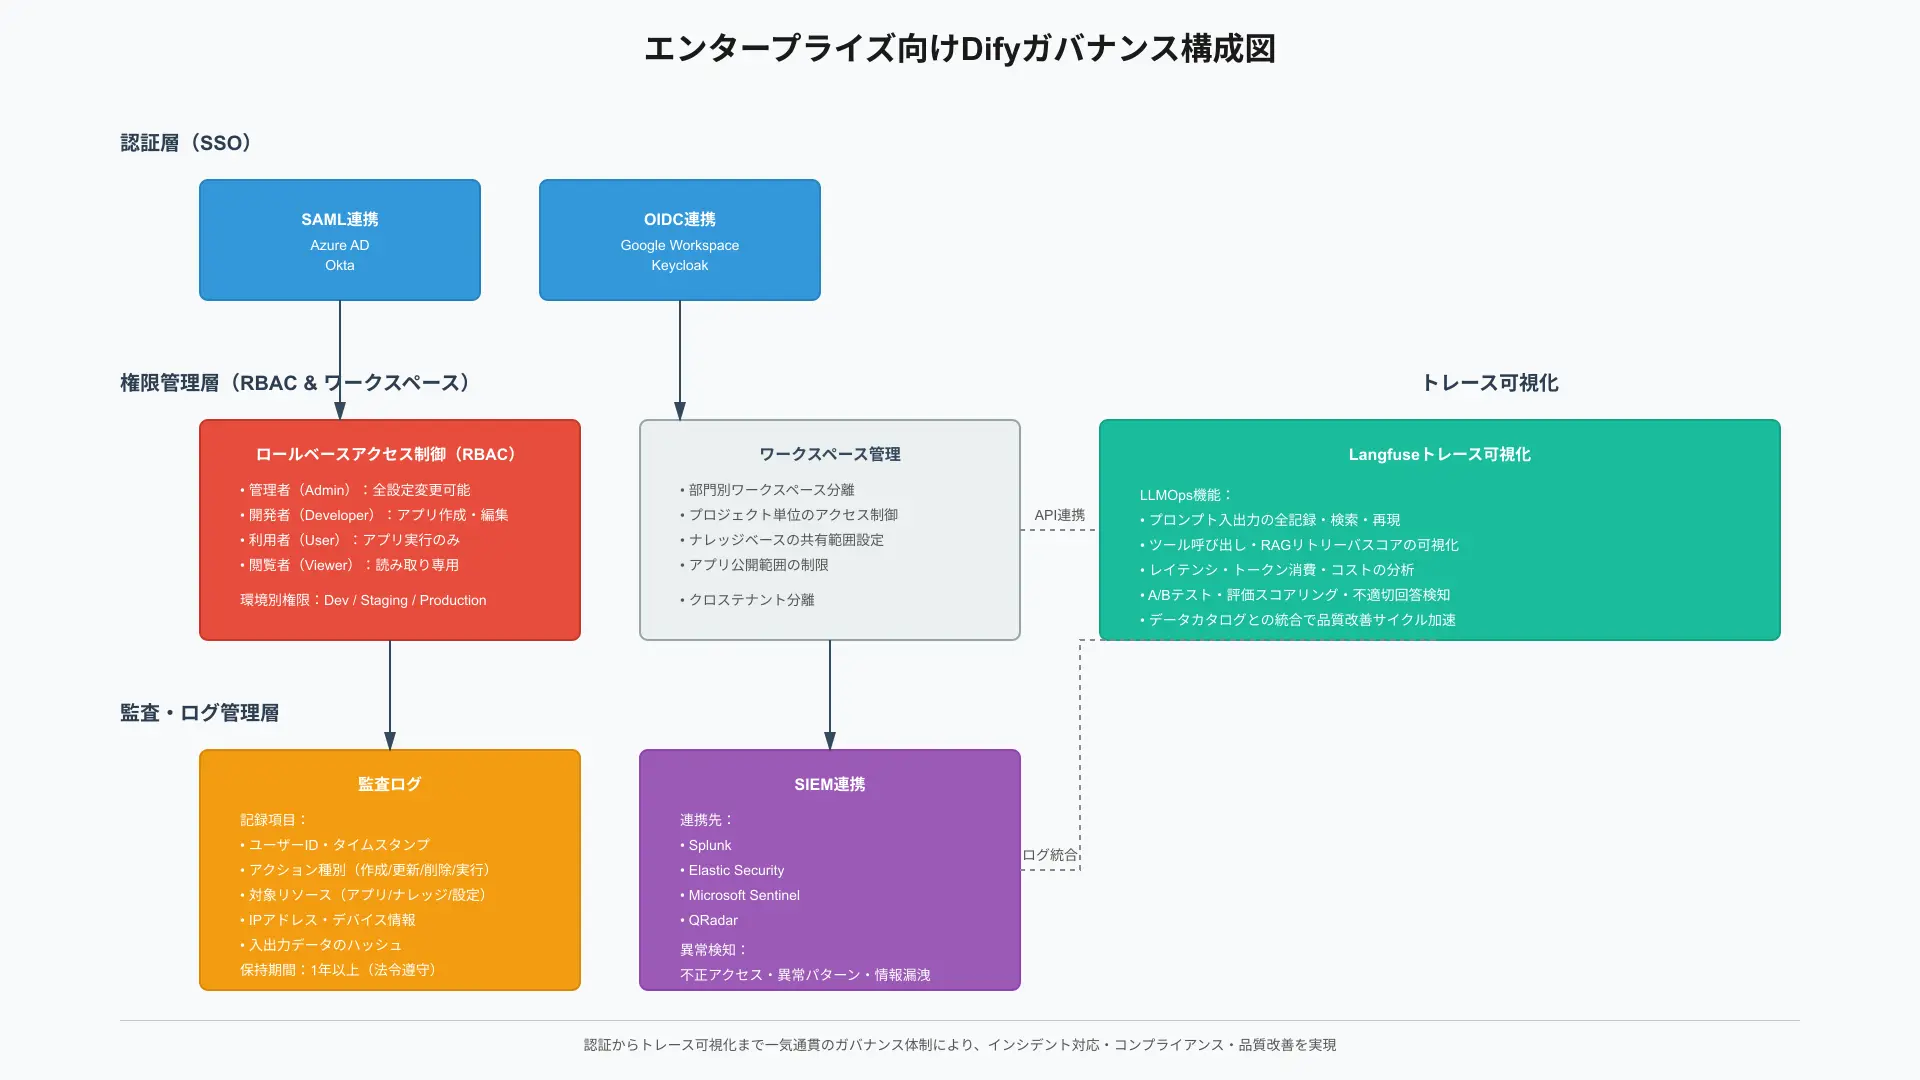
認証・権限管理・監査ログ:PoCから本番に上げるときに必須のガバナンス機能
Azure ADやOktaとのSAML SSO連携を設定し、社員の入退社に応じたアクセス権限を自動同期します。
誰がいつどのナレッジに質問し、どのようなプロンプトを実行したかの全ログを改ざん不能な形で保管します。
厳格な内部統制基準を満たし、コンプライアンス上の懸念を完全に払拭した全社AI運用体制を構築できます。
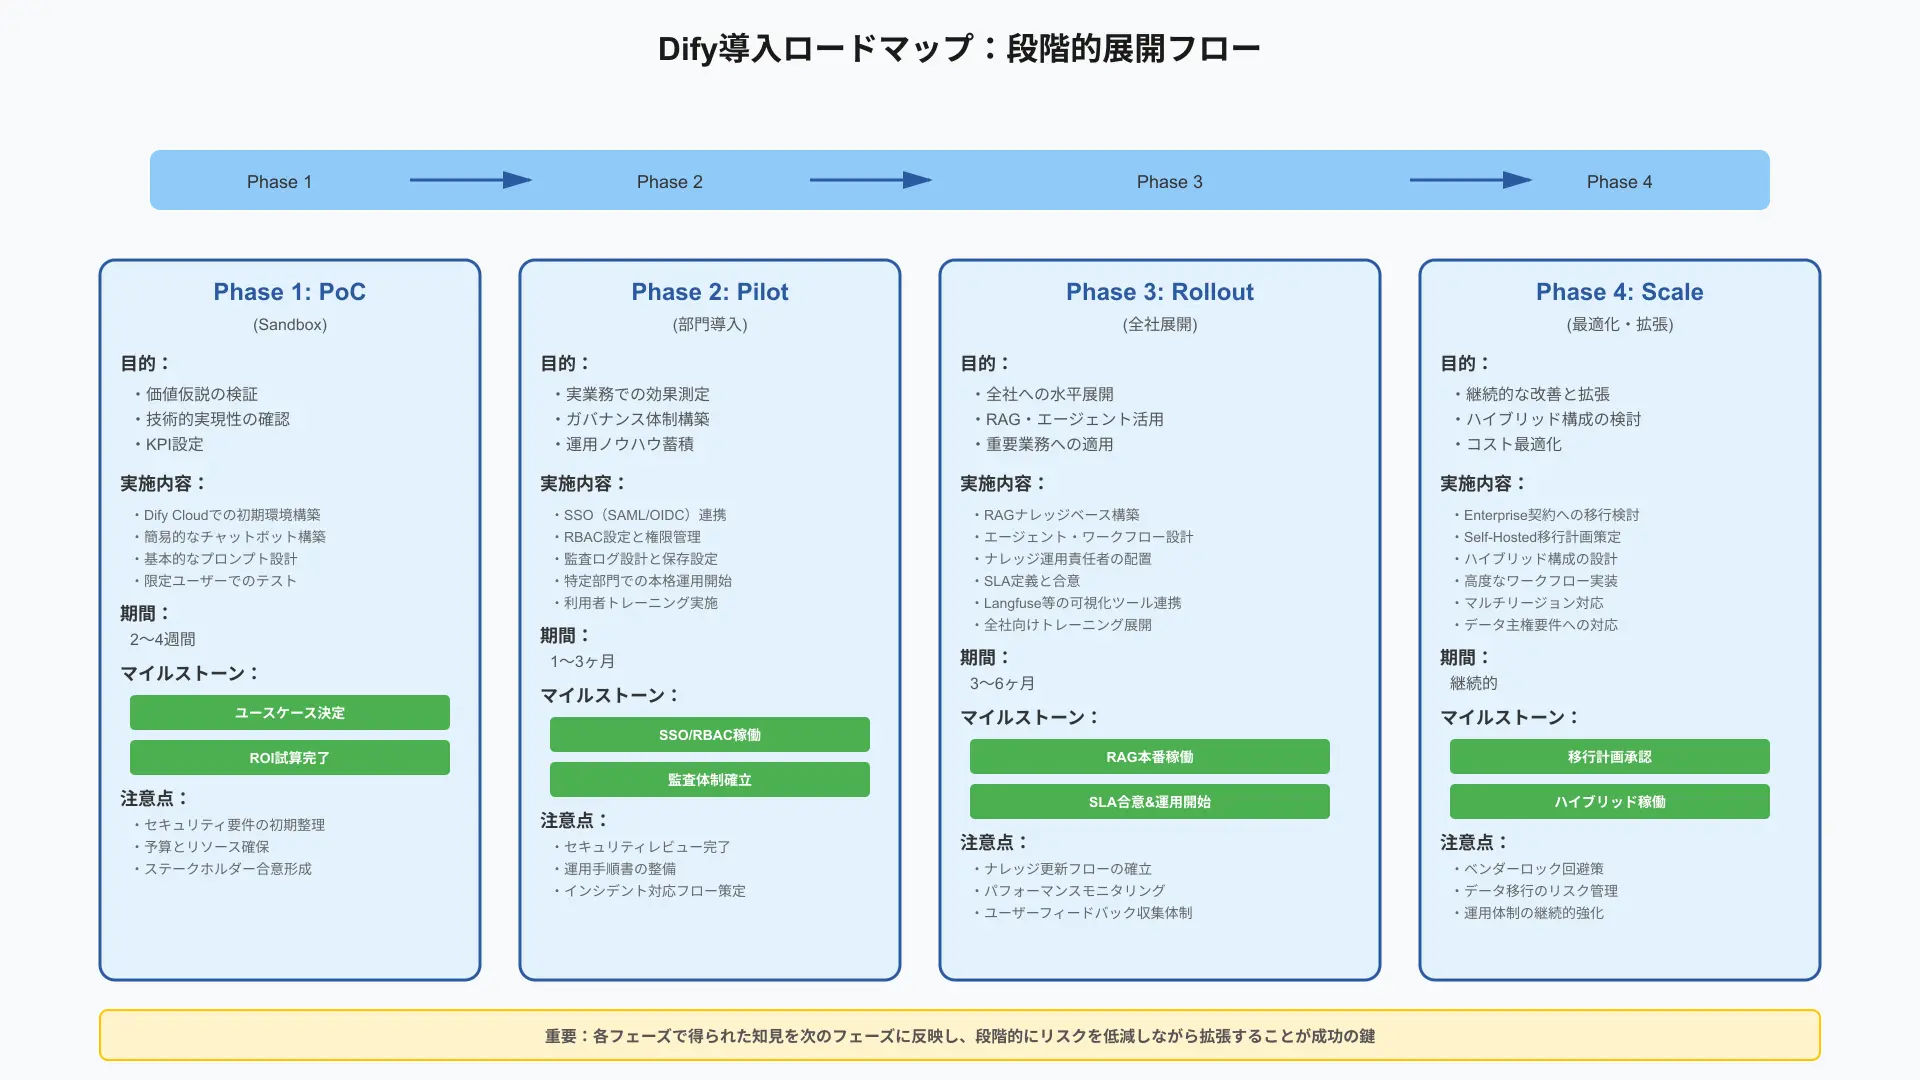
導入・運用フローの実例:小さく始めて全社展開するステップ
まずは特定の部門(人事や総務など)でスモールスタートし、業務改善の成功事例を作ります。
得られたノウハウを社内ポータルで共有し、利用ガイドラインを整備しながら段階的に他部門へ展開します。
無理な一括導入による混乱を避け、現場の熱量を高めながら確実に定着させる全社DXを実現できます。
料金とコスト構造:Difyは本当にコスパが良いのか?
当セクションでは、Difyの料金プランと運用コスト(TCO)の全体像を解説します。
隠れコストを見落とすことなく、費用対効果の高い予算計画を策定できるようになるからです。
Dify Cloudの主要プランと向いている規模感
無料のSandboxプランから、チーム向けProfessional、全社向けTeam/Enterpriseまで段階的に用意されています。
小規模な検証であれば月額数十ドル程度からスタートでき、初期投資を極限まで抑えられます。
プロジェクトの成長に合わせてプランを柔軟にアップグレードし、無駄のないスマートなコスト運用が可能です。
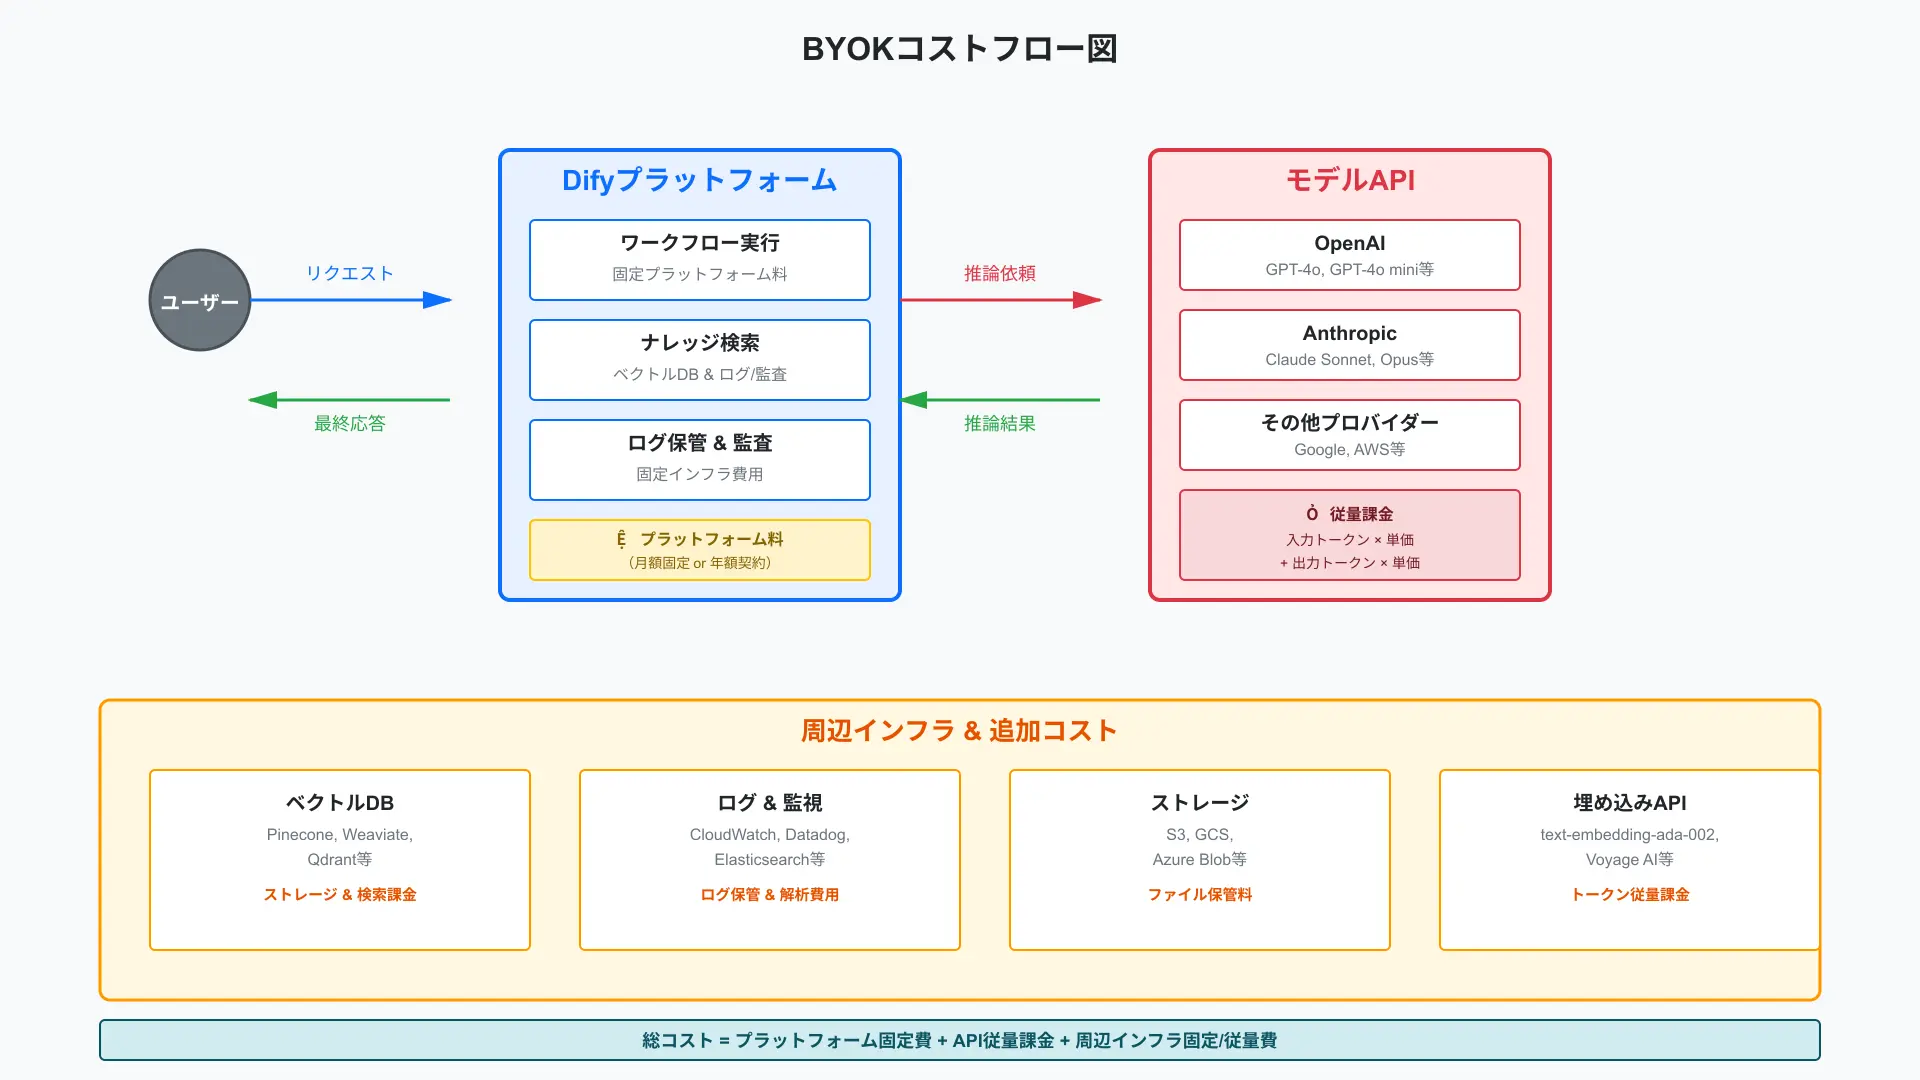
BYOK(自前APIキー持ち込み)時のコスト構造と注意点
自社のOpenAIやAnthropicのAPIキーを登録して利用するため、LLM利用料は直接ベンダーへ支払います。
Dify側で利用トークン数の上限設定やアラートを設定し、想定外の課金爆発を未然に防止します。
透明性の高いコスト管理を行いながら、各部門の利用実績に応じた公平な費用配分を実施できます。
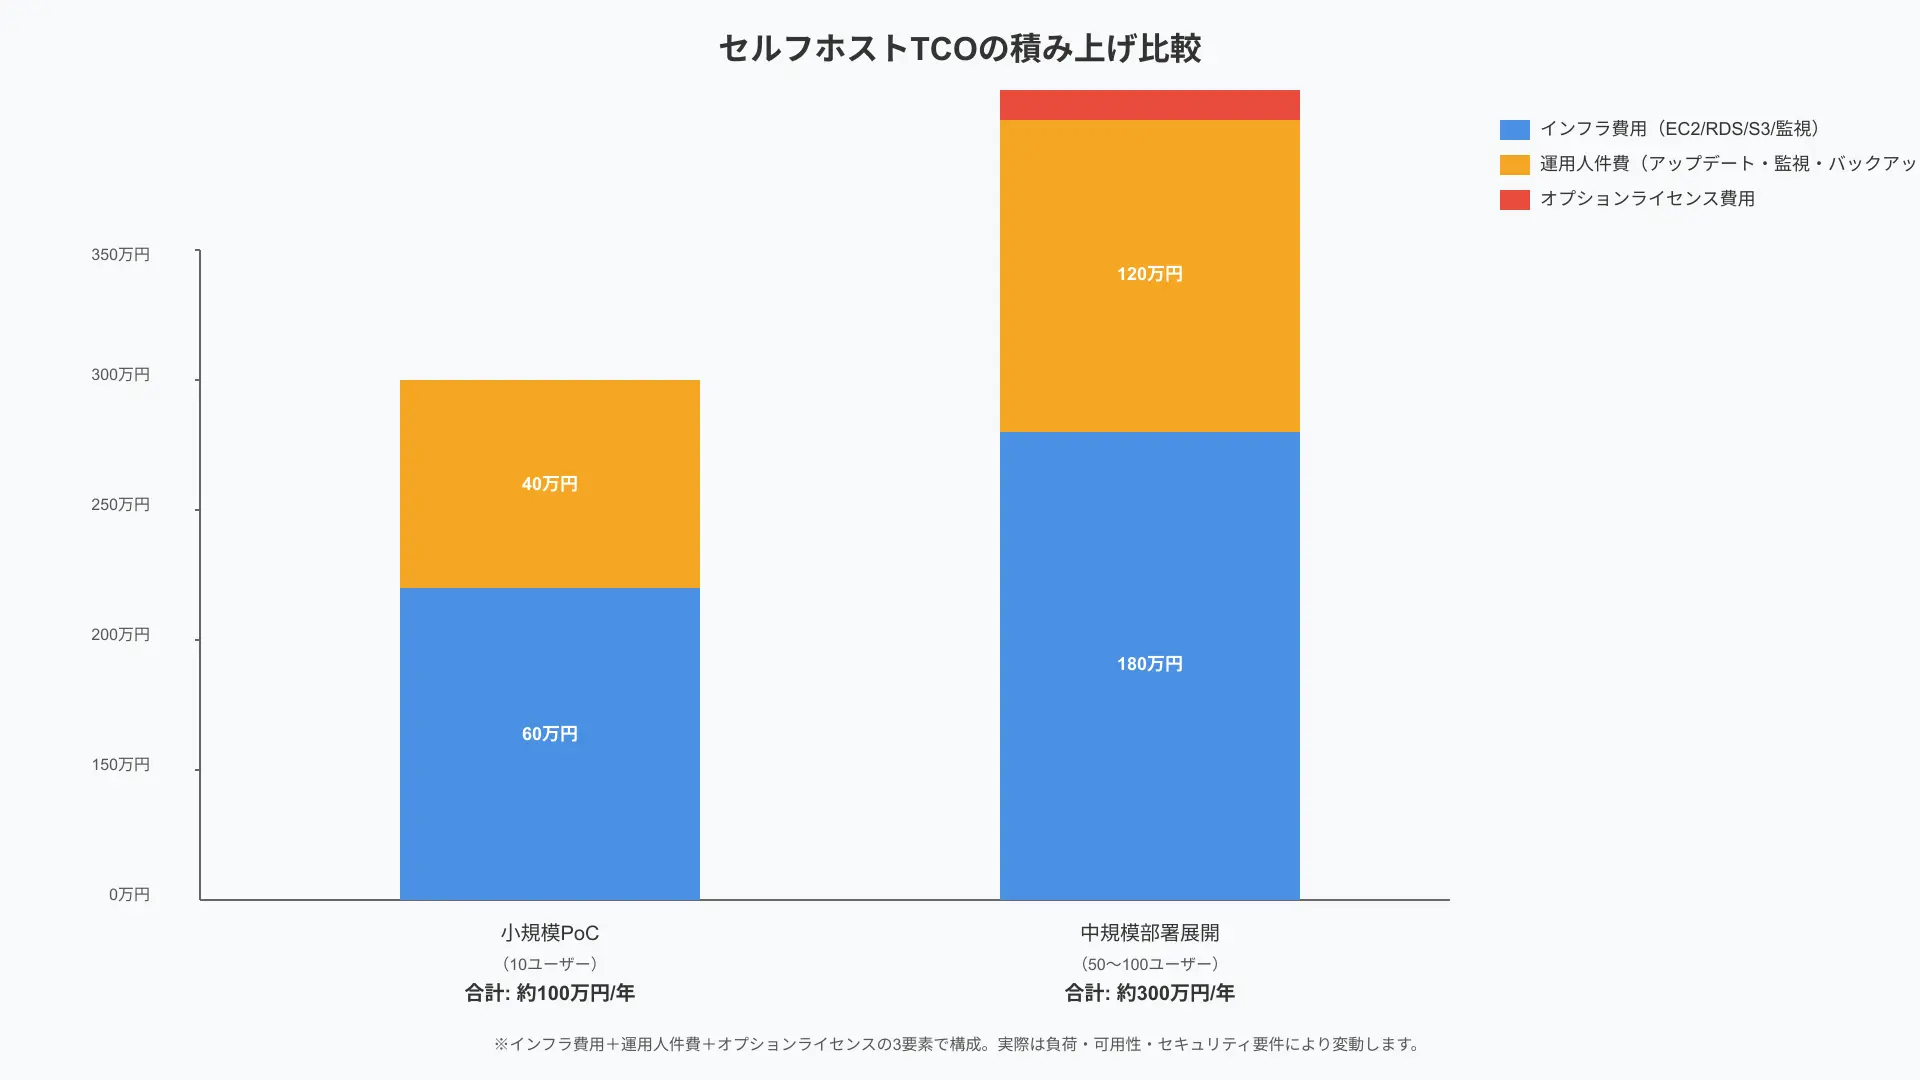
セルフホスト版の“見えにくいコスト”:インフラと保守の現実
オープンソース版はライセンス無料ですが、クラウドサーバー代、ベクトルDB費用、エンジニア保守人件費が発生します。
月間利用規模が小さいうちは、マネージドなDify Cloudを利用した方が総合TCOが圧倒的に低くなります。
表面的なソフトウェア費用だけでなく、運用人件費を含めたトータルTCOで冷静に比較判断することが肝要です。
競合ツールとの比較:LangChain・Flowise・LangFlowとどう使い分けるか
当セクションでは、他の主要AI開発フレームワークとの違いと使い分け基準を解説します。
プロジェクト要件に応じた最適な技術スタックを客観的に選定できるようになるからです。
- コードファーストのLangChain/LangGraphとDifyの棲み分け
- Flowise / LangFlowとの違い:プロトタイプツールか、本番インフラか
- 他のローコードAIプラットフォームと比較したときのDifyの強み・弱み
コードファーストのLangChain/LangGraphとDifyの棲み分け
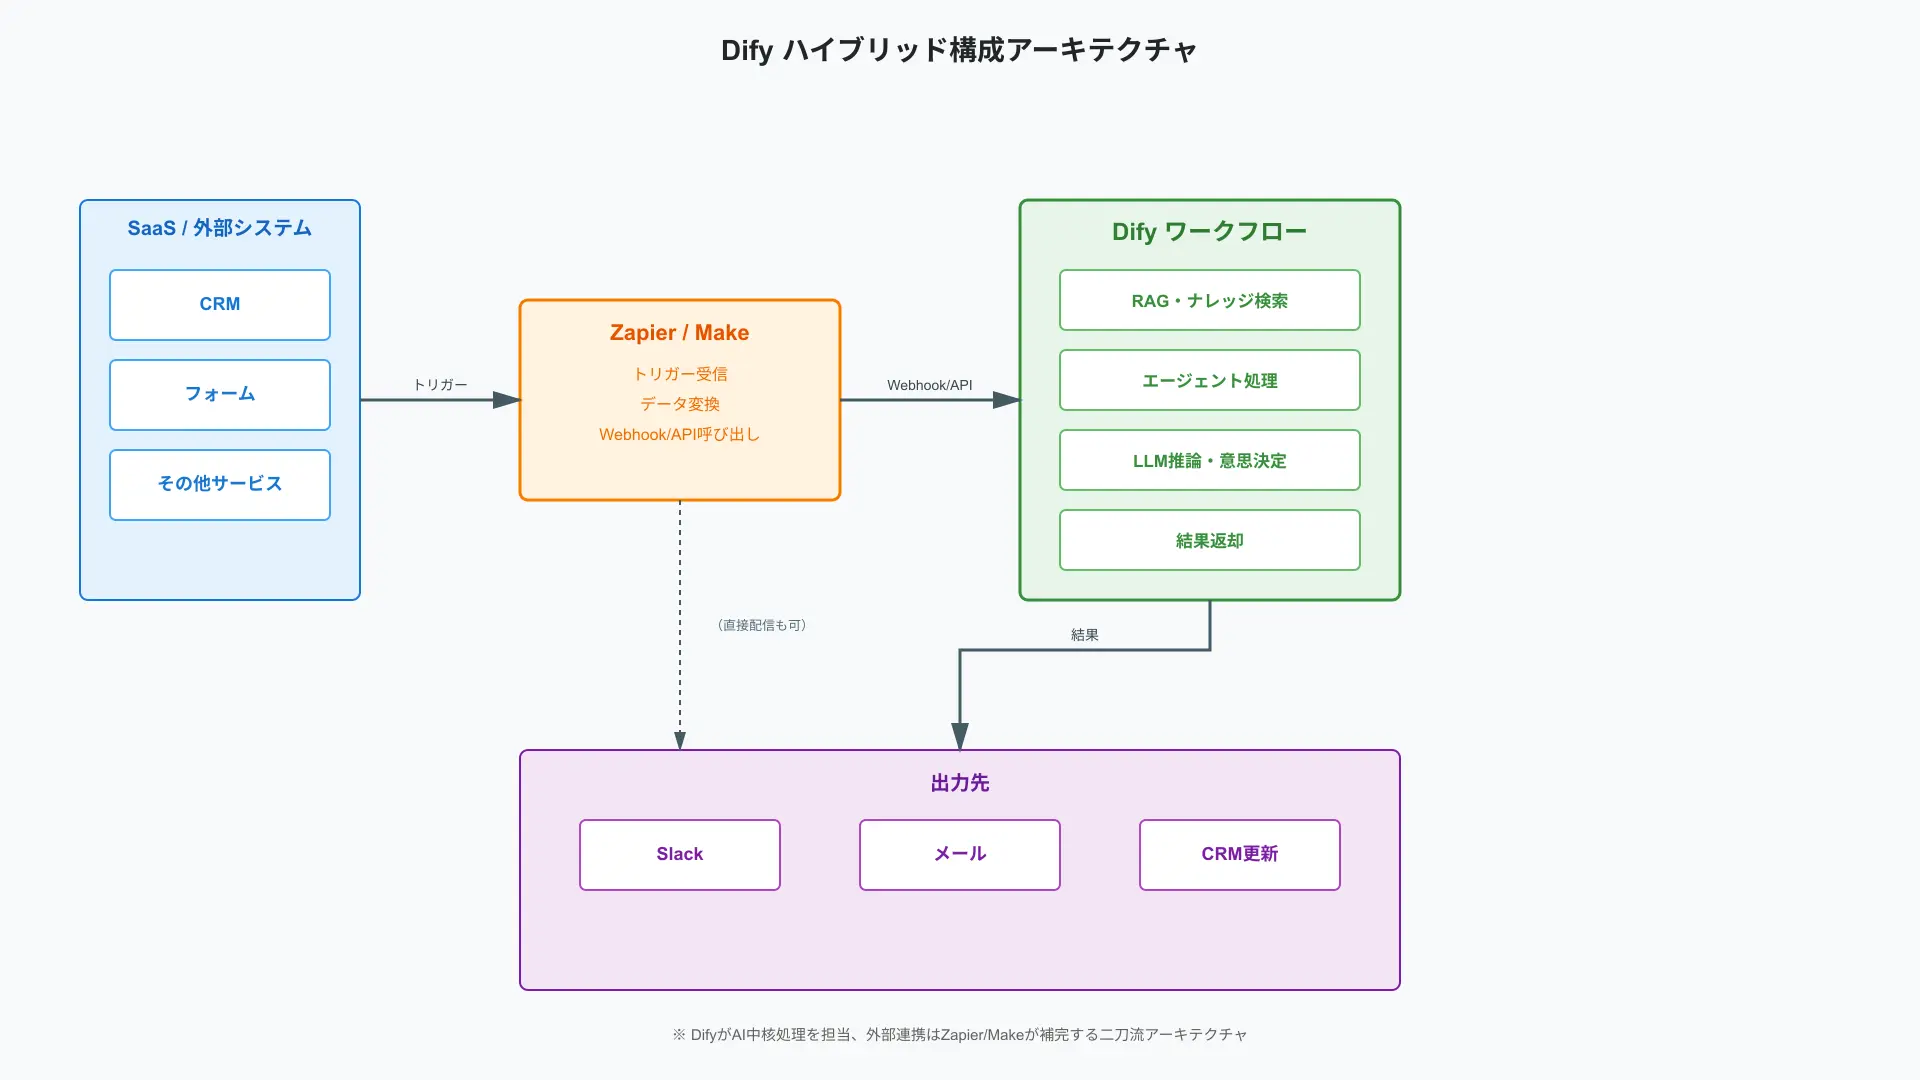
LangGraphはコードによる精密なループ制御に優れ、DifyはUI・RAG・LLMOpsを統合した迅速開発に強みを持ちます。
Difyで構築したワークフローから、特殊ロジックを持つLangGraph APIを呼び出すハイブリッド構成が有効です。
適材適所の役割分担により、開発スピードと高度なカスタマイズ性を両立した理想的な開発体制を築けます。
Flowise / LangFlowとの違い:プロトタイプツールか、本番インフラか
Flowise等は開発者の実験的なプロトタイピングに向いていますが、複数人での本番運用機能は限定的です。
Difyはチーム権限管理、ナレッジの共有、運用ログの可視化が標準で備わっており、本番運用に直結します。
検証だけで終わらせず、社内全体の業務インフラとして定着させるための強固な土台を提供します。
他のローコードAIプラットフォームと比較したときのDifyの強み・弱み
オープンソースコミュニティの圧倒的な活気と、急速な最新機能追従(MCPや最新モデル対応)がDifyの最大の強みです。
一方で、極めて特殊なオンプレミス旧式DBとの直接接続などには一定のカスタム開発が必要となります。
強みと制約を正しく把握し、自社のITエコシステム全体と調和する形で活用しましょう。
Dify導入の実践ステップ:あなたの組織でどう使い始めるか
当セクションでは、組織内でDify導入を成功させるための実践的アプローチを解説します。
初期の挫折を防ぎ、確実な業務効率化の実績を積み上げられるようになるからです。
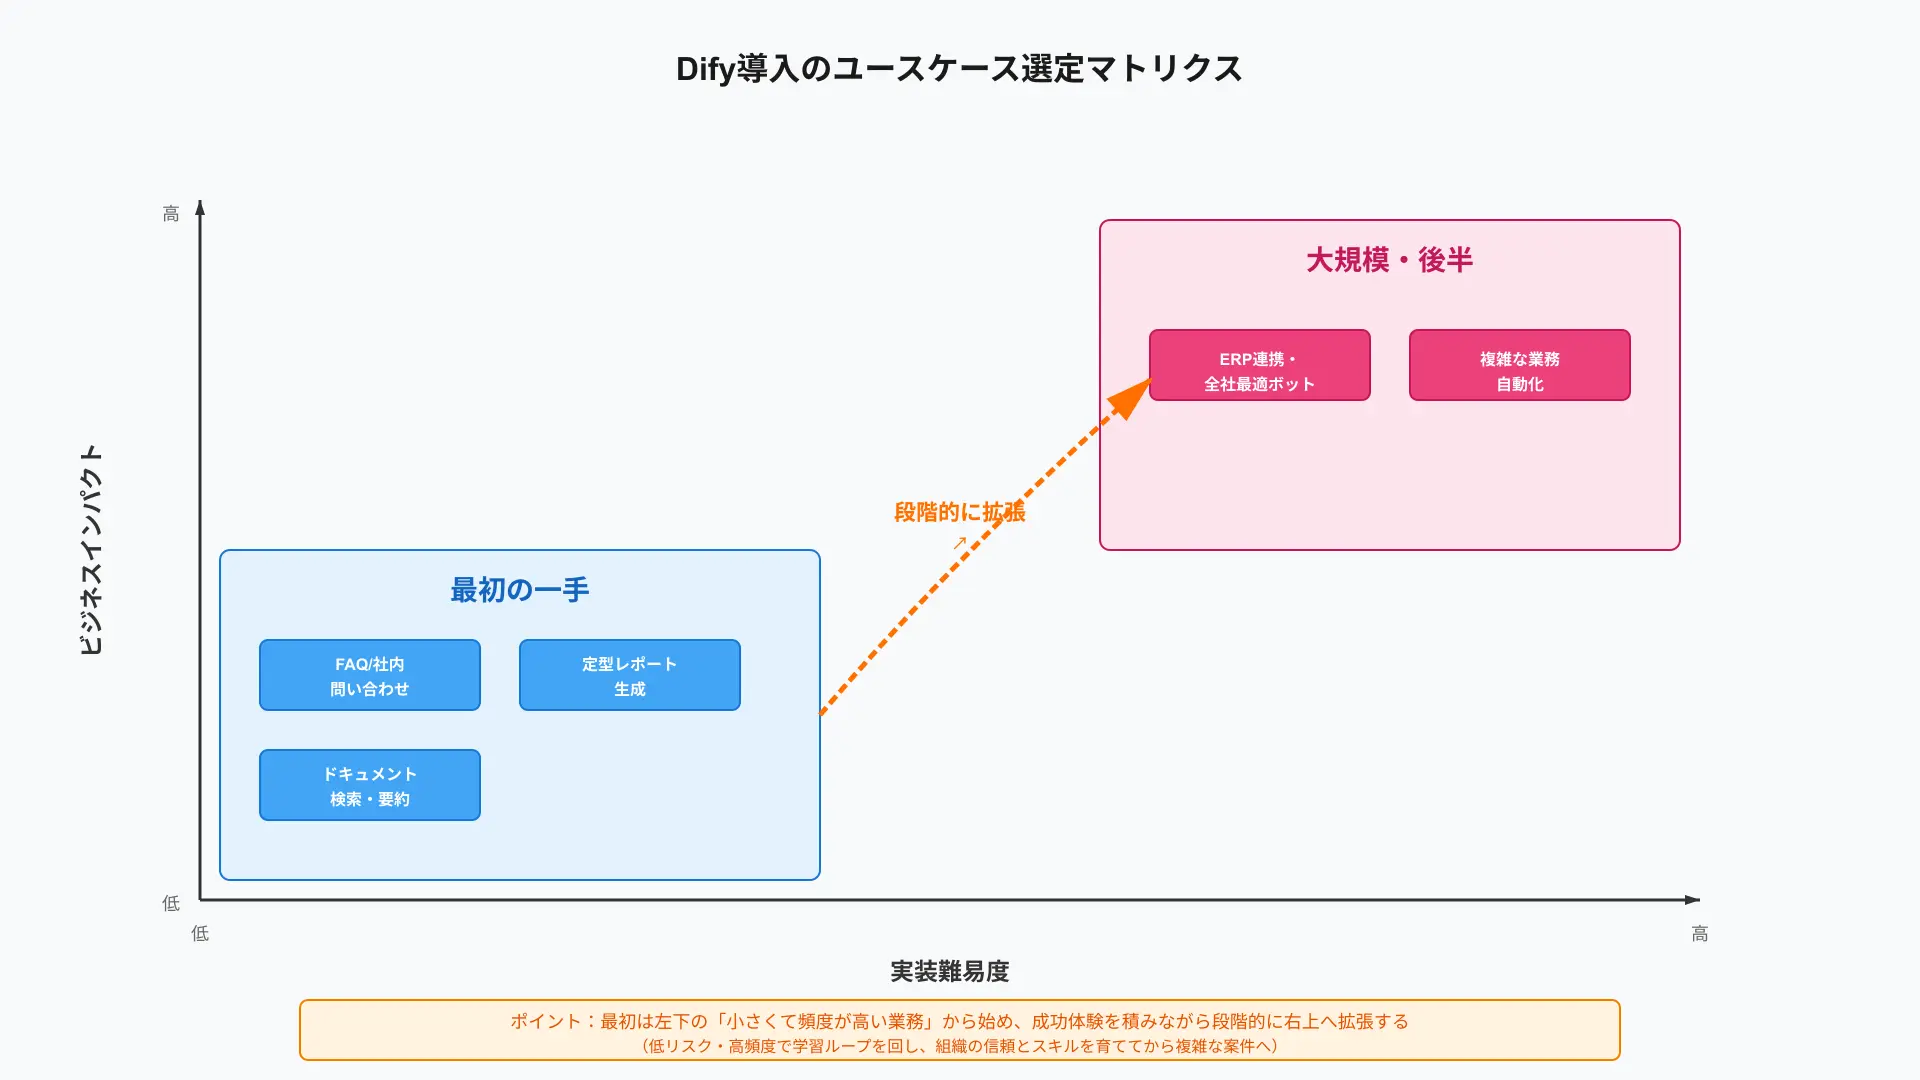
ユースケース選定:最初に狙うべきは「小さくて頻度が高い業務」
いきなり全社横断の巨大システムを目指すのではなく、日報要約や社内規定の質問対応など身近なタスクから着手します。
効果測定が容易で利用頻度が高い業務を選ぶことで、現場の支持を素早く獲得できます。
小さな成功体験を確実に積み上げ、組織内でのAI活用機運を一気に高める起爆剤とします。
PoCから本番までの進め方:ワークフローとRAGをどう段階的に育てるか
初期のPoCでプロンプトとRAGの精度を検証し、現場ユーザーからのフィードバックを反映させます。
回答精度の向上を確認した後にワークフローノードを追加し、承認や通知の自動化へステップアップします。
段階的なアジャイル開発を推進することで、手戻りリスクを最小化しながら本番アプリの完成度を高められます。
組織への展開とナレッジ共有:AIツールを“属人化させない”ために
一部のエンジニアだけでなく、各事業部のリーダーを巻き込んだ勉強会やプロンプト共有会を定期開催します。
優れたテンプレートや成功したワークフローをDify上で共有し、全社的なナレッジ資産として蓄積します。
全社員が自律的にAIを活用して業務を改善する、持続可能で強いAIネイティブ組織へと進化させましょう。
まとめ
Difyは、高精度RAG、視覚的ワークフロー、自律型エージェントを一気通貫で構築できる最強のAI開発プラットフォームです。
リランキングや階層チャンクを駆使したハルシネーション抑制と、柔軟なモデル使い分けにより、実務に直結する業務効率化を実現できます。
まずは身近な定型業務の自動化からスタートし、企業の競争力を飛躍させる社内AI活用を今すぐ推進してください!
【成果持ち帰り型3週間】
研修だけで終わらせない!「自社専用AI」定着パッケージ
「社員がAIを使えない」「自社商材に合わない」を解決。講師がその場で実務用にカスタマイズ。月額10万円〜。
自社に最適なAI基盤を構築し、持続的な業務生産性の向上を勝ち取りましょう。