(最終更新日: 2026年10月10日)
Claude Codeを導入したものの、「プロジェクト独自の開発規約や反復作業をうまく自律化できない」「カスタムスキルを作っても意図したタイミングで起動しない」と悩んでいませんか?
ターミナル完結型エージェントであるClaude Codeは、単体でも高度なコーディング能力を発揮しますが、真の生産性向上を実現する鍵は「/skill-creator」によるカスタムスキルの自作と、Eval(評価)モードを通じた継続的最適化にあります。
本記事では、2026年秋の最新Anthropicモデル体系(Claude Sonnet 5.5、Claude Opus 5.5、Claude Fable 5.1、Claude Haiku 4.5)を前提に、対話型でスキルを自動生成する/skill-creatorの全手順、テストデータ20件を用いたEvalベンチマーク評価と最適化ループ、さらには大規模開発でトークン浪費を防ぐ.claudecodeignoreの設定術まで徹底解説します。
自社プロジェクト専用のAIスキルを体系化し、チーム全体の開発を自律駆動させるための実践知見を今すぐ手に入れましょう!
自律型AIエージェント「Claude Code」と拡張機能「Skill」の基本構造
当セクションでは、Claude Codeが備える自律型エージェント構造と、その能力を組織向けに拡張する「Skill(スキル)」アーキテクチャの全貌について深掘りします。受動的なコード補完ツールとの決定的な違いを理解することが、開発自動化を成功させる強固な第一歩です。
- 従来のコード補完とClaude Code(エージェント型)の決定的な違い
- 組織の暗黙知を形式知化する「Skill」アーキテクチャの全容
- トークンを節約する「段階的開示(Progressive Disclosure)」の仕組み
従来のコード補完とClaude Code(エージェント型)の決定的な違い
従来のAIコーディングツール(GitHub Copilot等のインライン補完や一般的なチャットAI)は、開発者のカーソル位置やプロンプトに対して単一の提案を返す「受動的な1往復支援」に留まっていました。これに対し、Claude Codeは自らゴールまでの計画を立てて試行錯誤を繰り返す「Agentic System(自律型エージェントシステム)」として設計されています。
例えば、「ユーザー認証に多要素認証(MFA)を導入し、テストをパスさせてほしい」と自然言語で指示するだけで、Claude Codeはディレクトリ構造を自律的に探索し、既存の認証ロジックを把握し、必要なパッケージのインストール、コード修正、テストコマンドの実行、そして失敗時の自己修復までを完結させます。
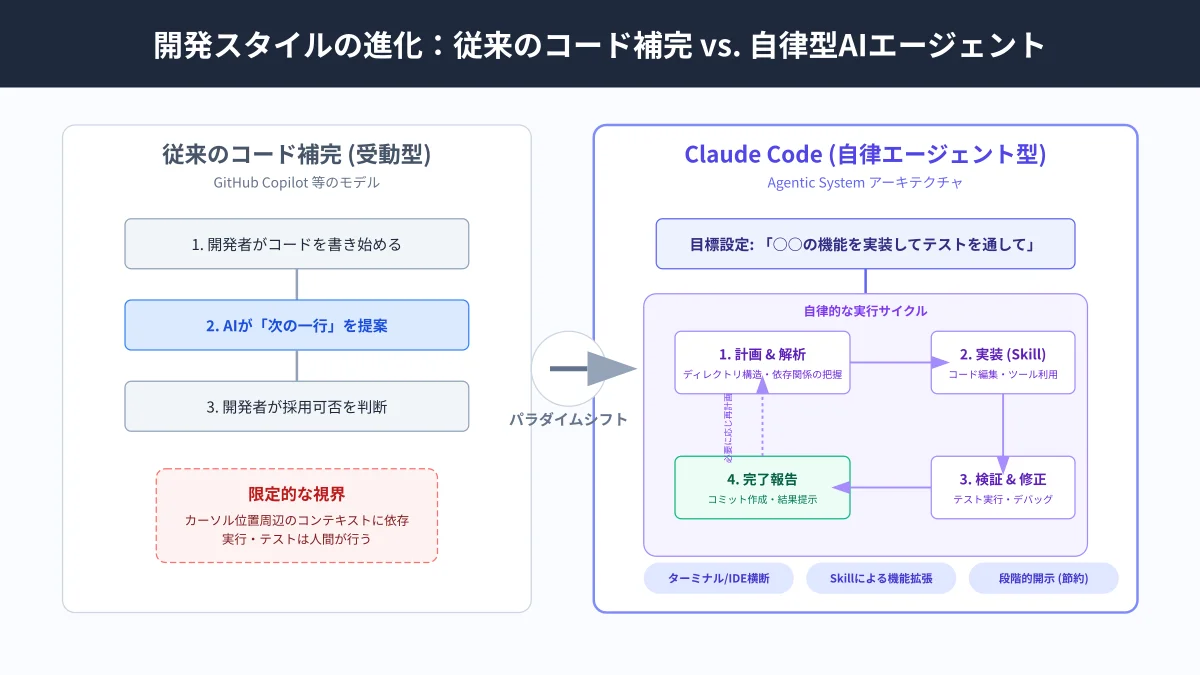
このパラダイムシフトによって、エンジニアは一行ずつのコードタイピングから解放され、「全体の要件定義」や「AIが提案した変更差分の最終レビュー」といった高次の意思決定に専念できるようになります。
最新モデルの特性や選び方については、Claude Codeモデル徹底解説でも詳しく紹介しています。
組織の暗黙知を形式知化する「Skill」アーキテクチャの全容
Claude Codeの拡張機能である「Skill」は、チームやプロジェクト固有の業務ルール・規約をAIに教え込むための「手続き的知識(Procedural Knowledge)のパッケージ」です。
指示書、YAMLメタデータ、参考資料、および実行スクリプトをフォルダ単位で集約することにより、特定のドメイン知識を再現可能な資産としてAIに注入できます(参考: Claude Help Center)。
[カスタムスキルの標準ディレクトリ構造]
my-custom-skill/
├── SKILL.md       # スキル指示書本体(YAMLフロントマター + Markdown本文)
├── reference.md   # ドメイン固有の規約や設計書の参考資料
└── scripts/       # 実行可能な検証スクリプトやツールコード
独自のコーディング標準やデータ移行手順をSkill化しておくことで、新しくプロジェクトに参画したメンバーでも、熟練エンジニアと同等の品質基準でAIにコードを生成させることが可能になります。
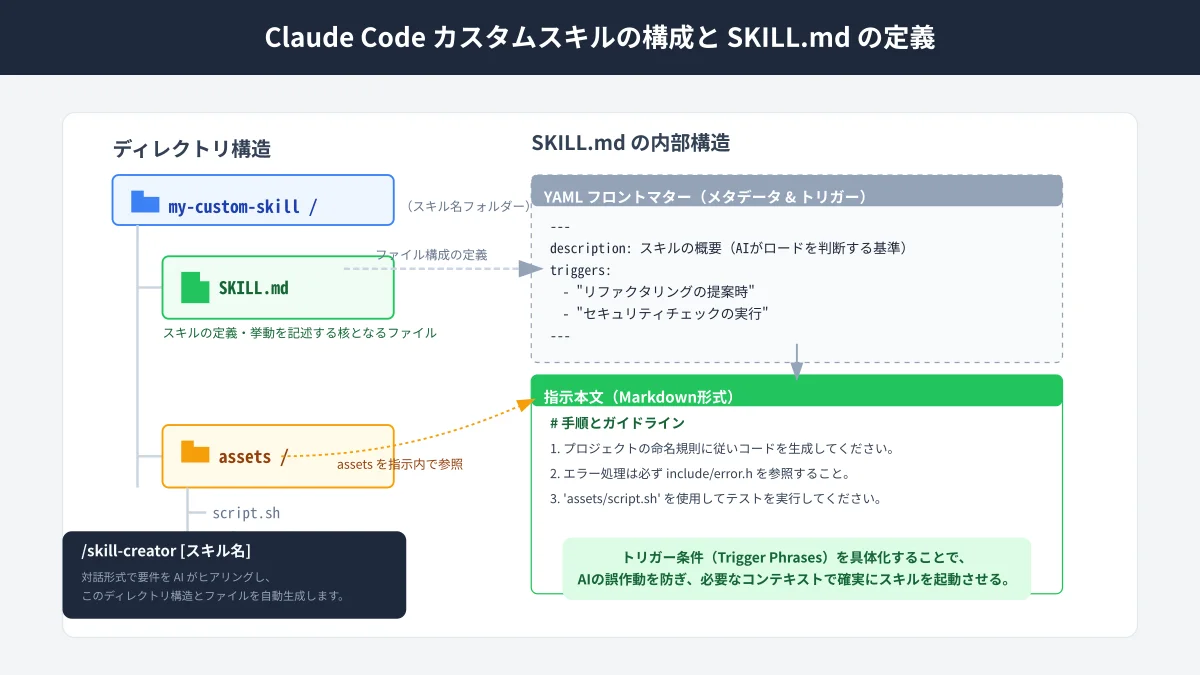
組織全体での安全なスキル運用には、Claude Code権限管理ガイドに沿ったアクセス制御の併用が極めて効果的です。
トークンを節約する「段階的開示(Progressive Disclosure)」の仕組み
数十〜数百のスキルを登録した場合でも、Claude Codeはコンテキストウィンドウ(メモリ領域)を無駄に圧迫しない「段階的開示(Progressive Disclosure)」という洗練された仕組みを採用しています。
セッション開始時に全スキルの長大な本文を一度に読み込むのではなく、常時監視するのはYAMLフロントマター内のnameやdescriptionといった数十トークン程度の軽量なメタデータのみに限定されます。
ユーザーの要求内容がそのスキルの目的と合致したとAIが判断した瞬間にのみ、詳細なSKILL.md本文や補助ファイルが動的にロードされるため、常時高い応答速度と低いトークン消費を維持できるのです。
コスト効率を高めるAPI運用の設計については、Claude Code API料金解説も併せてご参照ください。
/skill-creatorを使い始めるための環境構築と初期設定
当セクションでは、自律型AIエージェント「Claude Code」および拡張コマンド「/skill-creator」を導入するための環境準備と、コストパフォーマンスを最大化する初期設定について解説します。適切な開発基盤を整えることが、スキルの高速なPDCAサイクルを回すための前提条件です。
- Node.js/CLI環境の準備とClaude Codeのインストール手順
- 2026年最新モデル(Claude Sonnet 5.5 / Opus 5.5)とプラン選定
- プロンプトキャッシュを有効化してランニングコストを抑える設定
Node.js/CLI環境の準備とClaude Codeのインストール手順
ローカルマシンにNode.jsランタイムとClaude Code CLIを導入することが、自律型開発をスタートさせる最初のステップです。
ターミナルを開き、公式のnpmパッケージ経由でグローバルインストールを実行します。macOSやLinuxはもちろん、Windows環境であればWSL2(Windows Subsystem for Linux)の利用が強く推奨されます。
[Claude Code インストールコマンド]
npm install -g @anthropic-ai/claude-code

# バージョン確認
claude --versionWSL2環境で権限エラー(EACCES等)が発生した場合は、sudoを乱用するのではなく、npmのグローバルディレクトリの所有権をカレントユーザーに移すことで安全にセットアップできます。
詳しい手順や初期コマンドの使い方は、Claude Code npmインストールガイドで確認可能です。
2026年最新モデル(Claude Sonnet 5.5 / Opus 5.5)とプラン選定
業務で本格的にスキル開発と自律駆動を行う場合、プロジェクトの規模とタスクの複雑性に応じた最適なClaudeモデルとプランの選定が欠かせません。
2026年秋現在、Anthropicが提供する主要モデルの役割分担は以下の通りです。
| モデル名 | 特性・強み | スキル開発における推奨ユースケース |
|---|---|---|
| Claude Sonnet 5.5 | コーディング速度と論理的精度の黄金比。日常開発の主力。 | /skill-creatorによる通常スキル作成、対話型ヒアリング、日常Eval実行 |
| Claude Opus 5.5 | フラッグシップモデル。超大規模リファクタリング・深層推論。 | 複雑なビジネスルールやエッジケースを含むエンタープライズスキル設計 |
| Claude Fable 5.1 | 超長考推論特化型。数時間に及ぶ自律探索・数学的検証。 | 大規模な並行テストスイートの検証、アルゴリズム最適化スキルの構築 |
| Claude Haiku 4.5 | 超高速・軽量モデル。圧倒的な低コスト。 | 大量のEvalテストクエリの高速バッチ実行、フォーマット変換タスク |
個人利用であれば月額20ドルのProプランから開始できますが、フルタイムで複数のスキルを並行稼働・Eval検証させる場合は、利用枠が大幅に拡張されたMax 5x / Max 20xや、企業向けのTeam Premiumの選択が最もコストパフォーマンスに優れます(参考: Claude Help Center)。
プロンプトキャッシュを有効化してランニングコストを抑える設定
API経由でClaude Codeや/skill-creatorを運用する際、ランニングコストを最小化する最大の武器がプロンプトキャッシング(Prompt Caching)です。
プロジェクト全体のソースコードや共通コーディング規約、MCPツール定義などの静的なコンテキストをAnthropic側のサーバーに一時保持させることで、2回目以降のリクエストにおいて入力トークンコストを最大90%削減できます。
Claude Sonnet 5.5やOpus 5.5では、同一キャッシュが自動的に再利用されるため、数時間におよぶ対話型スキル作成やEvalテストの反復を行っても、課金コストを極めて低く抑えられます。
/skill-creatorによるカスタムスキルの自動生成とSKILL.mdの定義
当セクションでは、/skill-creatorコマンドを用いたスキルの自動生成プロセスと、その設計図となるSKILL.mdの定義手法について解説します。手作業で長大なプロンプトを執筆することなく、AIとの対話を通じて高品質なスキルを素早く具現化できるのが本機能の真骨頂です。
- /skill-creatorコマンドによる対話型要件定義の流れ
- スキルの設計図「SKILL.md」の構成要素とYAMLフロントマター
- トリガー条件(Trigger Phrases)を具体化し誤作動を防ぐコツ
/skill-creatorコマンドによる対話型要件定義の流れ
ターミナルでClaude Codeセッションを起動し、以下のようにコマンドを実行することで、対話型のスキル作成ウィザードが始まります。
[skill-creatorの起動]
$ claude
> /skill-creator rspec-generator
コマンドを実行すると、AIエージェントが「このスキルで達成したい目的は何ですか?」「利用するテストライブラリ(FactoryBot、WebMock等)の指定はありますか?」「ディレクトリ配置や命名規則の指定は?」といった具体的な要件を段階的にヒアリングしてきます。
開発者はこれらの質問に答えるだけで、AIが要件を構造化し、ベストプラクティスに準拠したSKILL.mdファイルを自動生成してくれます。
全体のベストプラクティスについてはClaude Code完全ガイドもあわせてご確認ください。
スキルの設計図「SKILL.md」の構成要素とYAMLフロントマター
生成されたスキルの中心となるのが、Markdown形式で記述されるSKILL.mdです。ファイル先頭のYAMLフロントマターには、スキルのメタデータと動作条件を定義します。
---
name: rspec-generator
description: RailsプロジェクトにおいてモデルやサービスのRSpecテストファイルを規約に沿って自動生成・更新するスキル
tools: [ReadFile, EditFile, Bash, GlobTool]
---
フロントマターに続いて、以下のように本文へ明確な指示を記述します。
# RSpecテスト生成ルール
当リポジトリでRSpecファイルを生成・改修する際は、以下の規約を厳格に遵守してください。

1. ファイル配置: spec/models/ または spec/services/ 配下に配置する。
2. モック基準: 外部API通信には必ず WebMock を使用し、テスト実行時の外部リクエストを禁止する。
3. カバレッジ: 正常系(正常な値の保存)と異常系(バリデーションエラー)を必ず網羅する。フロントマターのdescriptionは、AIが「今このスキルをロードすべきか」を判断する最も重要な基準となります。ここに具体的な役割とキーワードを漏れなく記述することが精度の要です。
設定ファイルの全容は、CLAUDE.md完全ガイドでも詳しく解説しています。
トリガー条件(Trigger Phrases)を具体化し誤作動を防ぐコツ
スキルが意図した場面で確実に発火し、関係のない文脈での誤起動(Over-triggering)を防ぐためには、トリガーフレーズの書き方に工夫が必要です。
単に「テストを作成するスキル」と曖昧に書くのではなく、以下のように具体的な状況と発火条件を明確に指定することが推奨されます。
- 具体的な動詞と対象の明記: 「RSpecファイルの新規作成、または既存テストの修正が要求された際に起動する」
- 先回りルールの付与: 「ユーザーが明示的にテスト作成を指示していなくても、新規サービス層のコードを追加した際は自動でテスト生成を提案する」
- 除外条件の指定: 「フロントエンド(TypeScript/Jest)のテスト要求時は起動しない」
このように境界線を厳密に定義することで、誤作動を排除し、必要なときに確実に機能する信頼性の高いスキルが完成します。
Evalモードを活用したスキル精度の検証と最適化ループの回し方
当セクションでは、主要検索キーワードである「claude code skill eval」「skill-creator eval」の核心となる、Evalモードを活用した客観的ベンチマーク検証と自動最適化ループの手法を解説します。職人の勘に頼らず、定量的なデータに基づいてスキルの品質を保証する最先端の仕組みです。
20件のテストデータを自動生成する「Evalクエリ」の仕組み
スキルを作成した後、/skill-creator eval [スキル名] コマンドを実行すると、AIがスキルの定義内容に基づいてテストケースを自動生成します。
このEvalクエリ生成機能は、スキルが起動すべき「should-trigger」パターン(約10件)と、似た文脈だが起動してはならない「should-not-trigger」パターン(約10件)の計20件をJSON形式で構築します。
[生成されるEvalテストケース例]
{
  "id": "eval-01",
  "query": "Userモデルに電話番号のバリデーションを追加したのでテストを書いて",
  "expected_trigger": true,
  "rationale": "RSpecテストの新規生成・改修に合致するため発火すべき"
},
{
  "id": "eval-02",
  "query": "ReactのコンポーネントにJestでユニットテストを追加して",
  "expected_trigger": false,
  "rationale": "フロントエンドテストであり、Rails/RSpecスキルの責務外"
}
エッジケースを含めた多角的なテストデータが自律的に用意されるため、開発者が手動で検証用プロンプトを考案する負担が大幅に軽減されます。
HTML評価ビューアを使った手動レビューと承認プロセス
Evalテストの実行結果は、ブラウザで確認できる専用のローカルHTML評価ビューアに出力されます。
ビューア上には、20件のテストクエリに対する「AIのトリガー判定結果」「期待値との一致状況(Pass / Fail)」「消費トークン数」「出力差分」がグラフィカルに一覧表示されます。
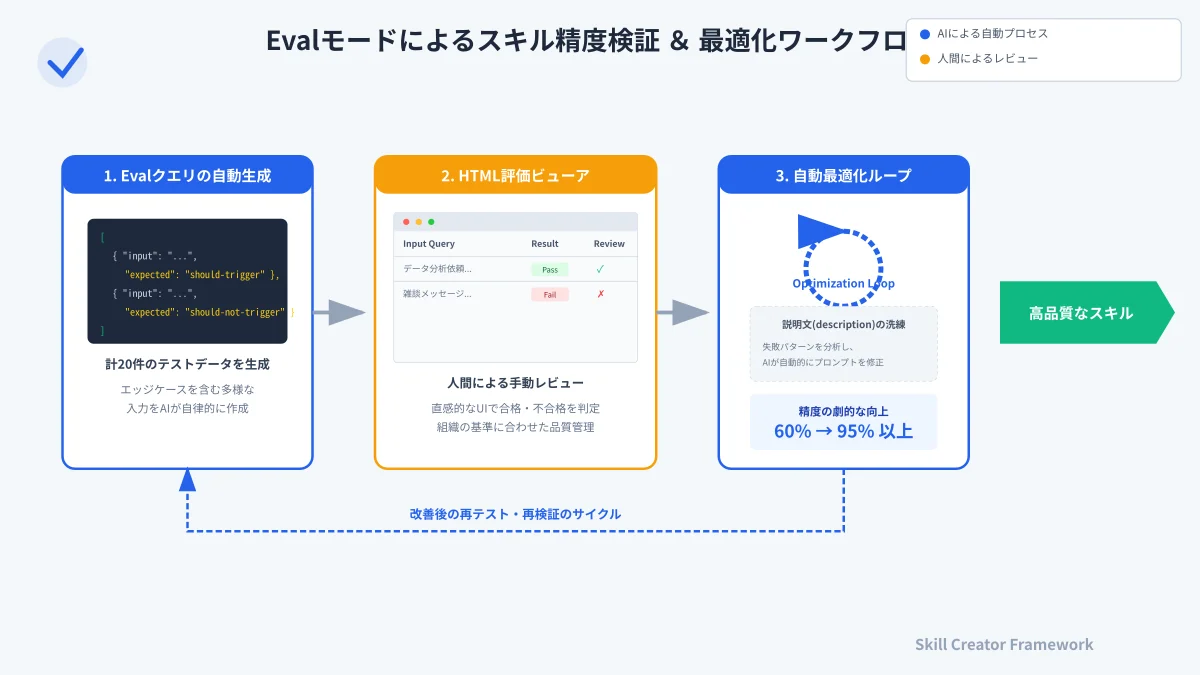
開発者はUI上で失敗したテストケース(誤って起動した、または起動しなかった)を確認し、ワンクリックでフィードバックを与えることができます。この手動レビューのステップを挟むことで、AIの独走を防ぎ、チームの品質要件を確実に担保できます。
自動最適化ループ(Optimization loop)で説明文を磨き上げる
レビューで不合格となったケースが存在する場合、AIは自動最適化ループ(Optimization loop)を開始します。
失敗した理由をAI自らが分析し、SKILL.mdのフロントマター(descriptionやトリガー文)を動的にリライトして再テストを自動実行します。このループを数回繰り返すことで、初期状態で70%前後だった判定精度が95%〜100%の高精度にまで引き上げられます。
プロンプトの微妙な語句調整に人間が何時間も頭を抱える必要はなく、機械的な最適化ループに任せることで、誰でもプロ水準のAIスキルを量産できるのです。
エンタープライズ導入の障壁を突破するセキュリティとガバナンス
当セクションでは、企業が自社の重要コードや機密データを保護しながら、安全にClaude Codeとカスタムスキルを展開するためのセキュリティ基盤を解説します。自律動作するエージェントだからこそ、ゼロトラストに基づく防御が不可欠です。
- OSレベルのサンドボックス(Seatbelt/bubblewrap)による隔離
- ファイルシステムへの「Deny/Ask/Allow」権限管理の設計
- ゼロデータ保持(ZDR)ポリシーと機密情報の取り扱い規約
OSレベルのサンドボックス(Seatbelt/bubblewrap)による隔離
自律型AIにターミナル操作を委ねる際、最大の懸念はシステムファイルの誤削除や不正な外部通信です。Claude Codeはこのリスクを排除するため、OSカーネルレベルの隔離環境を標準採用しています。
macOSでは「Seatbelt」、Linux環境では「bubblewrap」を利用し、AIが起動するすべての子プロセスを厳格なサンドボックス内に封じ込めます(参考: Claude Code Docs)。
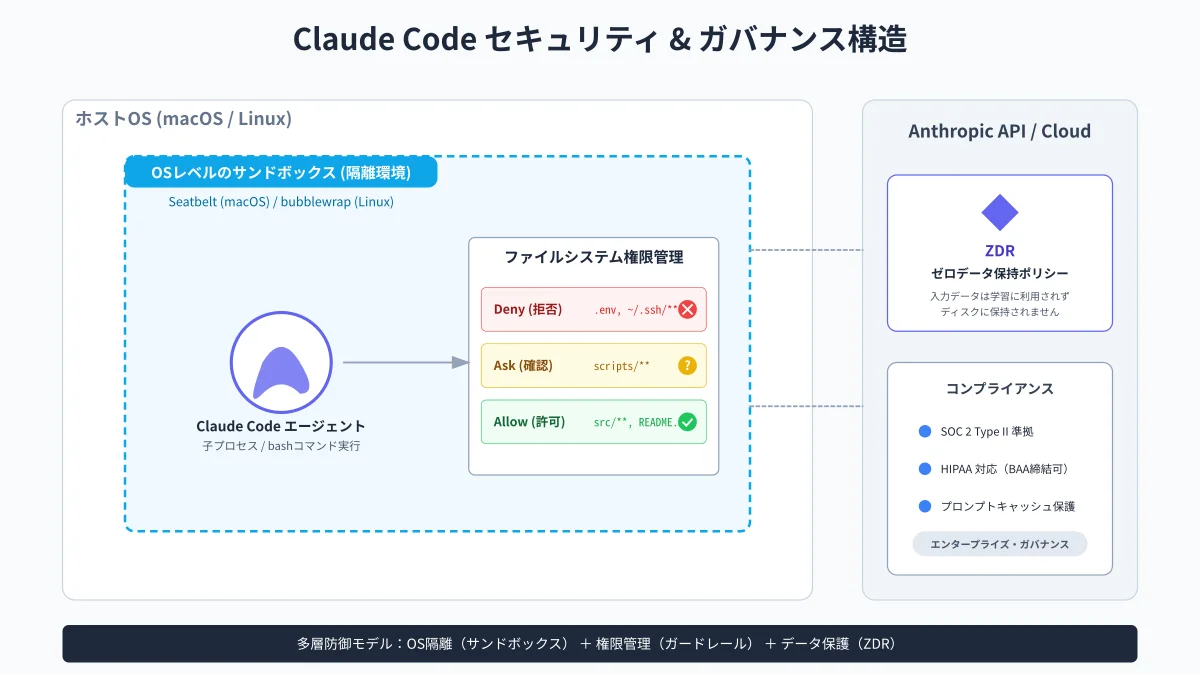
この仕組みにより、仮に未知のスクリプトを実行した場合でも、ホストOS本体への破壊的影響を物理的に防止できます。
ファイルシステムへの「Deny/Ask/Allow」権限管理の設計
ファイルアクセスに関しては、管理者が「Deny(拒否)」「Ask(確認)」「Allow(許可)」の3層で制御する権限モデルを構築できます。
機密ファイルが含まれるパスを厳格に保護しつつ、日常のソースコード編集はスムーズに行わせるための設定例は以下の通りです。
[アクセス制御設定例]
{
  "permissions": [
    { "path": ".env*", "access": "deny" },
    { "path": "secrets/*", "access": "deny" },
    { "path": "src/*", "access": "allow" },
    { "path": "scripts/*", "access": "ask" }
  ],
  "defaultMode": "plan"
}このように設定することで、AIが機密情報にアクセスしようとした瞬間にリクエストを拒否し、情報漏洩を未然に防ぐことができます。運用の詳細は権限管理完全ガイドにまとめています。
ゼロデータ保持(ZDR)ポリシーと機密情報の取り扱い規約
エンタープライズ導入における法的安全性を担保するのが、Anthropicのゼロデータ保持(ZDR: Zero Data Retention)ポリシーです。
商用プラン(TeamおよびEnterprise)では、送信されたコードやプロンプトがモデルの学習データとして使用されることは一切ありません(学習除外)。さらにSOC 2 Type II認証を取得しており、金融・医療をはじめとする機密要件の厳しい業界でも安心して活用できます(参考: Anthropic Trust Center)。
開発効率を劇的に向上させるカスタムスキルの具体例3選
当セクションでは、実際の開発現場で絶大な効果を発揮するカスタムスキルの具体的な実装パターンを3つ紹介します。スキルの設計イメージを掴むための参考にしてください。
プロジェクト固有のボイラープレート生成スキルの実装
新規機能の立ち上げ時に発生する定型コードの作成を自動化するスキルです。Next.js App Router、Tailwind CSS、Zodバリデーションを組み合わせたAPIルートの雛形を一瞬で作成します。
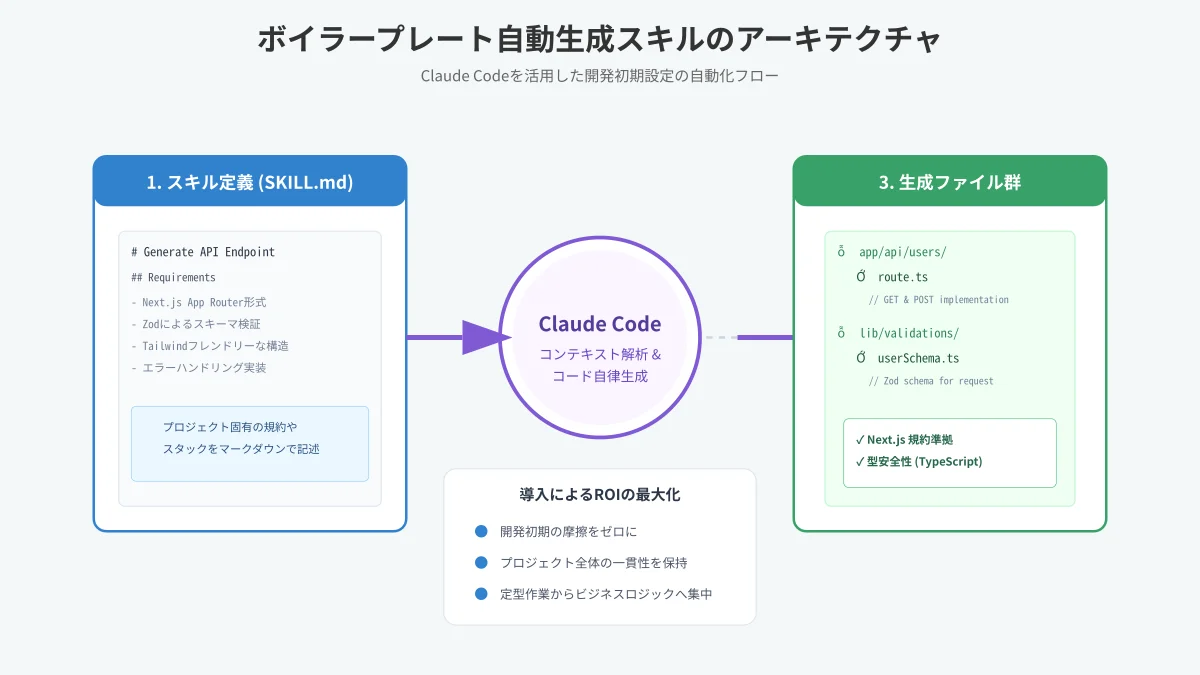
# Generate API Route Boilerplate
新規APIエンドポイントを作成する際は以下の手順を自動実行してください。
1. app/api/[feature]/route.ts を作成する。
2. リクエストスキーマを Zod で定義し、バリデーションエラー時は400を返却する。
3. 正常系レスポンスは統一フォーマット { success: true, data: ... } を適用する。初期構造の統一により、エンジニア間のコード品質のばらつきをゼロに抑えられます。初期設定の流れはClaude Code init完全ガイドでも解説しています。
複雑なビジネスロジックのドキュメント(README)自動生成
コード変更が行われた際、実装と仕様書の乖離を防ぐためにドキュメントを自律更新するスキルです。
複雑な決済処理や権限ロジックの変更差分を検知し、非エンジニアや後続のレビュー担当者が直感的に理解できるよう、フローチャート(Mermaid記法)付きの解説ドキュメントを自動生成します。
チーム規約に沿ったリファクタリングを1コマンドで実行
レビューで繰り返し指摘されがちな命名規則のブレや、マジックナンバーのハードコード、古い非推奨APIの使用を1コマンドで一括修正するスキルです。
先輩エンジニアの指摘事項をルールとしてSKILL.mdに蓄積していくことで、チーム全体のコードベースが常に最高水準のクリーンさを保ち続けます。ルールの体系化手法はルール設定ガイドをご確認ください。
失敗しないためのトラブルシューティングとFAQ
当セクションでは、Claude CodeやSkill Creatorの運用時に直面しやすい技術的な疑問やトラブルの解決策をQ&A形式で解説します。
- スキルが意図したタイミングで起動しない(Under-triggering)時の対処
- MCP(Model Context Protocol)とSkillの使い分け判断基準
- 大規模リポジトリでのトークン枯渇を防ぐ「.claudecodeignore」設定術
スキルが意図したタイミングで起動しない(Under-triggering)時の対処
スキルが意図した文脈でロードされない場合、最も一般的な原因はフロントマターのdescriptionが抽象的すぎることです。
「テスト作成スキル」のような短い説明では、AIがタスクを汎用コード生成と見なしてしまい、スキルをロードしません。これを解消するには、「Railsプロジェクトでモデルやコントローラのテスト(RSpec)を追加・修正する際は必ずこのスキルを起動せよ」といった具体的かつ強制力の高い指示(Pushy description)に書き換えるのが有効です。Evalモードを再実行してトリガー精度を確認してください。
MCP(Model Context Protocol)とSkillの使い分け判断基準
外部ツール接続の「MCP」と社内ナレッジの「Skill」は、「接続窓口(道具)」と「業務手順書(知恵)」の違いで整理するのが明快です。
MCPはデータベースやGitHubなどの外部サービスへAPI接続する手段を提供し、Skillはそのツールを使って「どのようなルールで作業を進めるか」というビジネスロジックを指示します。
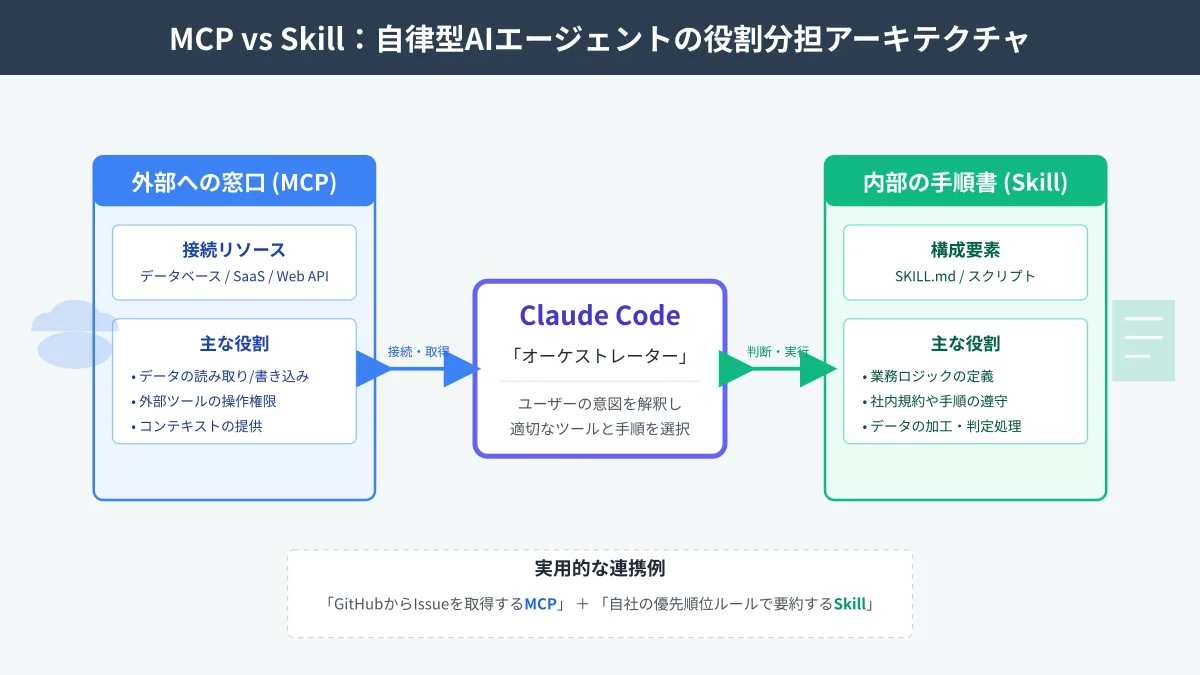
両者を組み合わせることで、「GitHub MCPでIssueを取得し、自社規約Skillに基づいてコードを自動修正する」といった洗練されたワークフローが実現します。
大規模リポジトリでのトークン枯渇を防ぐ「.claudecodeignore」設定術
大規模なリポジトリで作業する際、AIの応答遅延や不要なトークン消費を引き起こす最大の原因が、不要な巨大ファイルの読み込みです。
これを防ぐためには、プロジェクトルートに.claudecodeignoreを配置し、AIの探索対象から明示的に除外する設定が極めて重要です。
[.claudecodeignore の推奨設定例]
# 依存関係・ビルド成果物
node_modules/
dist/
build/
.next/
vendor/

# 機密ファイル・環境変数
.env*
*.pem
*.key

# 巨大なメディア・ログファイル
*.log
*.sqlite
coverage/
assets/images/
public/videos/.gitignoreに加えて.claudecodeignoreを適切に整備することで、AIが注目すべきコード情報のみを高密度で読み込めるようになり、レスポンス速度と推論精度が大幅に向上します。
まとめ
本記事では、Claude Codeの拡張機能「Skill」の基礎構造から、/skill-creatorによる対話型スキル生成、Evalモードを用いたベンチマーク評価と自動最適化ループ、最新モデル(Claude Sonnet 5.5等)の活用法、そして.claudecodeignoreによるトークン最適化まで徹底解説しました。
AIを単なるチャットボットとして使う時代は終わり、組織独自の暗黙知を「スキル」としてコード化し、自律的にプロジェクトを前進させる「エージェント型開発」がこれからの標準となります。まずは身近な定型タスクから/skill-creatorでスキル化し、自社専用のAIパートナーを育ててみてください。
【成果持ち帰り型3週間】
研修だけで終わらせない!「自社専用AI」定着パッケージ
「社員がAIを使えない」「自社商材に合わない」を解決。講師がその場で実務用にカスタマイズ。月額10万円〜。