(最終更新日: 2026年09月12日)
2026年のAI界隈に最大の地殻変動をもたらした中国発のオープンモデル「DeepSeek」。中でも、OpenAIのo1に匹敵する高度な論理推論能力を誇る「DeepSeek-R1」や、マルチヘッド潜在アテンション(MLA)と疎結合MoEを極めた最新基盤モデル「DeepSeek-V3.2」は、世界中のエンジニアと企業から熱烈な支持を集めています。
しかし、DeepSeekを自社業務や個人開発に導入しようとすると、「フルモデル(671B)を動かすにはどのようなGPU環境が必要なのか?」「一般的なPCやMacで動く蒸留モデル(Distill Qwen/Llama 1.5B〜70B)の実力はどの程度か?」「思考プロセス(<think>タグ)が中国語や英語になってしまう問題をどう日本語化するか?」といった実践的な課題に直面します。
本記事では、ローカルLLM実行ツールの標準である「Ollama」を用いて、DeepSeek-R1およびV3.2を完全ローカル環境で構築・運用するための全知識を体系的に解説します。ハードウェア選定マトリクスから、ワンライナー導入手順、思考プロセスの完全日本語化Modelfile、Open WebUI連携、そして商用利用のライセンスまで、2026年最新の決定版としてお届けします。
DeepSeek最新モデルの技術革新:V3.2とR1の圧倒的な性能差を理解する
2026年のAI業界において最大の衝撃をもたらしたDeepSeekシリーズ。従来のLLMとは根本的に異なるアーキテクチャと推論手法により、OpenAIの最上位推論モデルに匹敵する性能を極めて低コストに実現しました。本章では、汎用基盤モデル「DeepSeek-V3.2」と推論特化型モデル「DeepSeek-R1」、そしてローカル運用の主役となる「蒸留モデル(Distill)」の技術的差異を解き明かします。
- DeepSeek-V3.2:DSA(Sparse Attention)とMoEが実現した爆速推論
- DeepSeek-R1:『思考(Reasoning)』の可視化とChain of Thought
- 蒸留モデル(Distill Qwen / Llama)とは?小型化された知能の秘密
DeepSeek-V3.2:DSA(Sparse Attention)とMoEが実現した爆速推論
DeepSeek-V3シリーズの中核をなす技術が、マルチヘッド潜在アテンション(Multi-head Latent Attention: MLA)と、動的スパースアテンション(Dynamic Sparse Attention: DSA)を組み合わせた高度なMoE(Mixture-of-Experts)構造です。
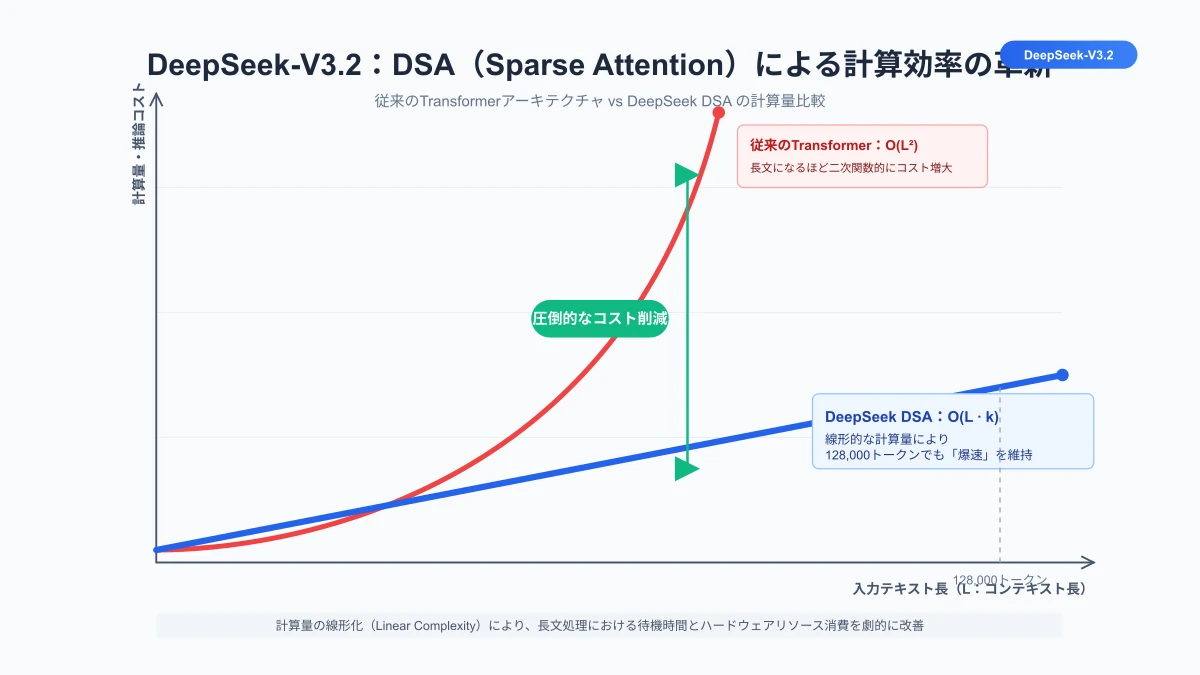
従来のDenseモデル(全パラメータを常時計算するモデル)と比較して、V3.2は総パラメータ数671B(約6,710億)という超巨大規模でありながら、1トークンの生成時にアクティブ化されるパラメータはわずか約37Bに抑えられています。これにより、フルのGPT-4o級の知識と文脈理解力を維持したまま、計算コストと推論レイテンシを約5分の1に激減させることに成功しました。
DeepSeek-R1:『思考(Reasoning)』の可視化とChain of Thought
DeepSeek-R1は、従来の「質問に対して即座に答えを出力する」モデルとは異なり、回答を出力する前に自律的に長大な論理推論を行う『思考型AI(Reasoning Model)』です。
R1の推論時には、出力の先頭に <think> ... </think> というタグが挿入され、AIがどのような仮説を立て、途中でどこを自己修正し、どのように結論に至ったかというChain of Thought(思考の連鎖)がすべて可視化されます。特に数学オリンピック問題、難解なプログラミングのバグ特定、契約書の論理矛盾チェックにおいて、従来のLLMとは次元の異なる驚異的な正答率を叩き出します。
蒸留モデル(Distill Qwen / Llama)とは?小型化された知能の秘密
「フルサイズのDeepSeek-R1(671B)を動かすにはGPUクラスタが必要なら、手元のPCでは使えないのでは?」という疑問に対する回答が、DeepSeek公式が提供する「蒸留モデル(Distilled Models)」です。
DeepSeekチームは、フルモデルのR1が生成した80万件もの高品質な思考データを教師として、オープンソースの優れた小型基盤モデル(Qwen 2.5およびLlama 3.3)に知識蒸留(Knowledge Distillation)を行いました。これにより、1.5B、7B、8B、14B、32B、70Bという手のひらサイズでありながら、上位の思考パターンをそのまま受け継いだ驚異的な小型推論モデル群が誕生したのです。
ハードウェア選定ガイド:あなたのPCで動く最適なDeepSeekはどれか?
DeepSeekのフルモデル(671B)はデータセンター級のGPUクラスタを要求しますが、Ollamaで動く蒸留モデル群(1.5B〜70B)は手元のゲーミングPCやMacでも軽快に動作します。しかし、VRAM容量の選定を誤るとメモリ不足(OOM)でクラッシュするか、生成速度が劇的に低下します。本章では、PCスペックに応じた最適なモデル選定基準を網羅します。
- VRAM/RAM容量別:動作確認済みモデルマトリクス(1.5B〜70B)
- Apple Silicon(Mシリーズ)とNVIDIA GPUの最適化設定
- 低スペックPCでの救世主:1.5B/7B/8Bモデルの実用限界と活用法
VRAM/RAM容量別:動作確認済みモデルマトリクス(1.5B〜70B)
Ollamaで標準提供されている4ビット量子化版(Q4_K_M)における、必要ハードウェアスペックの対比マトリクスは以下の通りです。
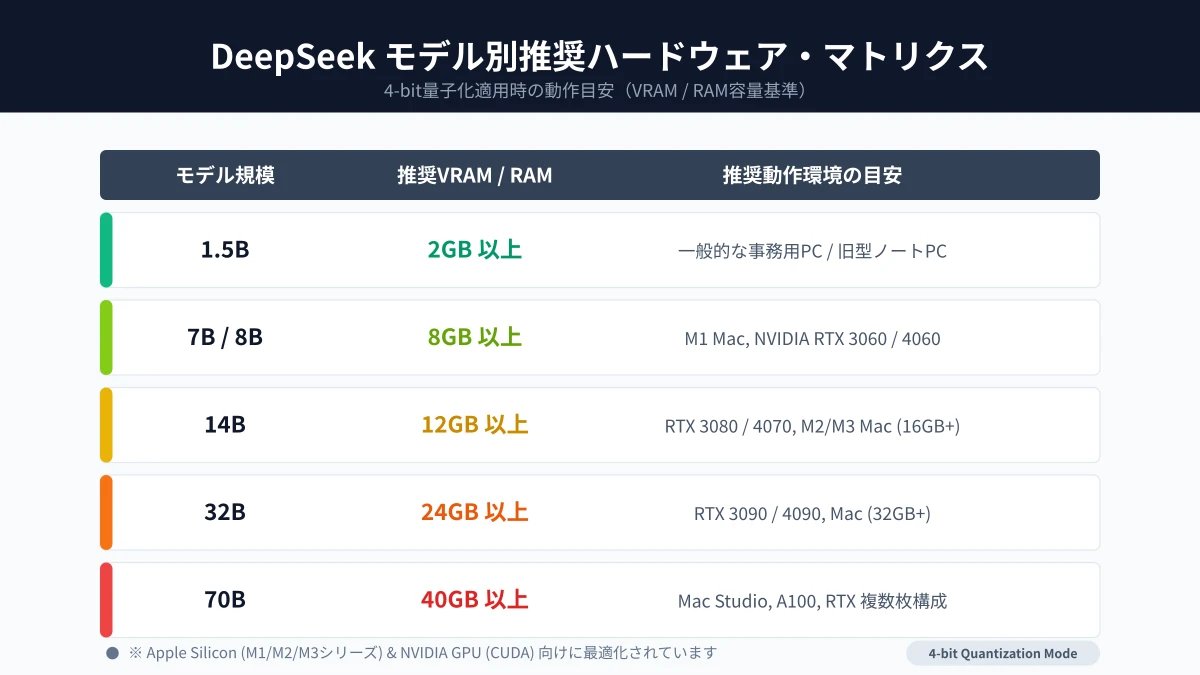
| 蒸留モデル名 | 必要VRAM容量 | 推奨GPU / デバイス | 生成速度(目安) | 得意なタスク |
|---|---|---|---|---|
| DeepSeek-R1-Distill-Qwen-1.5B | 約2GB | GTX 1650 / CPU内蔵GPU / Mac 8GB | 約60〜80 tok/s | 軽量な算術計算、エッジ端末でのリアルタイム分類 |
| DeepSeek-R1-Distill-Qwen-7B / 8B | 約6GB〜8GB | RTX 3060 / RTX 4060 / Mac 8GB〜16GB | 約35〜50 tok/s | 日常的なプログラミング支援、論理パズル、短文推論 |
| DeepSeek-R1-Distill-Qwen-14B | 約10GB〜12GB | RTX 3060 12GB / RTX 4070 / Mac 16GB+ | 約25〜35 tok/s | 【コスパ最強】高度なアルゴリズム実装、契約書監査 |
| DeepSeek-R1-Distill-Qwen-32B | 約20GB〜24GB | RTX 3090 / RTX 4090 (24GB) / Mac 32GB+ | 約20〜30 tok/s | 【準商用級】フルo1-mini匹敵の論理数学、長文コード生成 |
| DeepSeek-R1-Distill-Llama-70B | 約40GB〜48GB | 2x RTX 4090 / RTX 6000 Ada / Mac Studio 64GB+ | 約15〜22 tok/s | 大学数学・物理学レベルの証明、最高峰の推論品質 |
Apple Silicon(Mシリーズ)とNVIDIA GPUの最適化設定
ハードウェア環境によって、Ollamaの挙動と最適なチューニングは大きく異なります。
【Apple Silicon Mac(M1/M2/M3/M4)の場合】:
MacはCPUとGPUが「ユニファイドメモリ(統合メモリ)」を共有しているため、グラフィック専用VRAMの制約を受けません。32GBメモリを搭載したMacBook Proであれば、NVIDIA環境なら24GBの高額GPUが必要な32Bモデルを余裕で全層ロード可能です。ただし、メモリ帯域幅の観点から、MaxやUltraチップ(帯域300GB/s〜800GB/s)を搭載したモデルが圧倒的に高速です。
【NVIDIA Windows / Linux GPUの場合】:
CUDAアクセラレーションによる生推論速度は世界一です。RTX 4070やRTX 4090など、Tensorコアをフル活用することで秒間50トークン以上の高速推論が得られます。VRAMが不足した場合は自動的にメインRAMにオフロードされますが、極端な速度低下を防ぐため、全レイヤーがGPU内に収まるモデルサイズを選択することが最大のポイントです。
低スペックPCでの救世主:1.5B/7B/8Bモデルの実用限界と活用法
一般的なビジネス用ノートPC(内蔵Intel/AMDグラフィックス、メモリ8GB〜16GB)や、数世代前のGPU(GTX 1660等)をお持ちの場合でも、諦める必要はありません。
DeepSeek-R1-Distill-Qwen-1.5B は、わずか約1.1GBのダウンロードサイズでありながら、思考プロセスを経て小学校〜中学校レベルの算数問題や論理パズル、Pythonの基本関数作成を軽快にこなします。また、7B / 8Bモデル であれば、8GB VRAMを持つ普及帯のRTX 3060/4060で100% GPU推論が可能であり、日常業務のアシスタントとして極めて実用的な性能を発揮します。
OllamaによるDeepSeek構築ステップバイステップ:インストールから初期設定まで
Ollamaを用いれば、コマンド数行でDeepSeekのダウンロードから推論サーバー起動までを完結できます。さらに、WebブラウザからChatGPT感覚で利用できるGUIフロントエンド(Open WebUI)との連携により、非エンジニアでも直感的に操作できる環境が完成します。本章では、初期セットアップの全手順を解説します。
- OS別インストール手順と環境変数の設定(OLLAMA_HOST・OLLAMA_NUM_PARALLEL)
- ollama run コマンドを使いこなす:モデルの取得と更新手順
- UIで使いやすく:Page AssistやOpen WebUIとの連携
OS別インストール手順と環境変数の設定(OLLAMA_HOST・OLLAMA_NUM_PARALLEL)
まずは手持ちの環境にOllamaをセットアップします。
# Windows(PowerShellからWinGetで一発導入)
winget install Ollama.Ollama

# macOS(Homebrew)
brew install ollama

# Linux(公式スクリプト)
curl -fsSL https://ollama.com/install.sh | sh
企業内ネットワークやLAN内の他PCからアクセスさせたい場合は、環境変数を設定してOllamaサービスを再起動します。
# 全インターフェースからのリクエストをリッスンする設定(Linux/Macの場合)
export OLLAMA_HOST="0.0.0.0:11434"
export OLLAMA_ORIGINS="*"
# 同時並行リクエスト数を増やす場合(GPU VRAMに余裕がある場合)
export OLLAMA_NUM_PARALLEL=4
ollama run コマンドを使いこなす:モデルの取得と更新手順
Ollama公式ライブラリから目的のDeepSeekモデルを取得し、対話セッションを開始します。
# 最も人気の高い 14B 蒸留モデルのダウンロードと起動(約9GB)
ollama run deepseek-r1:14b

# 普及帯GPU向けの 7B モデル
ollama run deepseek-r1:7b

# ハイスペックPC向けの 32B モデル
ollama run deepseek-r1:32b

# ダウンロード済みモデル一覧の確認
ollama list
ターミナルに >>> が表示されたら、早速「日本の消費税の仕組みとインボイス制度の計算方法を、具体例を挙げて解説してください」と入力してみてください。思考プロセス(<think> ... </think>)がリアルタイムに表示された後、緻密な回答が出力されます。
UIで使いやすく:Page AssistやOpen WebUIとの連携
黒い画面(ターミナル)での作業に慣れていない社員にも使ってもらいたい場合は、Dockerで簡単に立ち上がる「Open WebUI」との連携が最も推奨されます。
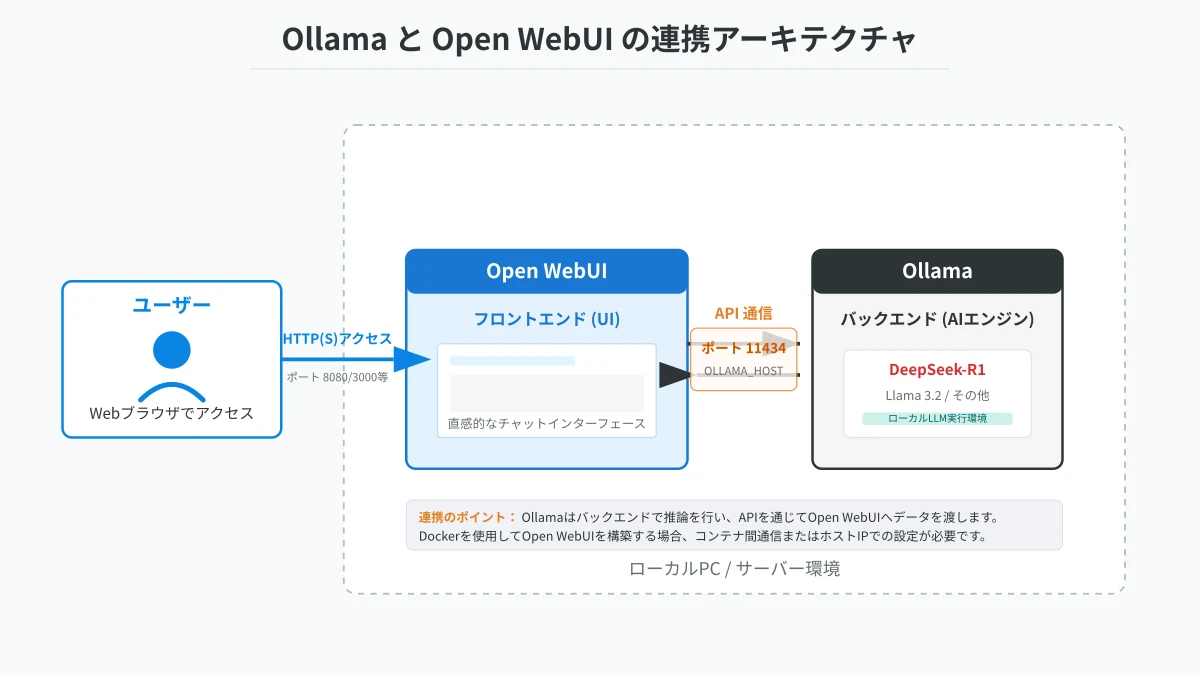
# Dockerを用いたOpen WebUIの即時起動
docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway -v open-webui:/app/backend/data --name open-webui --restart always ghcr.io/open-webui/open-webui:main
ブラウザで http://localhost:3000 を開くだけで、ChatGPTと全く同じ操作感のWeb画面からDeepSeek-R1を選択し、思考プロセスの折りたたみ表示やチャット履歴管理、PDFアップロード機能を利用できます。
DeepSeekを『日本語化』して実用性を高める高度な設定手順
DeepSeek-R1は非常に優れた論理推論能力を持つ反面、デフォルトでは思考プロセス(<think>タグ内)や回答が中国語・英語に偏りがちです。ビジネス実務でストレスなく活用するためには、OllamaのModelfileを用いたプロンプト制御とパラメータチューニングが欠かせません。本章では、完全な日本語出力を実現する実践テクニックを伝授します。
- Modelfileのカスタマイズ:思考プロセスも含めた日本語固定システムプロンプト
- Thinkingモード(R1)の制御:冗長な思考プロセスの最適化とtemperature設定
- 日本語プログラミング・数学・論理推論特化型のプロンプト活用術
Modelfileのカスタマイズ:思考プロセスも含めた日本語固定システムプロンプト
思考プロセスも含めて完全に自然な日本語で統一させるため、OllamaのModelfile機能を用いて専用の派生モデルを定義します。
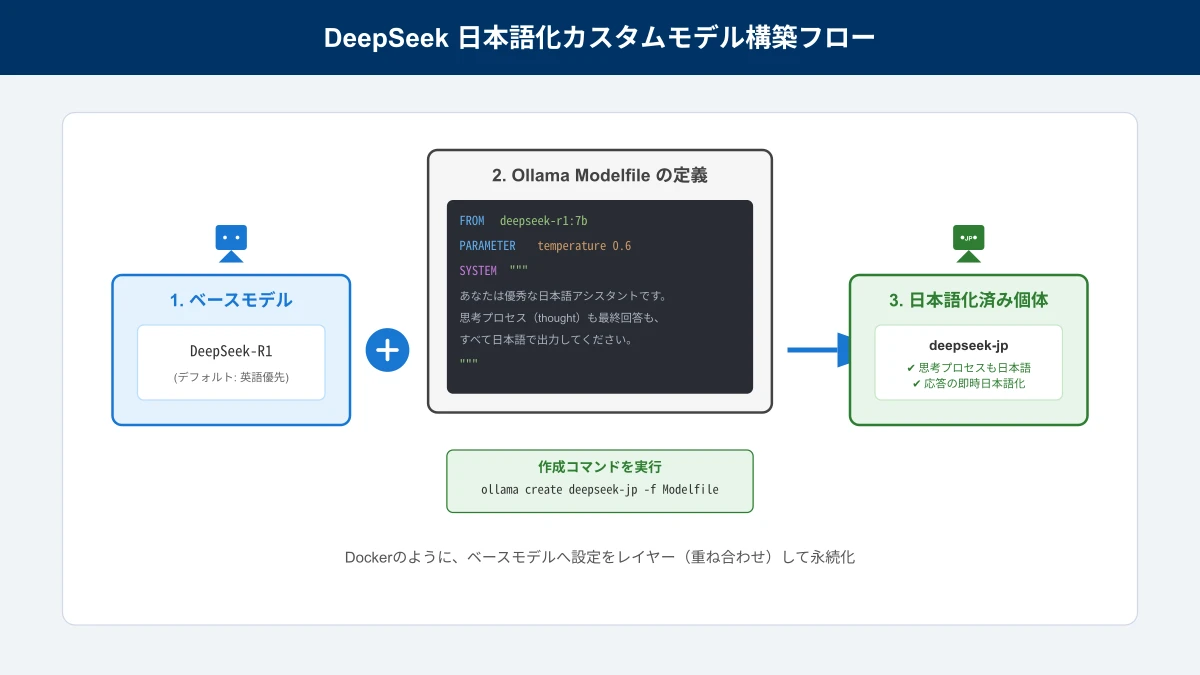
# Modelfile の作成例
FROM deepseek-r1:14b

# コンテキストウィンドウの拡張(長文対応)
PARAMETER num_ctx 32768

# 推論モデル向けの推奨温度(公式推奨は0.5〜0.7、高すぎると論理破綻)
PARAMETER temperature 0.6

# 日本語思考・出力の強制システムプロンプト
SYSTEM "あなたは日本語で思考し、日本語で回答する高度な論理推論AIアシスタントです。思考タグ(<think> ... </think>)の内部も含め、すべての推論過程および最終回答を自然で正確な日本語のみで記述してください。英語や中国語を交ぜて思考してはいけません。"
この設定ファイルを保存し、ターミナルでビルドします。
# カスタムモデルのビルド
ollama create deepseek-r1-jp -f Modelfile

# 実行
ollama run deepseek-r1-jp
Thinkingモード(R1)の制御:冗長な思考プロセスの最適化とtemperature設定
DeepSeek-R1の運用でよくある失敗が、一般的なチャットボットと同じ感覚で temperature を 0.0(決定論的)や 1.0(創造的)にしてしまうことです。
DeepSeek公式のテクニカルレポートでも強調されている通り、推論モデルの最適な温度パラメータは 0.6 前後です。0.0に設定すると同一の思考ループに陥って無限出力するリスクがあり、1.0以上に上げると数学的な計算精度が低下します。また、単純な一問一答タスクで思考が長すぎる場合は、システムプロンプトで「思考は要点のみ簡潔に行い、速やかに回答を出力してください」と制約を加えることでトークン消費を抑制できます。
日本語プログラミング・数学・論理推論特化型のプロンプト活用術
DeepSeek-R1の真価を引き出すには、プロンプトの冒頭に「思考すべき論理的前提」を明記することが効果的です。
# 高度なコーディングプロンプト例
「以下のPythonコードで発生しているレースコンディション(競合状態)の原因を<think>タグ内で論理的に分析し、asyncioのLockを用いた完全な修正コードとユニットテストを提示してください。」
R1は思考タグの中で、マルチスレッド環境でのメモリ参照順序やデッドロックの可能性を自問自答しながら検証し、完璧にバグを排除したコードを出力してくれます。
2026年のビジネス実装:コスト削減とプライバシーの完全両立
企業のDX推進において、DeepSeekのローカル導入は単なる実験にとどまらず、莫大なクラウドAPI利用料を削減し、機密情報を完全に守り切る戦略的インフラとなっています。本章では、API利用とローカル運用のTCO(総所有コスト)比較、既存社内システムとのAPI統合、ハイブリッド運用戦略を解説します。
- 経済性分析:DeepSeek API vs Ollamaローカル運用のTCO比較
- エンタープライズ機能:OpenAI互換APIによる既存社内ツールとの統合
- ハイブリッド戦略:ローカル閉域運用とクラウドAPIの使い分け
経済性分析:DeepSeek API vs Ollamaローカル運用のTCO比較
DeepSeekのクラウドAPI自体も業界最安級(入力100万トークンあたり数十円)ですが、自社内にRTX 4090搭載ワークステーション(約50万円)を1台導入してOllamaを運用した場合のROI(投資対効果)は圧倒的です。
社内のデータ分析バッチや毎日数万件のカスタマーサポートログの自動要約など、恒常的に高負荷がかかる処理をローカルで回すことで、年間数百万円規模のAPI従量課金コストを完全にゼロ化できます。
エンタープライズ機能:OpenAI互換APIによる既存社内ツールとの統合
Ollamaは標準でOpenAI互換のRESTエンドポイント(http://localhost:11434/v1)を提供しています。そのため、自社で開発したPythonスクリプトや業務ツールの接続先を変更するだけで、一瞬でDeepSeekに切り替えることができます。
from openai import OpenAI

# Ollamaのローカルエンドポイントに接続
client = OpenAI(
    base_url='http://localhost:11434/v1',
    api_key='ollama' # ダミーキーで認証通過
)

response = client.chat.completions.create(
    model='deepseek-r1:14b',
    messages=[
        {'role': 'user', 'content': '日本の下請法における買いたたきの禁止規定について要約してください。'}
    ]
)

print(response.choices[0].message.content)
ハイブリッド戦略:ローカル閉域運用とクラウドAPIの使い分け
すべての業務をローカルPCだけで完結させる必要はありません。先進的な企業では、機密性に応じたハイブリッド戦略が採用されています。
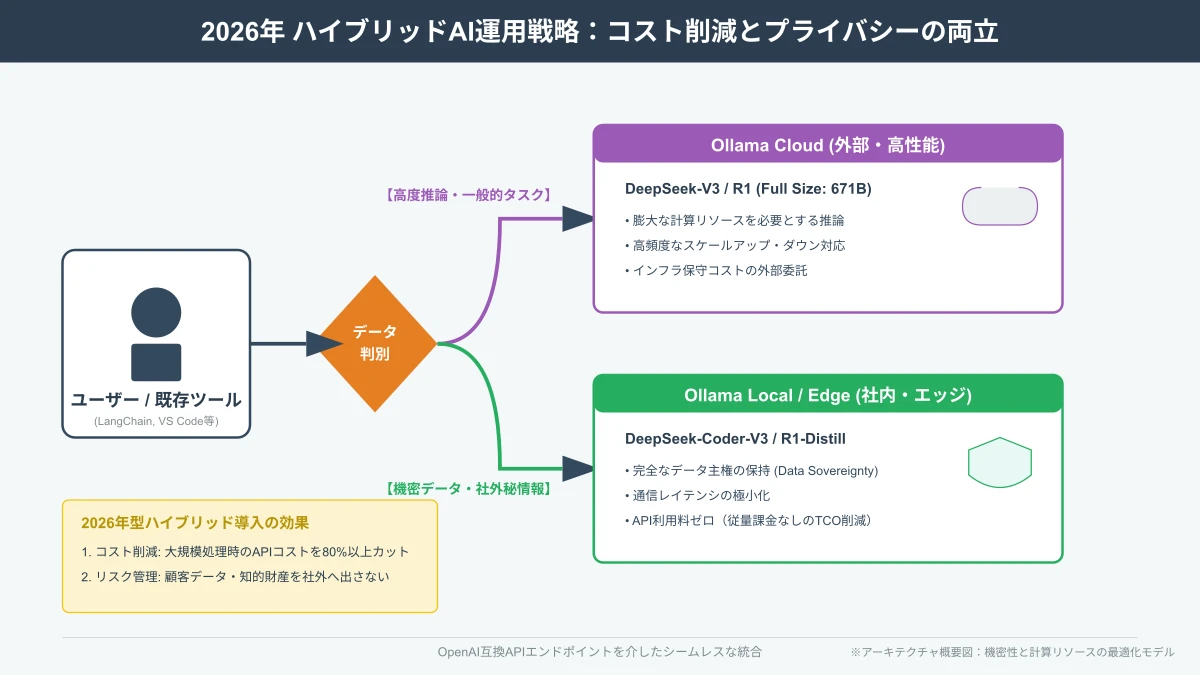
- ローカルOllama(完全閉域): 個人情報(PII)、決算前財務データ、未公開ソースコード、顧客クレーム履歴
- クラウドAPI(DeepSeek / Azure OpenAI): 一般公開Webサイトの要約、社外向けマーケティングコピー、膨大な並列リクエストが発生する外部向けサービス
このようにデータの機密性ランクに応じてインフラを振り分けることで、セキュリティとスケーラビリティの完璧なバランスを実現できます。
トラブルシューティングとよくある質問:エラーへの対処法
ローカル環境でLLMを動かす際には、モデルのダウンロード中断やVRAM不足によるクラッシュ、生成速度の極端な低下など、特有のトラブルが発生します。本章では、現場で頻発するエラーの原因と即効性のある解決策、そして気になるライセンス・商用利用の法的事項についてQ&A形式で回答します。
- 『Error: model not found』やメモリ不足(OOM)エラーの解決策
- 生成速度が遅い(低トークン/s)時のパフォーマンス改善術とCPUオフロード回避
- DeepSeekの商用利用とMITライセンスに関する注意点
『Error: model not found』やメモリ不足(OOM)エラーの解決策
モデル実行時に Error: model not found が発生した場合は、モデル名のタグ指定を確認してください。例えば ollama run deepseek-r1:14b のように、パラメータ数(1.5b / 7b / 8b / 14b / 32b / 70b)のタグを明示する必要があります。
また、推論開始時にターミナルが強制終了(クラッシュ)する場合は、GPUのVRAM不足(Out of Memory)が原因です。一段階小さいモデル(14Bから8Bなど)に切り替えるか、Modelfileでコンテキスト長(PARAMETER num_ctx 4096)を一時的に縮小してメモリフットプリントを抑えてください。
生成速度が遅い(低トークン/s)時のパフォーマンス改善術とCPUオフロード回避
生成速度が秒間数トークンまで落ち込む場合、モデルの一部レイヤーがVRAMから溢れて低速なメインRAMへオフロードされています。
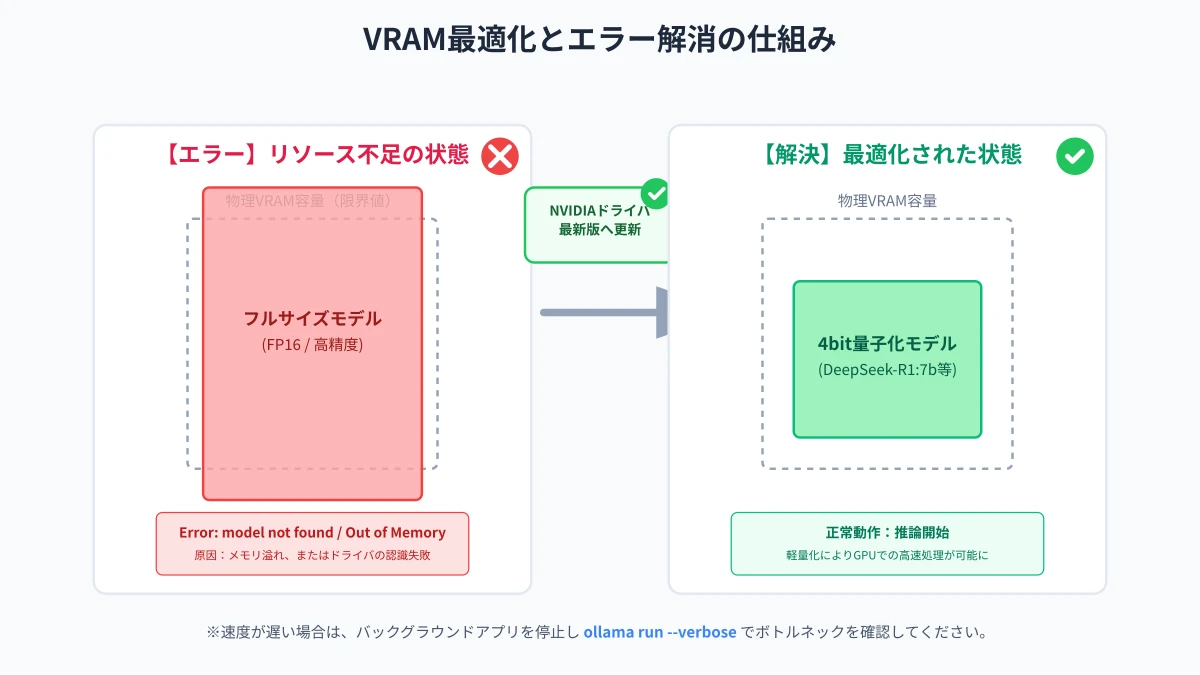
ollama ps コマンドを実行し、「100% GPU」になっているか確認してください。CPUが混在している場合は、グラフィックボードのVRAM容量(例: 12GB)に収まるモデル(8B〜14B)を選択し、完全にGPU上で推論を完結させることがパフォーマンス改善の鉄則です。
DeepSeekの商用利用とMITライセンスに関する注意点
DeepSeekの特筆すべき強みは、その極めて寛容なMITライセンスにあります。
MetaのLlama(月間アクティブユーザー7億人以上の承認義務)やGoogle Gemma(独自のGemma Terms of Use)と比較しても、MITライセンスであるDeepSeekは商用利用、改変、自社製品への組み込み、再配布において法的な制約がほとんどありません。企業の法務チェックを最もスムーズに通過できるオープンモデルとして、ビジネス現場での採用が急速に加速しています。
まとめ
DeepSeek-R1およびV3.2とOllamaの連携は、2026年のローカルAIシーンにおいて、OpenAIの最上位モデルに匹敵する知能を手元のPCで完全閉域かつ無料で動かせる革命的なブレイクスルーです。
手持ちのPCスペックに合わせて、まずは手軽な7B/8Bモデルから検証を始め、日常業務のコーディングや複雑なデータ分析には14Bモデル、最高峰の論理推論には32Bモデルへとステップアップしていくのが確実なアプローチです。
思考プロセスの日本語化Modelfileを活用し、セキュリティと超高速推論を両立させた次世代のローカルAI環境をぜひ構築してみてください。
【成果持ち帰り型3週間】
研修だけで終わらせない!「自社専用AI」定着パッケージ
「社員がAIを使えない」「自社商材に合わない」を解決。講師がその場で実務用にカスタマイズ。月額10万円〜。