(最終更新日: 2026年09月09日)
「Ollamaを使ってStable DiffusionやMidjourneyのような画像生成はできるの?」「Ollamaで動くLlama 3.2 VisionやQwen 2.5-VLは何ができて、どう活用すればいいの?」「ローカル環境だけで、画像認識から高画質な画像生成まで一貫して自動化する最強のAI環境を作りたい」と疑問をお持ちではありませんか?
2026年現在、オープンソースAIの世界はテキストだけでなく「視覚情報(マルチモーダル)」を自在に扱う時代へと突入しました。ローカルLLM実行ツールのデファクトスタンダードである『Ollama』においても、Meta社の『Llama 3.2 Vision』やAlibabaの『Qwen 2.5-VL』をはじめとする高精度なVision Language Model(VLM)がワンコマンドで手軽に稼働するようになっています。
しかし、ネット上の情報には誤解も多く、「Ollama自体で画像を描画・出力できる」と勘違いして導入に戸惑うユーザーが少なくありません。結論から言えば、Ollamaは画像を解析・理解する「認識(Vision)」のツールであり、ピクセルを生成する「描画(Diffusion)」のツールではありません。ただし、Ollamaを「プロンプト生成や画像分析のブレイン」として位置付け、ComfyUIやFLUX.1、Stable Diffusionといったローカル画像生成エンジンと連携させることで、完全オフラインかつセキュアな最高峰のローカルAI制作スタジオを構築できます。
本記事では、2026年最新のOllamaにおける視覚AIの全貌を徹底解説します。Ollamaが画像生成を直接行わない技術的理由から、Llama 3.2 VisionやQwen 2.5-VLを用いた実戦的な画像解析・OCRコマンド手順、ComfyUIカスタムノードを用いた画像生成自動化パイプラインの構築法、そしてVRAM選定や企業向けセキュア運用まで余すところなくお届けします。この記事を読めば、Ollamaの真の強みを引き出し、最先端のローカルビジュアルAI環境を自由自在に操れるようになります。
Ollamaの技術的境界線:なぜ「画像生成」が直接サポートされていないのか
「OllamaでMidjourneyやStable Diffusionのように画像を生成できるのか?」という疑問に対して、技術的な仕組みから明快な結論をお伝えします。言語・視覚認識(VLM)と画像生成(Diffusion)のアーキテクチャの違いと、Ollamaの公式方針を整理します。
- 自己回帰型Transformer(LLM/VLM)と潜在拡散モデル(Diffusion)の構造的相違
- 2026年現在のOllama公式方針とコミュニティの最新動向
- GGUF形式とマルチモーダル推論がもたらすローカル運用の恩恵
自己回帰型Transformer(LLM/VLM)と潜在拡散モデル(Diffusion)の構造的相違
Ollamaで直接画像生成ができない最大の理由は、「LLM/VLM」と「画像生成AI」とで採用されているニューラルネットワークのアーキテクチャが根本的に異なるためです。
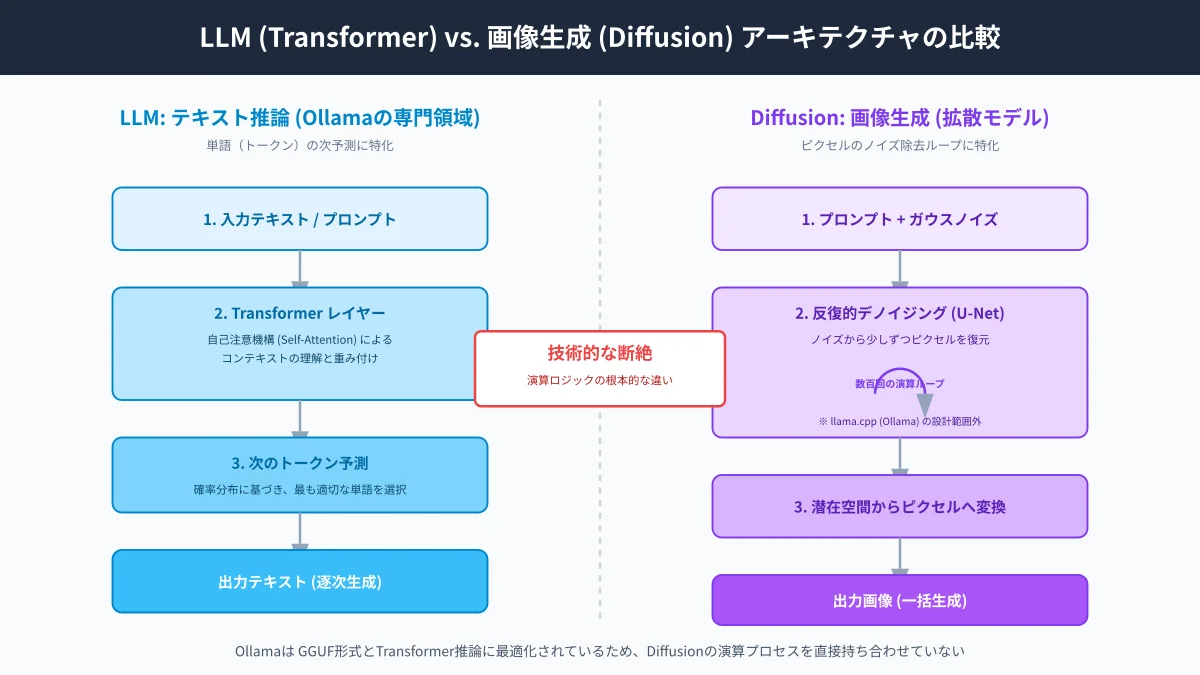
Ollamaが実行基盤としているのは、次に来るテキストトークンを確率的に予測する「自己回帰型Transformer(Autoregressive Transformer)」です。マルチモーダル対応のVisionモデル(Llama 3.2 Visionなど)であっても、入力された画像ピクセルを視覚エンコーダー(Vision Transformer: ViT)でトークン列に変換し、テキストとして理解・回答を出力する仕組みになっています。つまり、出力はあくまで「テキスト情報」です。
一方、Stable DiffusionやFLUX.1などの画像生成AIは「潜在拡散モデル(Latent Diffusion Models: LDM)」やフローベースモデルを採用しています。これらはノイズで満たされた潜在空間から、テキストの指示(CLIP / T5埋め込み)に従って段階的にノイズを除去(Denoising)しながらピクセル画像を逆生成する数学的プロセスを踏みます。計算グラフやテンソル演算の性質が全く異なるため、Ollama単体では画像生成アルゴリズムを実行できないのです。
2026年現在のOllama公式方針とコミュニティの最新動向
Ollamaの開発チームは、「ローカル環境で最高のLLM/VLM推論体験を提供する」ことに開発リソースを集中させる明確な方針を維持しています。
画像生成機能をOllama本体に直接組み込んで肥大化させるのではなく、軽量で高速なREST APIを提供し、外部の優れた画像生成エコシステム(ComfyUI、Automatic1111、Forgeなど)と連携させるマイクロサービス的アーキテクチャを推奨しています。2026年現在、Ollamaは「ビジュアル推論とプロンプトエンジニアリングのブレイン」として確固たる地位を築いています。
GGUF形式とマルチモーダル推論がもたらすローカル運用の恩恵
Ollamaの背後で動いているC++製推論エンジン『llama.cpp』は、単一ファイルで完結する『GGUF形式』を採用しています。GGUFは言語モデルの重みだけでなく、視覚プロジェクター(mmproj)の重みも統合して管理できる規格です。
さらに、4bitや8bitの高度な量子化(Q4_K_Mなど)を適用することで、通常であれば数十GBのVRAMを必要とする巨大なVisionモデルを、一般的なコンシューマーPCやMacの限られたメモリ内で驚くほど軽快に動作させることが可能です。
マルチモーダル革命:Ollamaで動く主要Visionモデルの性能比較と選び方
画像生成は行わないものの、Ollamaの画像認識・解析能力(Vision機能)は2026年現在、商用APIに匹敵する驚異的なレベルに達しています。用途やハードウェアスペックに応じた主要Visionモデルの特徴と選び方を解説します。
- Llama 3.2 Vision (11B / 90B):高精度OCRと多段階の視覚的論理推論
- Qwen 2.5-VL / Qwen 3-VL:日本語文書・チャート・UIコード解析の最高峰
- 軽量モデル(Moondream 2 / LLaVA-Phi):省リソース・エッジPCでの高速動作
Llama 3.2 Vision (11B / 90B):高精度OCRと多段階の視覚的論理推論
Meta社がリリースした『Llama 3.2 Vision』は、オープンソースVLMの標準ベンチマークとして世界中で利用されています。11Bと90Bの2つのサイズが用意されており、用途とVRAM容量に応じて選択できます。
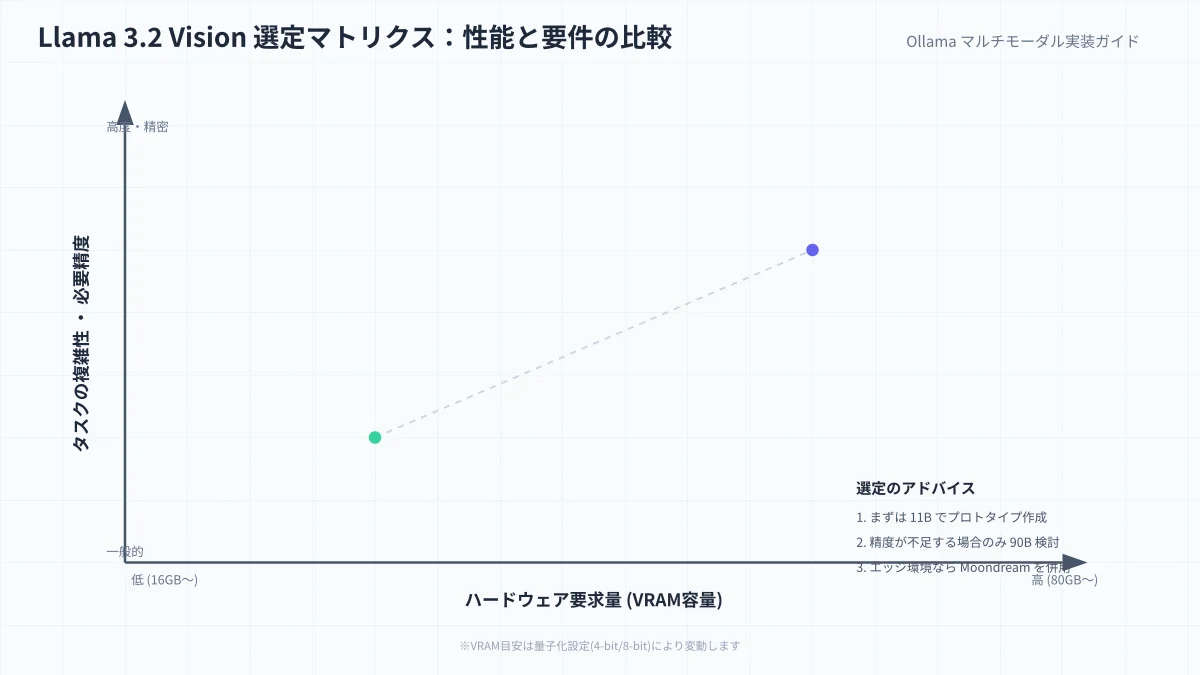
特に Llama 3.2 Vision (11B) は、約8GB〜10GB前後のVRAMで軽快に動作し、英語および多言語の印刷物OCR、グラフの読み取り、画像内のオブジェクト検出において極めて高い精度を誇ります。企業のドキュメント処理や社内ワークフロー自動化のベースとして最適です。
Qwen 2.5-VL / Qwen 3-VL:日本語文書・チャート・UIコード解析の最高峰
日本国内のビジネス利用において現在「最強の視覚モデル」と評価されているのが、Alibabaが開発する『Qwen 2.5-VL』および『Qwen 3-VL』シリーズ(7B / 32B / 72B)です。
漢字や日本語フォントの認識力が圧倒的で、手書きの領収書や複雑な請求書テーブル、複雑な日本語フローチャートの構造化抽出で他の追随を許しません。さらに、Webサイトのデザインカンプや手書きのワイヤーフレーム画像を渡すだけで、Tailwind CSSやReactコンポーネントコードを高精度に自動出力する能力も備えています。
軽量モデル(Moondream 2 / LLaVA-Phi):省リソース・エッジPCでの高速動作
「専用GPUを搭載していないノートPCでサクサク画像を解析したい」という場合には、超軽量モデルの導入が推奨されます。
| モデル名 | パラメータ規模 | 必要VRAM目安 | おすすめの用途 |
|---|---|---|---|
| Moondream 2 | 1.86B | 約2GB〜3GB | 画像の簡易キャプション作成、高速な物体識別、IoTエッジ端末 |
| Llama 3.2 Vision (11B) | 11B | 約8GB〜10GB | 汎用ドキュメント分析、複雑なグラフ読み取り、視覚的推論 |
| Qwen 2.5-VL (7B / 32B) | 7B / 32B | 6GB / 20GB | 高精度日本語OCR、UIコード生成、精密な表データ抽出 |
実践!Ollamaによる画像解析・Visionモデルの操作コマンド手順
コマンドライン(CLI)やAPI経由でVisionモデルを実際に動かすための実践手順です。ローカル画像ファイルのパス指定から、Pythonを用いた自動化スクリプトまで具体例を交えて解説します。
- CLIコマンド(ollama run)によるローカル画像ファイル読み込みと対話
- Python APIおよびcURLを用いたBase64画像データの送信自動化
- 画像から要約・データ抽出・プロンプト変換を行う実務プロンプト術
CLIコマンド(ollama run)によるローカル画像ファイル読み込みと対話
OllamaでVisionモデルを動かす最も簡単な方法は、ターミナルから ollama run コマンドを実行することです。
# 1. Visionモデルのダウンロード
ollama pull llama3.2-vision

# 2. 対話セッションの起動
ollama run llama3.2-vision

# 3. プロンプト入力時に画像ファイルパスを指定する
>>> この画像に何が写っているか日本語で詳しく説明してください /path/to/my_photo.jpg
プロンプト文字列の中に画像ファイルのローカル絶対パス(または相対パス)を含めるだけで、Ollamaが自動的に画像を読み込んでエンコードし、数秒で高精度な解析結果を返してくれます。
Python APIおよびcURLを用いたBase64画像データの送信自動化
業務システムや自作アプリに画像解析を組み込む場合は、Ollama公式のPythonライブラリやREST APIを使用します。画像データをBase64エンコードして渡すのが標準的な手順です。
import base64
import ollama

def encode_image(image_path):
    with open(image_path, "rb") as image_file:
        return base64.b64encode(image_file.read()).decode('utf-8')

image_b64 = encode_image("receipt_sample.png")
response = ollama.chat(
    model="llama3.2-vision",
    messages=[{
        "role": "user",
        "content": "この領収書の日付、店名、合計金額をJSON形式で抽出してください。",
        "images": [image_b64]
    }]
)

print(response['message']['content'])
このわずか数行のスクリプトで、ローカルGPUを活用した完全オフラインの領収書OCR処理や外観検査システムが完成します。
画像から要約・データ抽出・プロンプト変換を行う実務プロンプト術
Visionモデルの出力精度を最大化するためには、タスクに応じた明確な指示構文(プロンプト)を与えることが重要です。
【実務で役立つVisionプロンプトテンプレート】
1. 表・チャートの構造化抽出:
   「画像内のグラフの軸名、期間、各データの数値を読み取り、Markdownテーブル形式で出力してください。」
2. UIデザインのコード化:
   「このワイヤーフレームのレイアウトを分析し、モダンなTailwind CSSを用いたHTMLコードを生成してください。」
3. 画像生成用プロンプトへの逆変換(Image-to-Prompt):
   「この写真の構図、被写体、ライティング、カメラ設定、色彩パレットを分析し、Stable DiffusionやFLUXで同等の画像を再現するための高品質な英語プロンプトを生成してください。」
ローカル画像生成環境の構築:Ollama × ComfyUI・FLUX連携パイプライン
「ローカルでAI画像生成を行いたい」場合の2026年デファクトスタンダードが、Ollama(思考・プロンプト生成エンジン)とComfyUI / FLUX.1(画像レンダリングエンジン)を組み合わせたハイブリッドパイプラインです。
- comfyui-ollamaノードを用いた画像生成自動化ワークフロー
- Open WebUIにおける画像生成モデル(Stable Diffusion / FLUX.1)統合
- Ollamaを「プロンプト強化の脳」として活用するプロンプトエンジニアリング
comfyui-ollamaノードを用いた画像生成自動化ワークフロー
ノードベースの画像生成ツールとして圧倒的な人気を誇る『ComfyUI』には、コミュニティから強力なOllama連携カスタムノード(comfyui-ollama)が提供されています。
ComfyUI Managerからこのノードをインストールすると、画像生成パイプラインの中に「Ollama LLM」や「Ollama Vision」ノードを自由に配置できるようになります。
- 画像入力ノード: 参考となるスケッチや実写写真を読み込む。
- Ollama Visionノード: 画像の内容を解析し、「映画のようなサイバーパンク風にアレンジした英語プロンプト」を自動生成する。
- CLIPテキストエンコーダ: Ollamaが生成したプロンプトを潜在ベクトルに変換する。
- KSampler & FLUX/SDXLモデル: 高精細な完成画像をレンダリングする。
このワークフローを組むことで、「画像を放り込むだけで、AIが自動で意図を汲み取って別バリエーションの画像を生成する」という全自動クリエイティブパイプラインが完成します。
Open WebUIにおける画像生成モデル(Stable Diffusion / FLUX.1)統合
「ノードを組むのは難しそう。チャット画面から手軽に画像を生成したい」という方には、『Open WebUI』の画像生成連携機能が最適です。
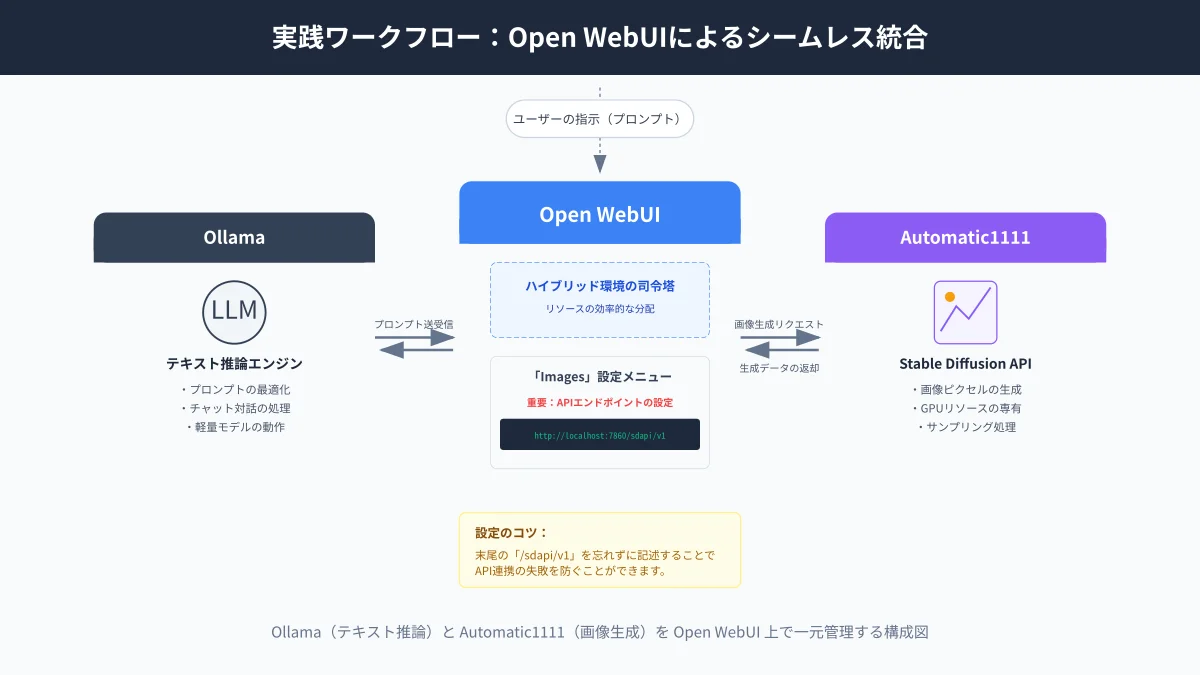
Open WebUIの管理設定画面(Admin Settings ➔ Images)で、ローカルで起動しているAutomatic1111やComfyUIのエンドポイントURL(例: http://localhost:7860/)を指定するだけで設定が完了します。チャット欄で「富士山を背景にした桜の写真を生成して」と入力すると、Ollamaがプロンプトを英語に展開して画像生成APIを叩き、チャット画面内に直接生成された画像を表示してくれます。
Ollamaを「プロンプト強化の脳」として活用するプロンプトエンジニアリング
FLUX.1やStable Diffusion XLで実写級のクオリティを出すためには、カメラのレンズ焦点距離(85mm f/1.4)、照明(Rembrandt lighting)、質感(subsurface scattering)といった高度なプロンプト構文が不可欠です。
Ollama内に「プロンプト拡張専用のModelfile」を作成しておくことで、ユーザーが適当な日本語を入力するだけで、プロカメラマン監修レベルの長文英語プロンプトへ自動変換させることができます。
# プロンプト拡張専用のModelfile例
FROM qwen3:8b
PARAMETER temperature 0.7
SYSTEM "あなたは画像生成AI(FLUX.1 / SDXL)のためのプロフェッショナルなプロンプトエンジニアです。ユーザーから入力された日本語のアイデアを受け取り、構図、被写体の詳細、ライティング、カメラパラメータ(85mm f/1.4等)を含む高品質な英語プロンプトを出力してください。前置きや解説は一切含めず、プロンプトテキストのみを返答してください。"
快適な動作を実現するハードウェア選定と企業向けセキュア運用
Visionモデルによる画像解析と、ComfyUI等での画像生成を同じローカルマシンで快適に共存させるためのGPUスペック選定と、完全オフラインでの安全な運用体制を解説します。
- LLMと画像生成の同時稼働に必要なVRAM容量マトリクス(16GB〜24GB / Mac統一メモリ)
- 機密図面や個人情報を守る完全オフライン・エアギャップ環境の構築
- オープンモデルの商用ライセンス遵守とセキュアなエンドポイント運用
LLMと画像生成の同時稼働に必要なVRAM容量マトリクス(16GB〜24GB / Mac統一メモリ)
言語モデル(Ollama)と画像生成モデル(ComfyUI / FLUX.1)を同時に動かす場合、最もシビアになるのがGPUのビデオメモリ(VRAM)容量です。
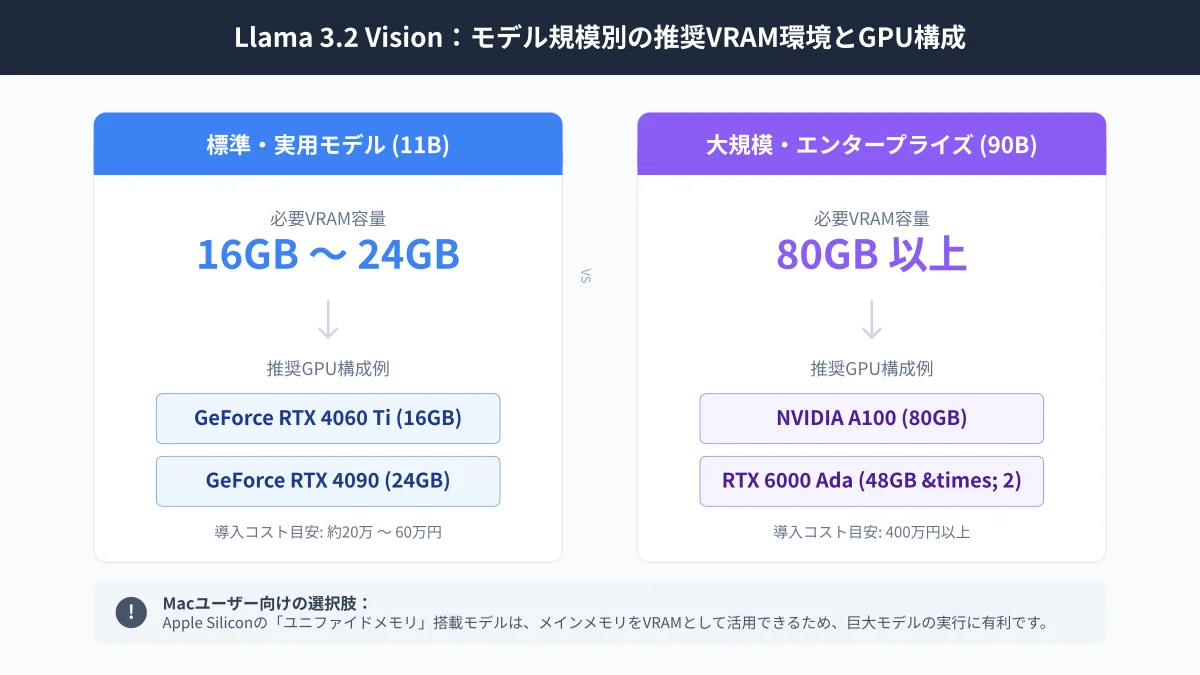
ハードウェア環境別の運用目安は以下の通りです。
| VRAM容量 | 代表的ハードウェア | 実現可能な同時稼働構成 |
|---|---|---|
| 8GB 〜 12GB | RTX 4060 / 3060 | Moondream (2GB) + SD1.5/SDXL(軽量版)。切り替え実行が推奨 |
| 16GB | RTX 4070 Ti / 4080 | Llama 3.2 Vision 11B (Q4) + SDXL / FLUX Schnell (8bit量子化) |
| 24GB 〜 32GB | RTX 3090 / 4090 / 5090 | Qwen 2.5-VL (32B) + FLUX.1 Dev (フルモデル) の爆速同時運用 |
| 64GB 〜 128GB | Apple Mac Studio (M3/M4 Max) | 超大規模Visionモデル(90Bクラス)とFLUXの超余裕運用 |
機密図面や個人情報を守る完全オフライン・エアギャップ環境の構築
研究開発部門や製造業の設計部門において、未公開の新製品スケッチや機密図面を外部のクラウドAIにアップロードすることはコンプライアンス違反となります。
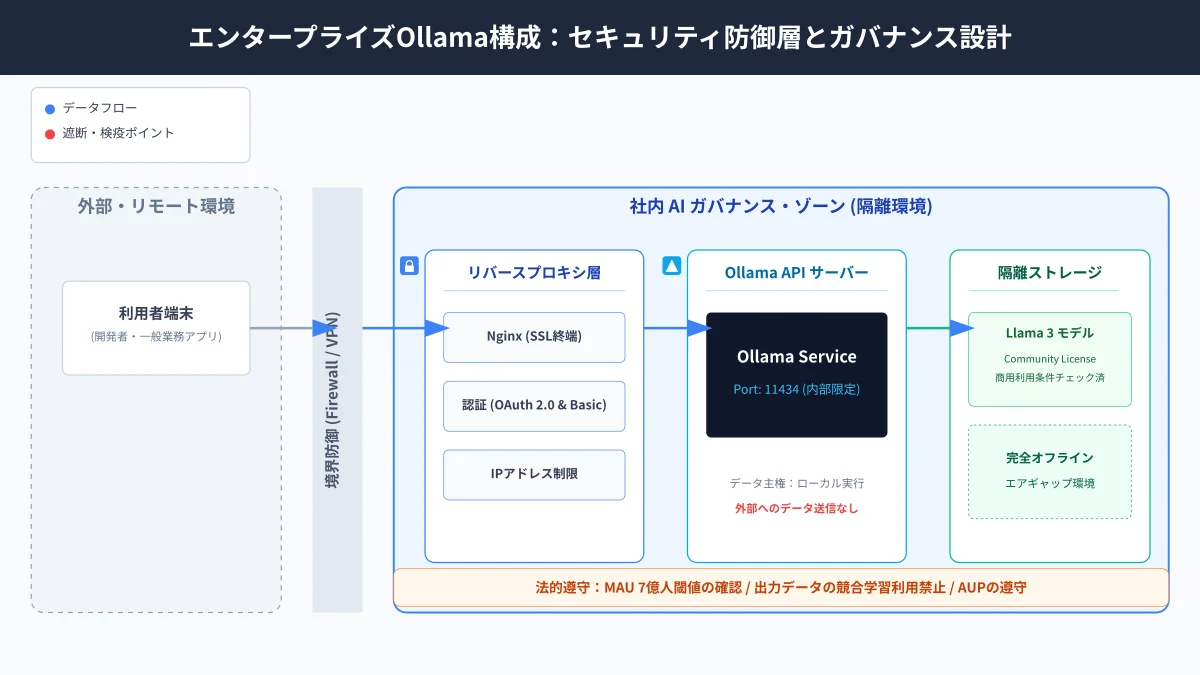
OllamaとComfyUIを同一の社内オンプレミスサーバーに配置し、インターネットへのアウトバウンド通信を物理的に遮断した「エアギャップ環境」を構築することで、知的財産や機密データの漏洩リスクをゼロに抑えた安全な画像分析・生成基盤が実現します。
オープンモデルの商用ライセンス遵守とセキュアなエンドポイント運用
ローカルモデルをビジネスで使用する際は、各モデルのライセンス条件を必ず確認してください。
- Meta Llama 3.2: 月間アクティブユーザー数が7億人未満の組織であれば商用利用が無償で許諾される『Llama 3.2 Community License』が適用されます。
- Qwen 2.5-VL / Qwen 3-VL: Apache 2.0などの極めて寛容なオープンライセンスで提供されており、商用システムへの組み込みが法的に安全です。
- FLUX.1: 商用利用には『FLUX.1 Schnell(Apache 2.0)』または商用ライセンス版を選択する必要があります。
また、社内ネットワークでOllamaのAPIを共有する際は、Nginxリバースプロキシをフロントに立ててSSL暗号化とAPIキー認証を導入し、不正アクセスやリソース占有を防止しましょう。
まとめ
Ollamaは単体で画像を生成するツールではありませんが、最高峰のVisionモデル(Llama 3.2 VisionやQwen 2.5-VL)による画像認識ハブとして、そしてComfyUIやFLUX.1と連携したローカル画像生成スタジオの『思考エンジン』として無類の強みを発揮します。
役割を正しく理解し、安全でクリエイティブな自社ローカルAI環境を構築していきましょう。
まずは手持ちのPCにOllamaを導入し、Visionモデルでの画像解析からローカルAIの新しい可能性を体感してみてください。
【成果持ち帰り型3週間】
研修だけで終わらせない!「自社専用AI」定着パッケージ
「社員がAIを使えない」「自社商材に合わない」を解決。講師がその場で実務用にカスタマイズ。月額10万円〜。