(最終更新日: 2026年09月07日)
「ローカルLLMを動かせるOllamaを導入してみたけれど、モデルが多すぎてどれを選べばいいのかわからない」「日本語が一番流暢で、仕事のレポート作成や要約に使える実用的なモデルはどれ?」「手持ちのPCや会社のグラフィックボード(VRAM容量)で本当に快適に動くの?」と悩んでいませんか?
2026年現在、ローカルLLMの進化スピードは凄まじく、オープンソースAIの性能は商用のクラウドフロンティアモデル(GPT-4oやClaude 3.5 Sonnetなど)に匹敵する領域へ到達しています。軽量かつ高速なローカル実行ランタイムとして世界標準となった『Ollama』では、コマンド1つで世界中の最高峰モデルを即座にダウンロード・実行できるようになりました。
特に最近では、日本語を含めた多言語・推論性能で圧倒的な評価を受けるAlibabaの『Qwen 3 / Qwen 3.8』シリーズ、思考プロセス(Chain-of-Thought)を展開して論理的ミスを劇的に減らす『DeepSeek-R1』、Meta社が放つ超長文コンテキストとマルチモーダル対応のフラッグシップ『Llama 4』、そして国内研究機関による日本語特化モデル(ELYZAやSwallow)など、目的に応じて選ぶべき選択肢が明確に分かれています。
しかし、モデルのパラメータ規模(7B、14B、32B、70B以上)や量子化タイプ(Q4_K_Mなど)、そしてPCのGPUビデオメモリ(VRAM)容量の適合関係を正しく把握していないと、「ダウンロードしたのにメモリ不足で起動しない」「推論速度が遅すぎて使い物にならない」といった失敗に直面します。
本記事では、2026年最新のOllama対応おすすめモデルを徹底解説します。日本語能力・論理推論・コーディングなどの用途別比較から、手持ちのPCスペック(VRAM 8GB〜24GB、Apple Silicon Mac)に応じた最適なハードウェア適合マトリクス、Modelfileを活用したプロンプトのコード化、そしてOpen WebUIを用いたセキュアな社内運用基盤の構築まで余すところなくお届けします。この記事を読めば、あなたの環境で最高のパフォーマンスを発揮するローカルAIモデルが必ず見つかります。
2026年ローカルLLMの最新トレンド:なぜ企業でOllama導入が加速するのか
生成AIのビジネス活用が当たり前となった2026年、機密情報の漏洩リスク回避とコスト最適化を目的に、ローカル環境で自立稼働するOllamaの企業導入が急増しています。クラウドSaaSからオンプレミス・ローカルAIへ移行する背景と、Ollamaが選ばれる理由を整理します。
クラウドAPI依存からの脱却とプライバシーファーストな運用体制
企業のDX推進において最大の障壁となってきたのが「データセキュリティとプライバシー保護」です。顧客情報、未公開の財務データ、ソースコード、特許関連の技術文書などを外部のクラウドAPIへ送信することに対しては、依然として多くの企業で厳格なコンプライアンス規制が敷かれています。
ローカルLLMプラットフォームとしてのOllamaは、ネットワークから完全に隔離されたエアギャップ環境(完全オフライン)であっても全機能が稼働します。推論処理はすべて社内のGPUサーバーやローカルPC上で完結するため、情報漏洩や学習データへの無断転用リスクを物理的にゼロにできる点が、金融・医療・製造業をはじめとするエンタープライズ企業で熱烈に支持されている最大の理由です。
Modelfileによるプロンプトと環境のコード化(IaC)
Ollamaが他のローカルLLM実行ツール(llama.cpp直実行やテキスト生成WebUIなど)と決定的に異なるのは、「Dockerに酷似した環境管理モデル」を採用している点です。Ollamaでは『Modelfile』と呼ばれるシンプルなテキストファイルにより、使用するベースモデル、システムプロンプト、コンテキスト長、温度パラメータ、テンプレート形式を一元管理できます。
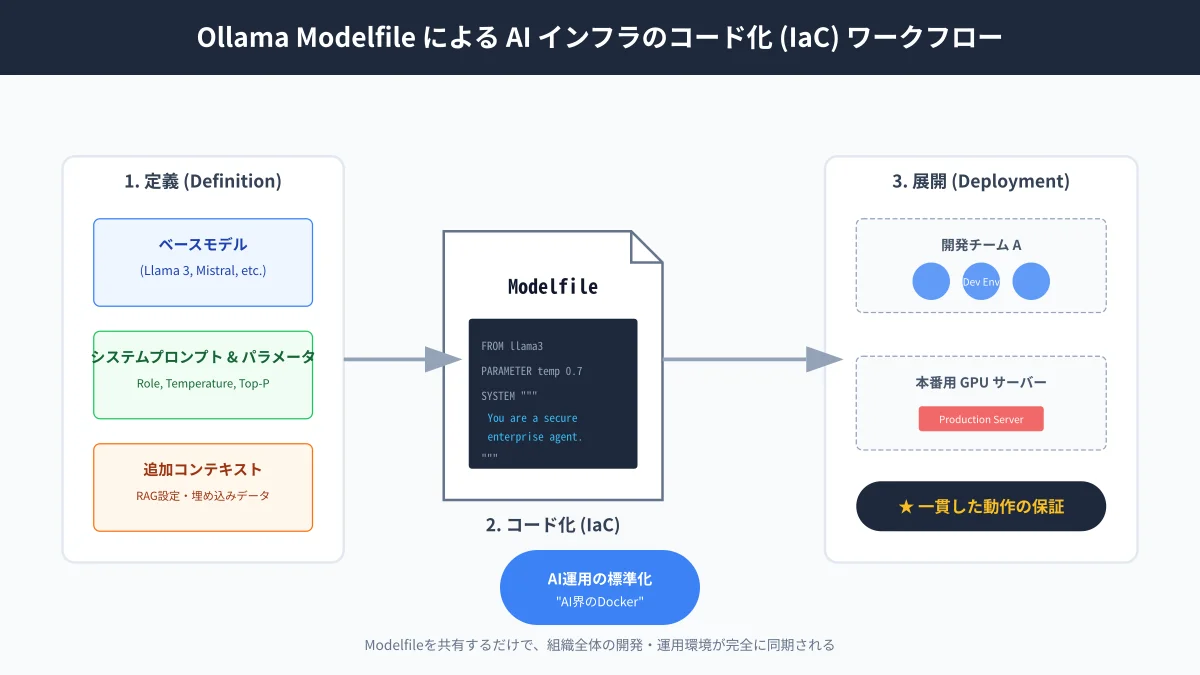
開発チームはModelfileをGitリポジトリでバージョン管理(IaC: Infrastructure as Code)し、`ollama create my-company-model -f Modelfile` コマンドを実行するだけで、全社で統一された高品質な業務特化AIを即座にビルド・配布できます。プロンプトエンジニアリングの成果が属人化せず、チーム全体に再現性高く行き渡る設計が極めて優秀です。
クラウド利用料(OpEx)とローカルGPU投資(CapEx)の費用対効果
毎月数千〜数万ドルのクラウドLLMトークン利用料(OpEx)が発生している開発現場において、ローカルLLMサーバーへの初期投資(CapEx)は極めて魅力的な投資対効果(ROI)を生み出します。
例えば、NVIDIA GeForce RTX 4090(24GB VRAM)を搭載したワークステーション(約50万円)を1台導入した場合、社内ドキュメントの要約、コード補完、大量ログの定期解析といった高頻度バッチ処理を24時間365日トークン課金なしで実行できます。月額10万円以上のクラウドAPI課金を行っていたチームであれば、わずか4〜5ヶ月でハードウェア投資を完全に回収できる計算になります。
次世代フラッグシップ「Meta Llama 4」の特徴と日本語対応の実力
オープンソースモデルの牽引役であるMeta社が発表した『Llama 4』シリーズは、従来のモデル概念を覆す長文コンテキスト処理と高度なマルチモーダル性能を備えています。各バリエーションの仕様と、日本企業における実務適応性を解説します。
- Llama 4 Scout (109B):超長文コンテキストが変える契約書・ドキュメント解析
- Llama 4 Maverick (400B):画像・テキストをシームレスに処理するマルチモーダル推論
- 日本語適応モデル(ELYZA-Llama-4 / Swallow)の導入メリット
Llama 4 Scout (109B):超長文コンテキストが変える契約書・ドキュメント解析
Meta Llama 4シリーズの中核モデルである『Llama 4 Scout』は、MoE(Mixture of Experts)構造を採用することで、総パラメータ数109Bでありながら推論時のアクティブパラメータを大幅に削減し、高速なレスポンスを実現しています。
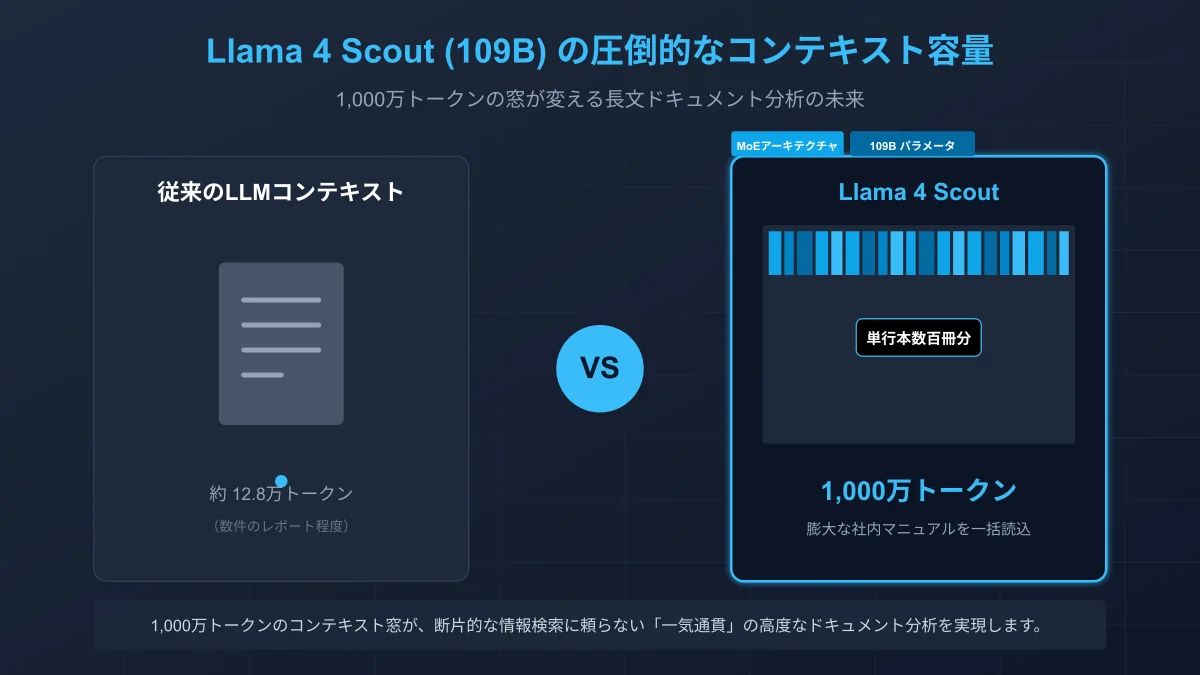
特筆すべきは、1,000万トークン規模に迫る超広大なコンテキストウィンドウのサポートです。従来のRAG(検索拡張生成)ではドキュメントを数百トークン単位で分割してベクトル検索する必要がありましたが、Scoutでは過去数年分の社内議事録や数百ページに及ぶ法務契約書を丸ごとプロンプトに投入し、全体を俯瞰した精密なクロスチェックや要約が可能になります。
Llama 4 Maverick (400B):画像・テキストをシームレスに処理するマルチモーダル推論
最上位モデルである『Llama 4 Maverick (400B)』は、オープンモデル最高峰の知能を誇り、テキストだけでなく画像・図面・フローチャートをネイティブに理解するマルチモーダル基盤モデルです。
技術仕様書の複雑な回路図やUIデザインカンプを直接読み込ませ、「この設計のセキュリティ脆弱性を指摘せよ」「このUIをTailwind CSSでコード化せよ」といった高度な指示に完璧に応答します。400Bクラスのフル稼働にはマルチGPUサーバーが必要となりますが、量子化版やホスティング連携を活用することで、エンタープライズの基幹業務を自動化する強力なブレインとして機能します。
日本語適応モデル(ELYZA-Llama-4 / Swallow)の導入メリット
Llama 4は多言語学習が強化されているものの、日本のビジネス慣習(敬語の使い分け、法務用語、業界特有の言い回し)に完全にフィットさせるためには、国内のトップ研究機関がファインチューニングした派生モデルの活用が極めて有効です。
東京大学・東工大発の『Swallow』プロジェクトや、ELYZA社による日本語語彙拡張モデルは、日本語トークナイザーの効率化によって出力速度が劇的に向上しているだけでなく、不自然な翻訳調の日本語を完全に排除した自然なアウトプットを提供します。OllamaのコミュニティライブラリでもこれらのGGUF形式が広く共有されており、`ollama run elyza-llama4` 等のコマンドで手軽に利用可能です。
日本語最強の「Qwen 3」と論理推論の王「DeepSeek-R1」の使い分け
2026年のオープンモデル界で双璧をなすのが、極めて自然な日本語表現を誇るAlibabaの『Qwen』シリーズと、驚異的な推論・数学能力で世界を震撼させた『DeepSeek-R1』です。両者の特性を比較し、業務別の最適解を導きます。
- Qwen 3 (32B):24GB VRAMで驚異的な日本語表現力と自然さを発揮
- DeepSeek-R1:思考プロセス(Chain-of-Thought)による論理的検証とコーディング
- DeepSeek-V3 / Gemma 3:高速処理とエージェント機能(Function Calling)の連携
Qwen 3 (32B):24GB VRAMで驚異的な日本語表現力と自然さを発揮
2026年現在、「ローカル環境で最も美しい日本語を出力する万能モデル」として開発者・ビジネスパーソンから圧倒的な支持を集めているのが、Alibaba Cloudが開発する『Qwen 3』シリーズ(Qwen 3 / Qwen 3.8)です。
漢字やアジア圏言語のトークナイザーが最適化されており、生成速度が非常に高速である点が大きな特徴です。特に Qwen 3 (32B) の4bit量子化版(Q4_K_M)は、約20GB前後のVRAMで動作するため、コンシューマー向け最上位GPU(RTX 3090 / 4090)やMacBook Proの単一環境で余裕を持ってフル稼働させることができます。
# Qwen 3 (32B) の取得と起動コマンド
ollama pull qwen3:32b
ollama run qwen3:32b
メール返信のドラフト作成、企画書やブログ記事の執筆、カスタマーサポートの問い合わせ対応など、「自然で丁寧な日本語表現が求められる全業務」において、Qwen 3は第一選択肢となる傑作モデルです。
DeepSeek-R1:思考プロセス(Chain-of-Thought)による論理的検証とコーディング
「思考するAI」として世界中に衝撃を与えた『DeepSeek-R1』は、強化学習によって回答を出力する前に内部で推論ステップ(思考の連鎖)を自律展開する次世代の推論特化型モデルです。
回答の冒頭に <think> ... </think> タグが出力され、AIがどのような前提を置き、どのような仮説検証を経て結論に至ったのかが透明化されます。このプロセスにより、従来のLLMで頻発していたハルシネーション(事実誤認)や論理矛盾が劇的に減少します。
| 項目 | Qwen 3 (32B) | DeepSeek-R1 (Distill 32B / 70B) |
|---|---|---|
| 得意分野 | 自然な日本語文章作成、要約、多言語翻訳 | 複雑なプログラミング、数学、アルゴリズム設計、論理パズル |
| 出力の特徴 | 即座に流暢で洗練された結論・本文を返す | <think>内で深く自己反省・検証してから精密回答を出力 |
| 生成速度 | 極めて高速(初速が早い) | 思考フェーズがあるため初速はやや遅いが精度が極めて高い |
| 推奨VRAM | 20GB〜24GB | 14B版: 10GB / 32B版: 20GB / 70B版: 42GB |
DeepSeek-V3 / Gemma 3:高速処理とエージェント機能(Function Calling)の連携
外部ツールやデータベースと連携した「AIエージェント」を自律稼働させたい場合には、Function Calling(関数呼び出し)と構造化出力(JSONモード)に特化したモデルが必須となります。
DeepSeek-V3やGoogleの『Gemma 3』は、指示追従性(Instruction Following)が極めて高く、社内データベースへのSQLクエリ生成や、Web検索APIの呼び出しを正確なJSON構文で返却します。n8nやLangChain、Difyなどの自動化ツールとOllamaを連携させる際の中核エンジンとして不可欠な存在です。
失敗しないハードウェア選定ガイド:VRAM容量とモデルサイズの相関マトリクス
ローカルLLMの快適さは、CPUではなくGPUのビデオメモリ(VRAM)容量で100%決まります。自社のPC環境や予算に合わせて、どのモデルがどの速度で動くのかを正確に見極めるための選定マトリクスを提示します。
- 「VRAM 24GBの壁」を突破する:GeForce RTX 3090/4090/5090 vs Apple Silicon
- 量子化(Quantization)の基礎知識:4bit(Q4_K_M)が推奨される理由
- エッジPC・ノートPCでの快適動作:NPU活用と軽量モデル(Phi-4-Mini / 7Bクラス)
「VRAM 24GBの壁」を突破する:GeForce RTX 3090/4090/5090 vs Apple Silicon
ローカルLLM運用における最大の分岐点が「VRAM 24GB」のラインです。モデルの重みデータがVRAM内に完全に収まれば、1秒あたり30〜80トークンという高速推論が維持されますが、1MBでも溢れてメインメモリ(CPU RAM)に退避されると、推論速度は1秒あたり数トークン以下へと暴落します。
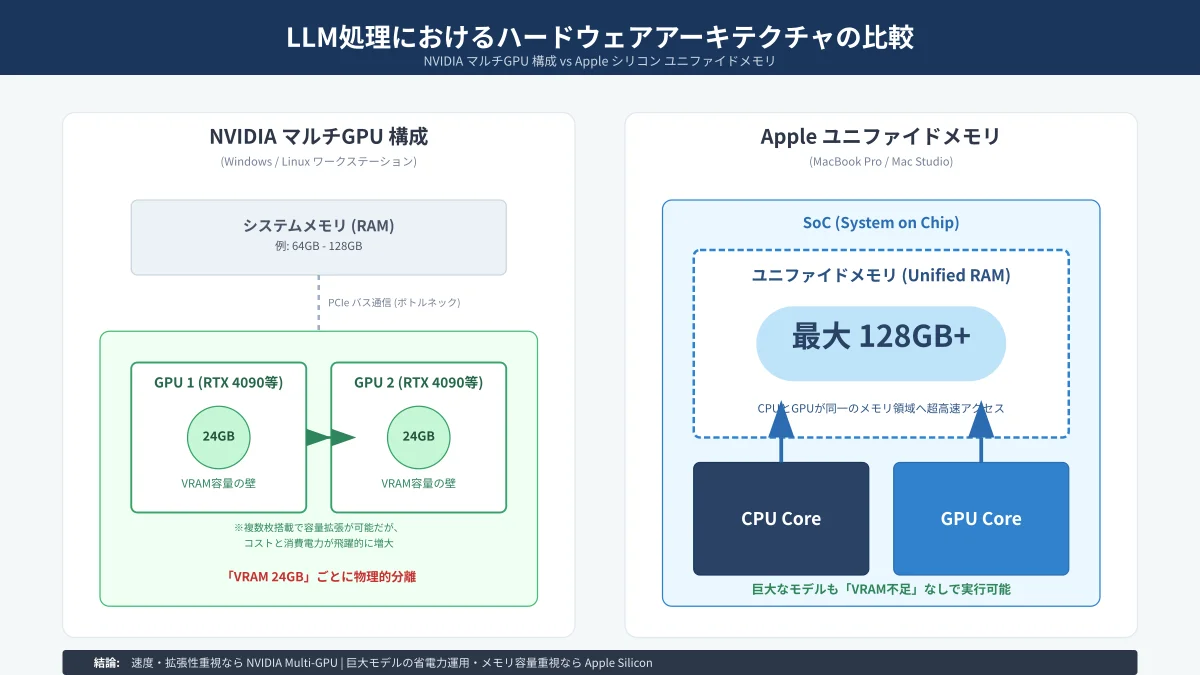
ハードウェア選定における2大巨頭の比較は以下の通りです。
| ハードウェア構成 | 利用可能メモリ | 実行可能モデル規模 | 特徴とおすすめユーザー |
|---|---|---|---|
| NVIDIA RTX 3090 / 4090 / 5090 | 24GB〜32GB GDDR6X | 32Bモデル(Q4_K_M)まで爆速稼働 | 圧倒的な推論速度(CUDA最適化)。リアルタイム対話や開発に最適 |
| Apple Mac Studio / Pro (M3/M4 Max) | 64GB〜128GB 統一メモリ | 70B〜109Bモデル(Llama 4 Scout等) | 省電力かつ大容量メモリ。巨大モデルを低コストにローカル動作させたい企業向け |
| 一般的なGPU搭載ノートPC (RTX 4060等) | 8GB〜16GB GDDR6 | 7B〜14Bモデル(Qwen 7B, Gemma 9B等) | 個人の日常業務アシスタント、コーディング補助に十分な実用性 |
量子化(Quantization)の基礎知識:4bit(Q4_K_M)が推奨される理由
モデルをダウンロードする際、タグの末尾に付く `q4_k_m` や `q8_0` といった文字列は「量子化フォーマット」を表しています。元のモデル重み(16bit浮動小数点数 = fp16)を4bitや8bitの整数値に圧縮することで、モデルのファイルサイズと消費VRAMを大幅に削減する技術です。
多くのベンチマーク検証において、Q4_K_M(4-bit Medium K-quant) は、fp16と比較してメモリ消費量を約70%削減しながら、実用的な知能・Perplexity(言語予測精度)の劣化をわずか1%未満に抑えられることが実証されています。特別な理由がない限り、Ollamaでは常に Q4_K_M を標準として選択するのがベストプラクティスです。
エッジPC・ノートPCでの快適動作:NPU活用と軽量モデル(Phi-4-Mini / 7Bクラス)
「専用グラフィックボードを積んでいない薄型ノートPCでは動かないのか?」というと、決してそんなことはありません。近年のCopilot+ PCなどに搭載されているNPU(Neural Processing Unit)や、CPUのAVX-512命令セットの最適化により、軽量モデルであれば驚くほど軽快に動作します。
# 軽量かつ高性能なおすすめモデル一覧
ollama pull phi4-mini:3.8b   # Microsoftの小型推論モデル。極めて高精度
ollama pull qwen3:7b         # 8GB RAMでもサクサク動く日本語万能モデル
ollama pull gemma2:2b        # 最軽量。バックグラウンド常駐に最適
特にMicrosoftが公開した『Phi-4-Mini (3.8B)』は、従来の小型モデルの常識を覆す論理思考力と要約性能を備えており、外出先のノートPCやリソースの限られた仮想マシン環境でも大活躍します。
現場で役立つ実践導入戦略:UI連携・社内セキュリティ・リソース監視
コマンドライン(CLI)で動かすだけでは社内展開は定着しません。一般社員が迷わず使えるWebインターフェースの整備から、社内LANでの安全なアクセス制御、運用の可視化まで実践的な導入戦略を解説します。
Open WebUIとの連携による直感的な社内チャットボット環境構築
Ollama単体ではターミナル上でのCUI操作となりますが、オープンソースのWebフロントエンド『Open WebUI』と組み合わせることで、ChatGPTと全く同じ操作感のWebアプリケーション環境が数分で完成します。
# Dockerを用いたOpen WebUIとOllamaの連携起動
docker run -d -p 3000:8080   --add-host=host.docker.internal:host-gateway   -v open-webui:/app/backend/data   --name open-webui   --restart always   ghcr.io/open-webui/open-webui:main
Open WebUIを導入すれば、ユーザー管理機能、社内認証(LDAP/OAuth)、モデルのワンクリック切り替え、プロンプトテンプレートの全社共有、さらにはPDFやWordファイルをアップロードして質問できる社内ドキュメントRAG機能がすべて追加開発なしで手に入ります。
ネットワーク分離とリバースプロキシによる安全なエンドポイント運用
Ollamaはデフォルトでローカルホスト(`127.0.0.1:11434`)のみをリスンしています。社内サーバーとして複数人からアクセスさせる場合、`OLLAMA_HOST=0.0.0.0` を指定して全ポートを開放することはセキュリティ上厳禁です(認証機能がないため、不正なモデル削除やリソース占有の危険があります)。
必ずフロントにNginxやCaddyなどのリバースプロキシを配置し、HTTPS暗号化(SSL/TLS)、ベーシック認証または社内SSO、そしてレートリミット(リクエスト頻度制限)をかける多層防御アーキテクチャを構築してください。
社内シャドーAI防止と利用ログ・リソース消費の可視化管理
社内に快適で安全なローカルLLM環境を提供することは、従業員が会社の許可なく勝手に外部の無料AIサービスに機密を入力してしまう「シャドーAI」の発生を未然に防ぐ最も有効な特効薬です。
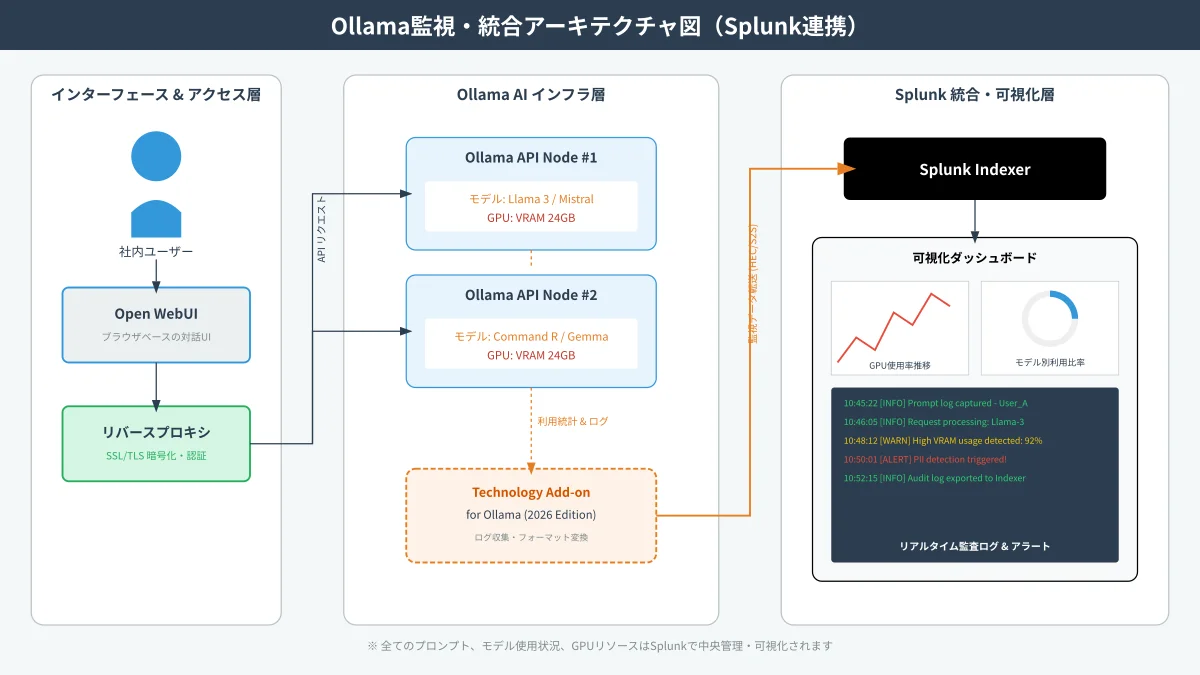
同時に、SplunkやPrometheus、Grafanaと連携して各部門のリクエスト頻度、GPU温度、VRAM使用率、トークン生成速度をリアルタイムに可視化しておくことで、ハードウェアの増設時期や利用規約の遵守状況をIT管理者が一目で把握できるようになります。
まとめ
2026年のOllamaは、日本語に圧倒的に強いQwen 3系、論理推論を極めたDeepSeek-R1、そして超長文処理を切り拓くMeta Llama 4など、クラウドAIに引けを取らない強力なオープンモデルを自在に操れる最高峰のプラットフォームです。
自社のハードウェア環境と目的に応じた最適なモデルを選定し、安全でコスト効率の高い自社AI基盤を確立していきましょう。
まずは手持ちのPCにOllamaをセットアップし、おすすめモデルの圧倒的な実力を体感してみてください。
【成果持ち帰り型3週間】
研修だけで終わらせない!「自社専用AI」定着パッケージ
「社員がAIを使えない」「自社商材に合わない」を解決。講師がその場で実務用にカスタマイズ。月額10万円〜。