(最終更新日: 2026年09月05日)
「Ollamaで新しいモデルをダウンロードしようとしたら、回線が途中で切断されて最初からやり直しになった」「ollama runとollama pullは一体何が違うのか」「社内ネットワークのプロキシ環境でダウンロードがタイムアウトしてしまう」とお困りではありませんか?
オープンソースLLM(大規模言語モデル)をローカルで自在に操るOllamaにおいて、モデルのダウンロードを司る「ollama pull」コマンドは、すべての開発・運用の起点となる最重要コマンドです。近年のモデルは数十GBクラスに達することも珍しくなく、効率的なダウンロードの仕組みやネットワーク設定を正しく理解していないと、ストレージの枯渇や長時間のダウンロード待ちで業務がストップしてしまいます。
本記事では、2026年最新のOllama環境におけるollama pullコマンドの内部メカニズム(マニフェスト・Blobs・レジューム機能)から、ollama runとの決定的な違い、2026年最新モデル(Llama 4、DeepSeek-R1、Qwen 2.5、Gemma)のタグ指定取得、そして社内プロキシや回線エラーの解消テクニックまでを完全網羅して解説します。
ollama pullコマンドの技術的詳細と実行の仕組み
Ollamaでモデルを取得する基本コマンドであるollama pullは、単なるファイルダウンロードにとどまらない高度な仕組みを持っています。本章では、ollama runとの決定的な違いやレイヤー構造による効率的なデータ転送の仕組みを解説します。
- ollama pull と ollama run の決定的な違いと使い分け
- マニフェストとレイヤー(Blobs)の並列ダウンロード・差分取得プロセス
- ネットワーク中断時の自動再開(レジューム機能)と整合性チェック
ollama pull と ollama run の決定的な違いと使い分け
初心者の方が最も迷いやすいのが、ollama pullとollama runの使い分けです。
ollama run <モデル名>は「モデルを起動して即座に対話を開始する」コマンドであり、手元にモデルが存在しない場合は自動的に内部でpullを実行してから起動します。そのため、個人がターミナルで手動テストするだけであればrunだけでも動作します。
しかし、システム運用やCI/CDパイプライン、Python等のAPI経由で呼び出す場合、初回アクセス時に数分〜数十分のダウンロード待機が発生するとAPIタイムアウトエラーを引き起こします。実務環境では、事前にollama pullを実行してローカルキャッシュを完全に温めておく運用が絶対のベストプラクティスです。
マニフェストとレイヤー(Blobs)の並列ダウンロード・差分取得プロセス
Ollamaのモデル配布構造は、Dockerコンテナイメージと非常によく似たOCI(Open Container Initiative)標準に準拠しています。
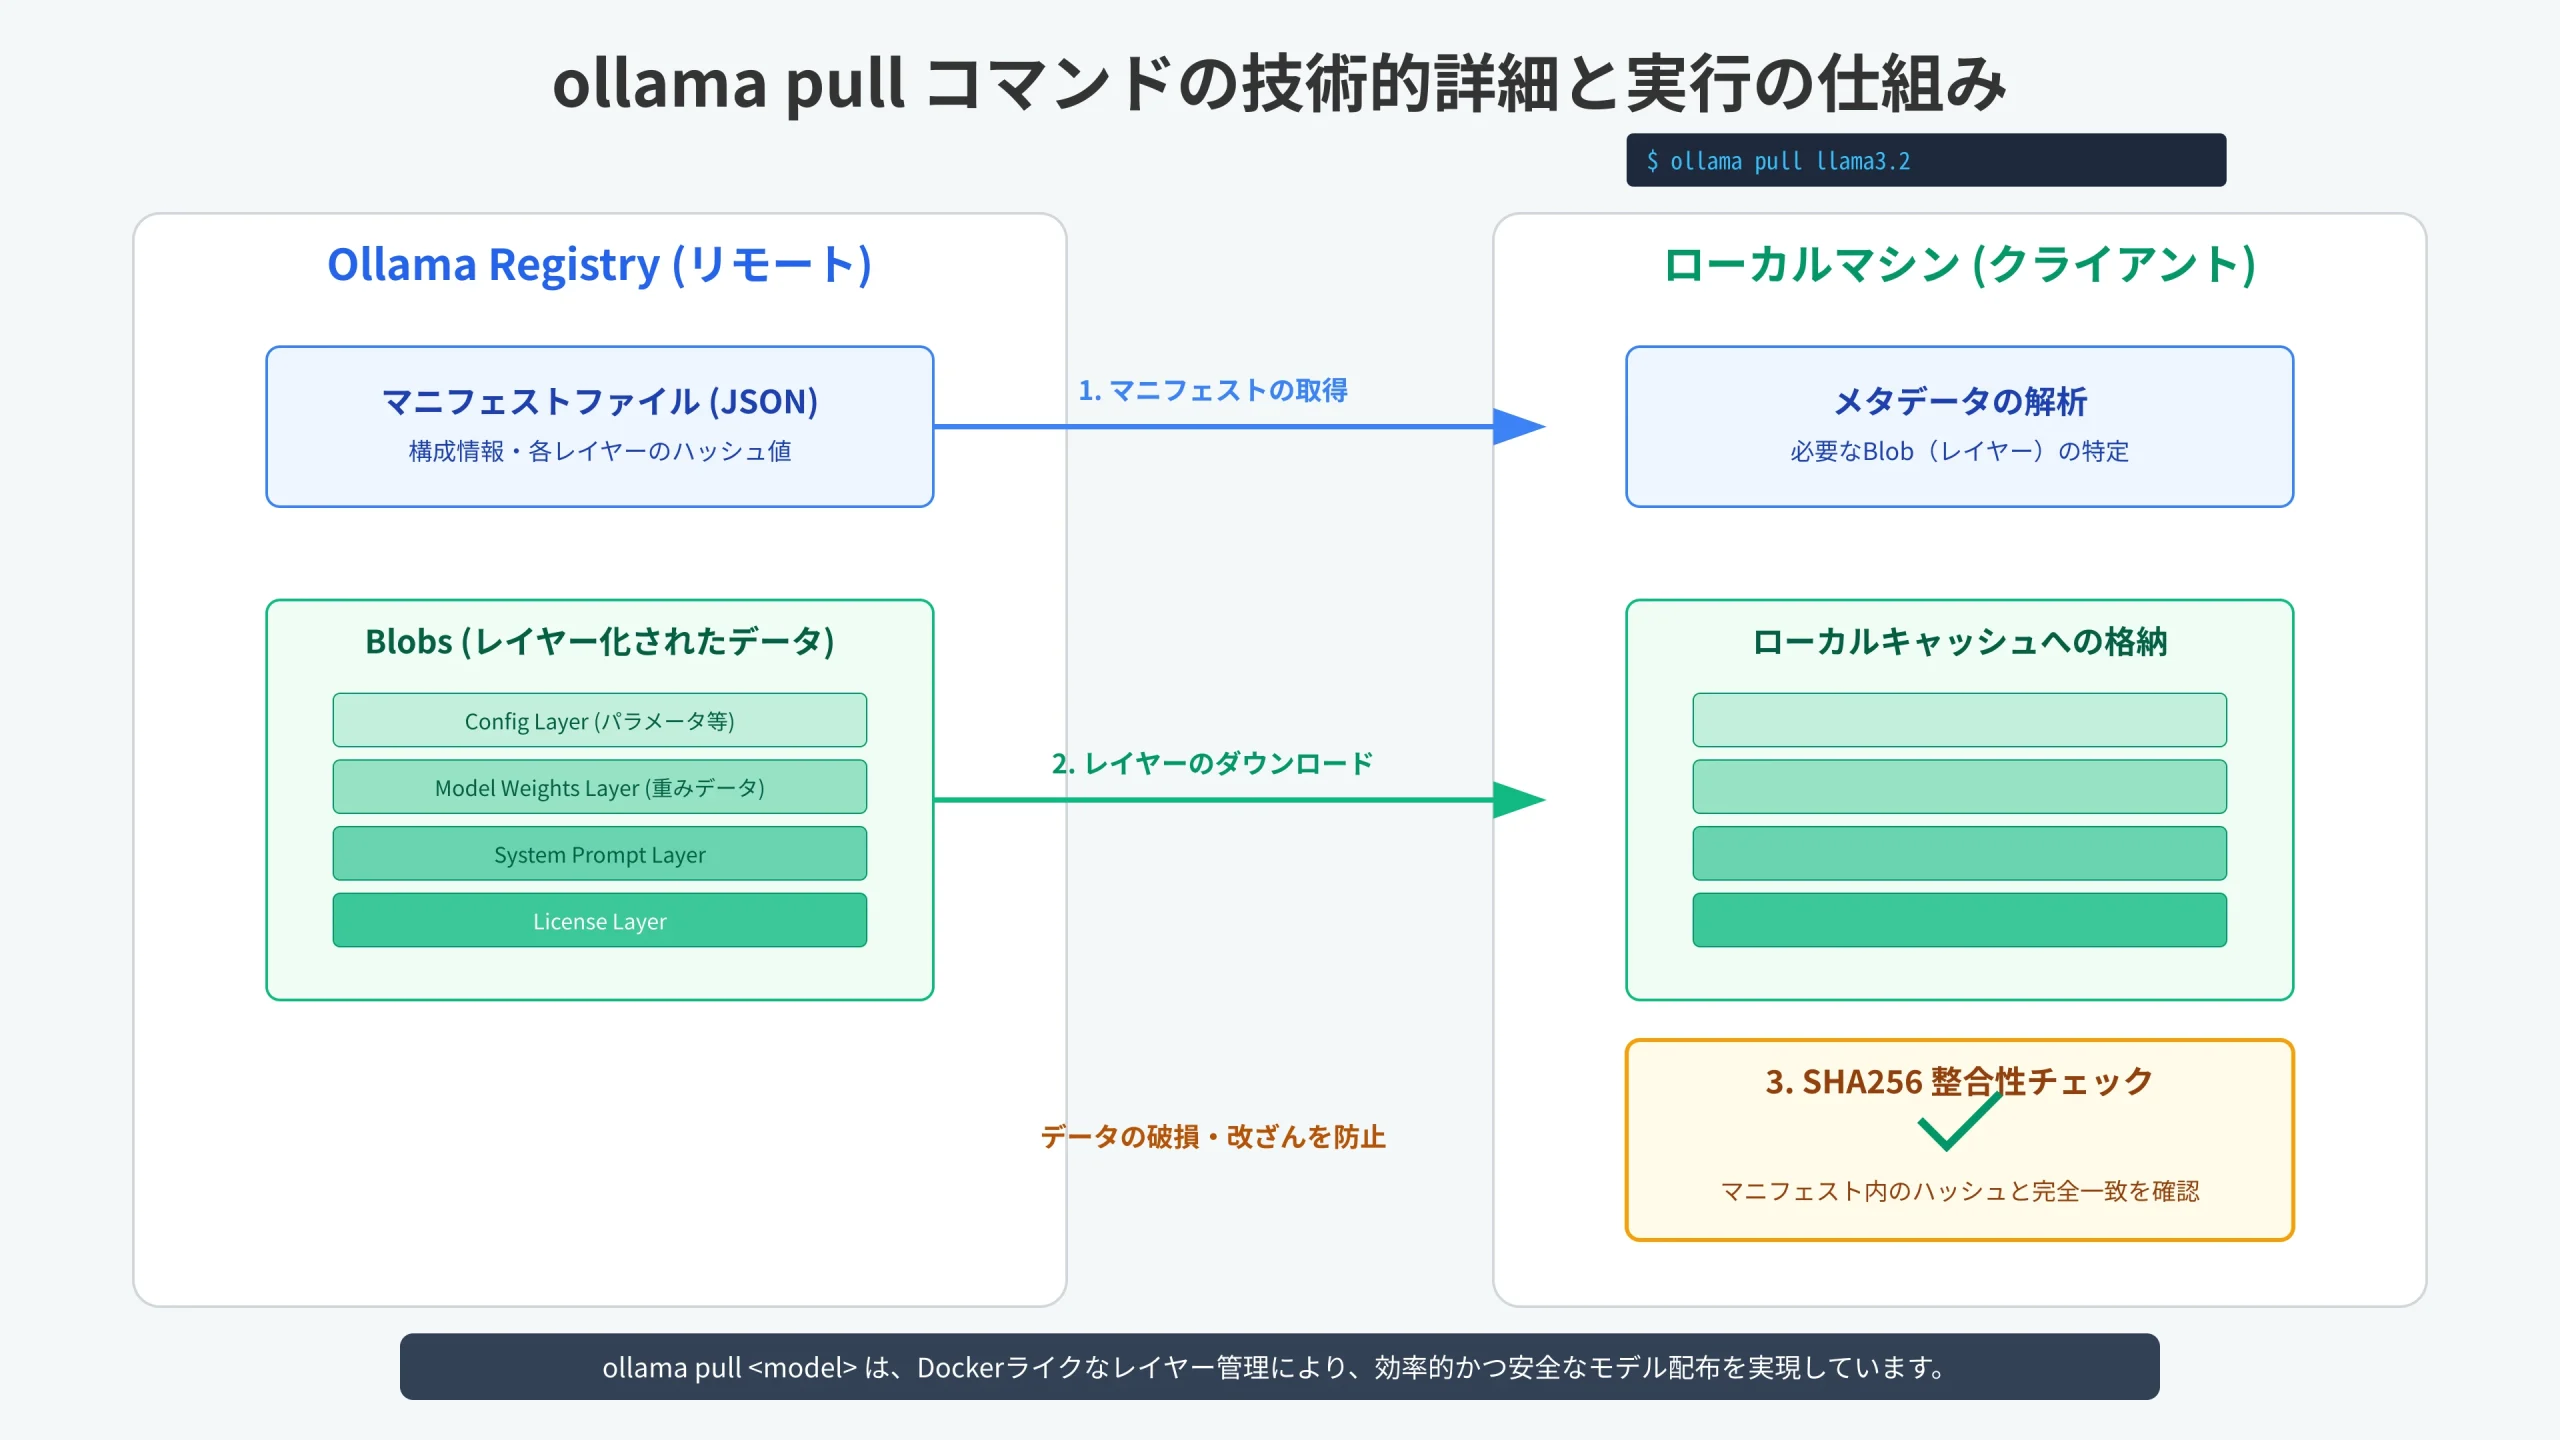
コマンドを実行すると、まず軽量なマニフェスト(JSON形式の設計図)を取得し、そこに記述されたSHA256ハッシュを持つ複数のレイヤー(Blobs: モデル重み、Modelfile、テンプレート、パラメータ等)を並列でダウンロードします。
共通のベースアーキテクチャを持つ派生モデルを複数導入する場合、すでに手元に存在するレイヤーの取得は自動でスキップされるため、通信量と所要時間を大幅に削減できます。
ネットワーク中断時の自動再開(レジューム機能)と整合性チェック
数十ギガバイトに及ぶ大容量モデルのダウンロード中にWi-Fiが瞬断したりPCがスリープした場合でも、最初からやり直す必要はありません。
Ollamaは各Blobのダウンロード進捗をローカルの不完全ファイル(.partial)として保持しており、再度同一のollama pullコマンドを実行することで、中断された直前のバイト位置から自動的に再開(レジューム)します。
全レイヤーの受信完了時にはSHA256ハッシュチェックによる整合性検証が厳密に行われるため、破損した重みファイルで誤作動を起こす心配もありません。
2026年最新版:ollama pullで今すぐ試すべき主要モデルとタグ指定術
オープンソースLLMの進化は凄まじく、モデルごとに用途や量子化形式が細かく分かれています。本章では2026年現在Ollamaで取得すべき代表的モデルの特徴と、タグ指定による最適な重みの選択方法を整理します。
- Meta Llama 4:驚異のコンテキスト長とマルチモーダル性能
- DeepSeek-R1:推論特化型Thinkingモデルのタグ別取得
- Qwen 2.5:日本語性能とコーディング特化モデルの導入
- Google Gemma 2/3:エッジ端末でも動く軽量高効率モデル
Meta Llama 4:驚異のコンテキスト長とマルチモーダル性能
2026年のオープンソース界隈を牽引するMetaのフラッグシップがLlama 4です。
# デフォルトの推奨タグを取得
ollama pull llama4

# 軽量な量子化版を取得(メモリ節約時)
ollama pull llama4:latest-q4_K_M
圧倒的な長文コンテキスト処理能力と高い日本語対応力を備えており、ドキュメント全体の要約や社内ナレッジの横断検索など、あらゆる汎用タスクの第一候補として活躍します。
DeepSeek-R1:推論特化型Thinkingモデルのタグ別取得
数学的思考や複雑なロジック設計、アルゴリズムの実装で圧倒的な強みを発揮するのがDeepSeek-R1です。
# 日常利用に最適な8Bクラス
ollama pull deepseek-r1:8b

# 高性能ワークステーション向けの32Bクラス
ollama pull deepseek-r1:32b
思考プロセス(<think>タグ)を段階的に出力しながら結論を導くアーキテクチャを持ち、難解なバグ調査や論理的な意思決定支援においてプロフェッショナルから絶大な支持を得ています。
Qwen 2.5:日本語性能とコーディング特化モデルの導入
日本語のニュアンス表現や漢字処理において商用APIに匹敵する精度を誇るのがQwen 2.5シリーズです。
# 日本語チャット・文章生成向け
ollama pull qwen2.5:7b

# プログラミング・スクリプト作成特化型
ollama pull qwen2.5-coder:7b一般対話向けのqwen2.5に加え、開発者向けにチューニングされたqwen2.5-coderも提供されており、日常のコーディングアシスタントとして手放せない存在となっています。
Google Gemma 2/3:エッジ端末でも動く軽量高効率モデル
GPUを搭載していない一般的なノートPCや、MacBook Airなどのオンボード環境で軽快に動かしたい場合はGoogle Gemmaが最適です。
# メモリ消費の少ない超軽量モデル
ollama pull gemma2:2b

# バランスの取れた9Bモデル
ollama pull gemma2:9b
コンパクトなパラメータ設計でありながら高い知識密度を持ち、社内チャットボットの試作や簡易的なテキスト分類タスクを極めて低い負荷で実現できます。
失敗しないモデルダウンロード:容量不足・プロキシ・回線エラー対策
数十GBに達するモデルのダウンロードでは、ネットワークの切断やストレージ不足などのトラブルがつきものです。本章では、ダウンロード失敗を未然に防ぎ、エラー発生時に迅速に対処するための実践的ノウハウを解説します。
- 事前チェック:モデルサイズと必要ディスク容量・VRAMの確認
- 社内プロキシ・企業ファイアウォール環境でのHTTP_PROXY設定
- ダウンロードが途中で止まる・遅い時のタイムアウト解消テクニック
- OLLAMA_MODELS環境変数による保存先SSD・外部ドライブ変更
事前チェック:モデルサイズと必要ディスク容量・VRAMの確認
ダウンロードを開始する前に、対象モデルが要求する「ディスク空き容量」と「実行時VRAM」を把握しておくことが極めて重要です。
例えば7B〜8Bクラスのモデルはディスク上で約4.5GB〜5GB、実行時に8GB程度のVRAM(または統合メモリ)を必要とします。14Bクラスなら約9GB、32Bクラスなら約20GB以上の空きが必須です。
空き容量が不足した状態でpullを開始すると、終盤で「no space left on device」エラーが発生してダウンロードが無駄になるため、事前に十分なマージンを確保しておきましょう。
社内プロキシ・企業ファイアウォール環境でのHTTP_PROXY設定
企業の社内LANからOllamaを利用する場合、プロキシサーバーを経由しない通信がブロックされ、connection refusedやtimeoutが発生することがあります。
Ollamaサービスに対してプロキシを認識させるには、環境変数HTTP_PROXYおよびHTTPS_PROXYを設定します。
# Linux(systemd)の場合の例: /etc/systemd/system/ollama.service.d/proxy.conf
[Service]
Environment="HTTP_PROXY=http://proxy.example.com:8080"
Environment="HTTPS_PROXY=http://proxy.example.com:8080"
Environment="NO_PROXY=localhost,127.0.0.1"Windows環境ではシステム環境変数に上記を設定し、Ollamaアプリをタスクトレイから完全に終了させて再起動することで、企業ネットワーク越しでもスムーズにpullが可能になります。
ダウンロードが途中で止まる・遅い時のタイムアウト解消テクニック
長時間のダウンロード中にタイムアウトエラーが発生する場合は、以下の対策を講じます。
1つ目は有線LANへの接続切り替え、2つ目は帯域の混雑する時間帯を避けた夜間バッチ実行、3つ目はDNSサーバーを信頼性の高いパブリックDNS(1.1.1.1や8.8.8.8)へ一時的に変更することです。
エラーで停止した場合も、前述の通り同一のollama pull <モデル名>を再入力すれば続きから即座に再開されます。
OLLAMA_MODELS環境変数による保存先SSD・外部ドライブ変更
メインのCドライブ(またはルートパーティション)が圧迫されている場合は、外付け高速SSDや大容量セカンダリドライブに保存先を移します。
# Windows PowerShellの場合
[System.Environment]::SetEnvironmentVariable('OLLAMA_MODELS', 'D:\ollama_models', 'User')

# Linux / macOSの場合(.bashrc や .zshrcに追記)
export OLLAMA_MODELS="/Volumes/FastSSD/ollama_models"環境変数を適用した状態でollama pullを実行すれば、指定したディレクトリ配下にBlobsが保存され、メインストレージの容量不足を完全に解消できます。
【応用】API自動化とエンタープライズ・ハイブリッド運用
手動でのコマンド実行だけでなく、スクリプトによる自動プロビジョニングやクラウドとのハイブリッド連携、セキュリティが厳しい環境での運用も可能です。本章ではエンタープライズ活用を見据えた応用テクニックを解説します。
- PythonやJavaScript、シェルスクリプトからのプログラマティックなモデルプル
- Ollama Cloudおよび外部API連携によるハイブリッド運用(:cloudタグ)
- 完全オフライン(エアギャップ)環境へのモデル移行とセキュリティ担保
PythonやJavaScript、シェルスクリプトからのプログラマティックなモデルプル
アプリケーションのデプロイ時やコンテナ初期化時にモデルを自動取得したい場合、OllamaのREST APIや公式SDKを活用できます。
import ollama

# Pythonからストリーミングで進捗を受け取りながらプル
progress = ollama.pull('qwen2.5:7b', stream=True)
for chunk in progress:
    status = chunk.get('status')
    total = chunk.get('total', 0)
    completed = chunk.get('completed', 0)
    if total > 0:
print(f"{status}: {completed / total * 100:.1f}%")プログラムからモデルの存在有無を確認し、未取得の場合のみpullを発行するロジックを組むことで、ユーザーに待機ストレスを与えない堅牢なAIアプリを構築できます。
Ollama Cloudおよび外部API連携によるハイブリッド運用(:cloudタグ)
ローカルマシンのスペックを超える超巨大モデル(70B〜400B超)を扱いたい場合、Ollama Cloud連携や外部エンドポイントとのハイブリッド構成が威力を発揮します。
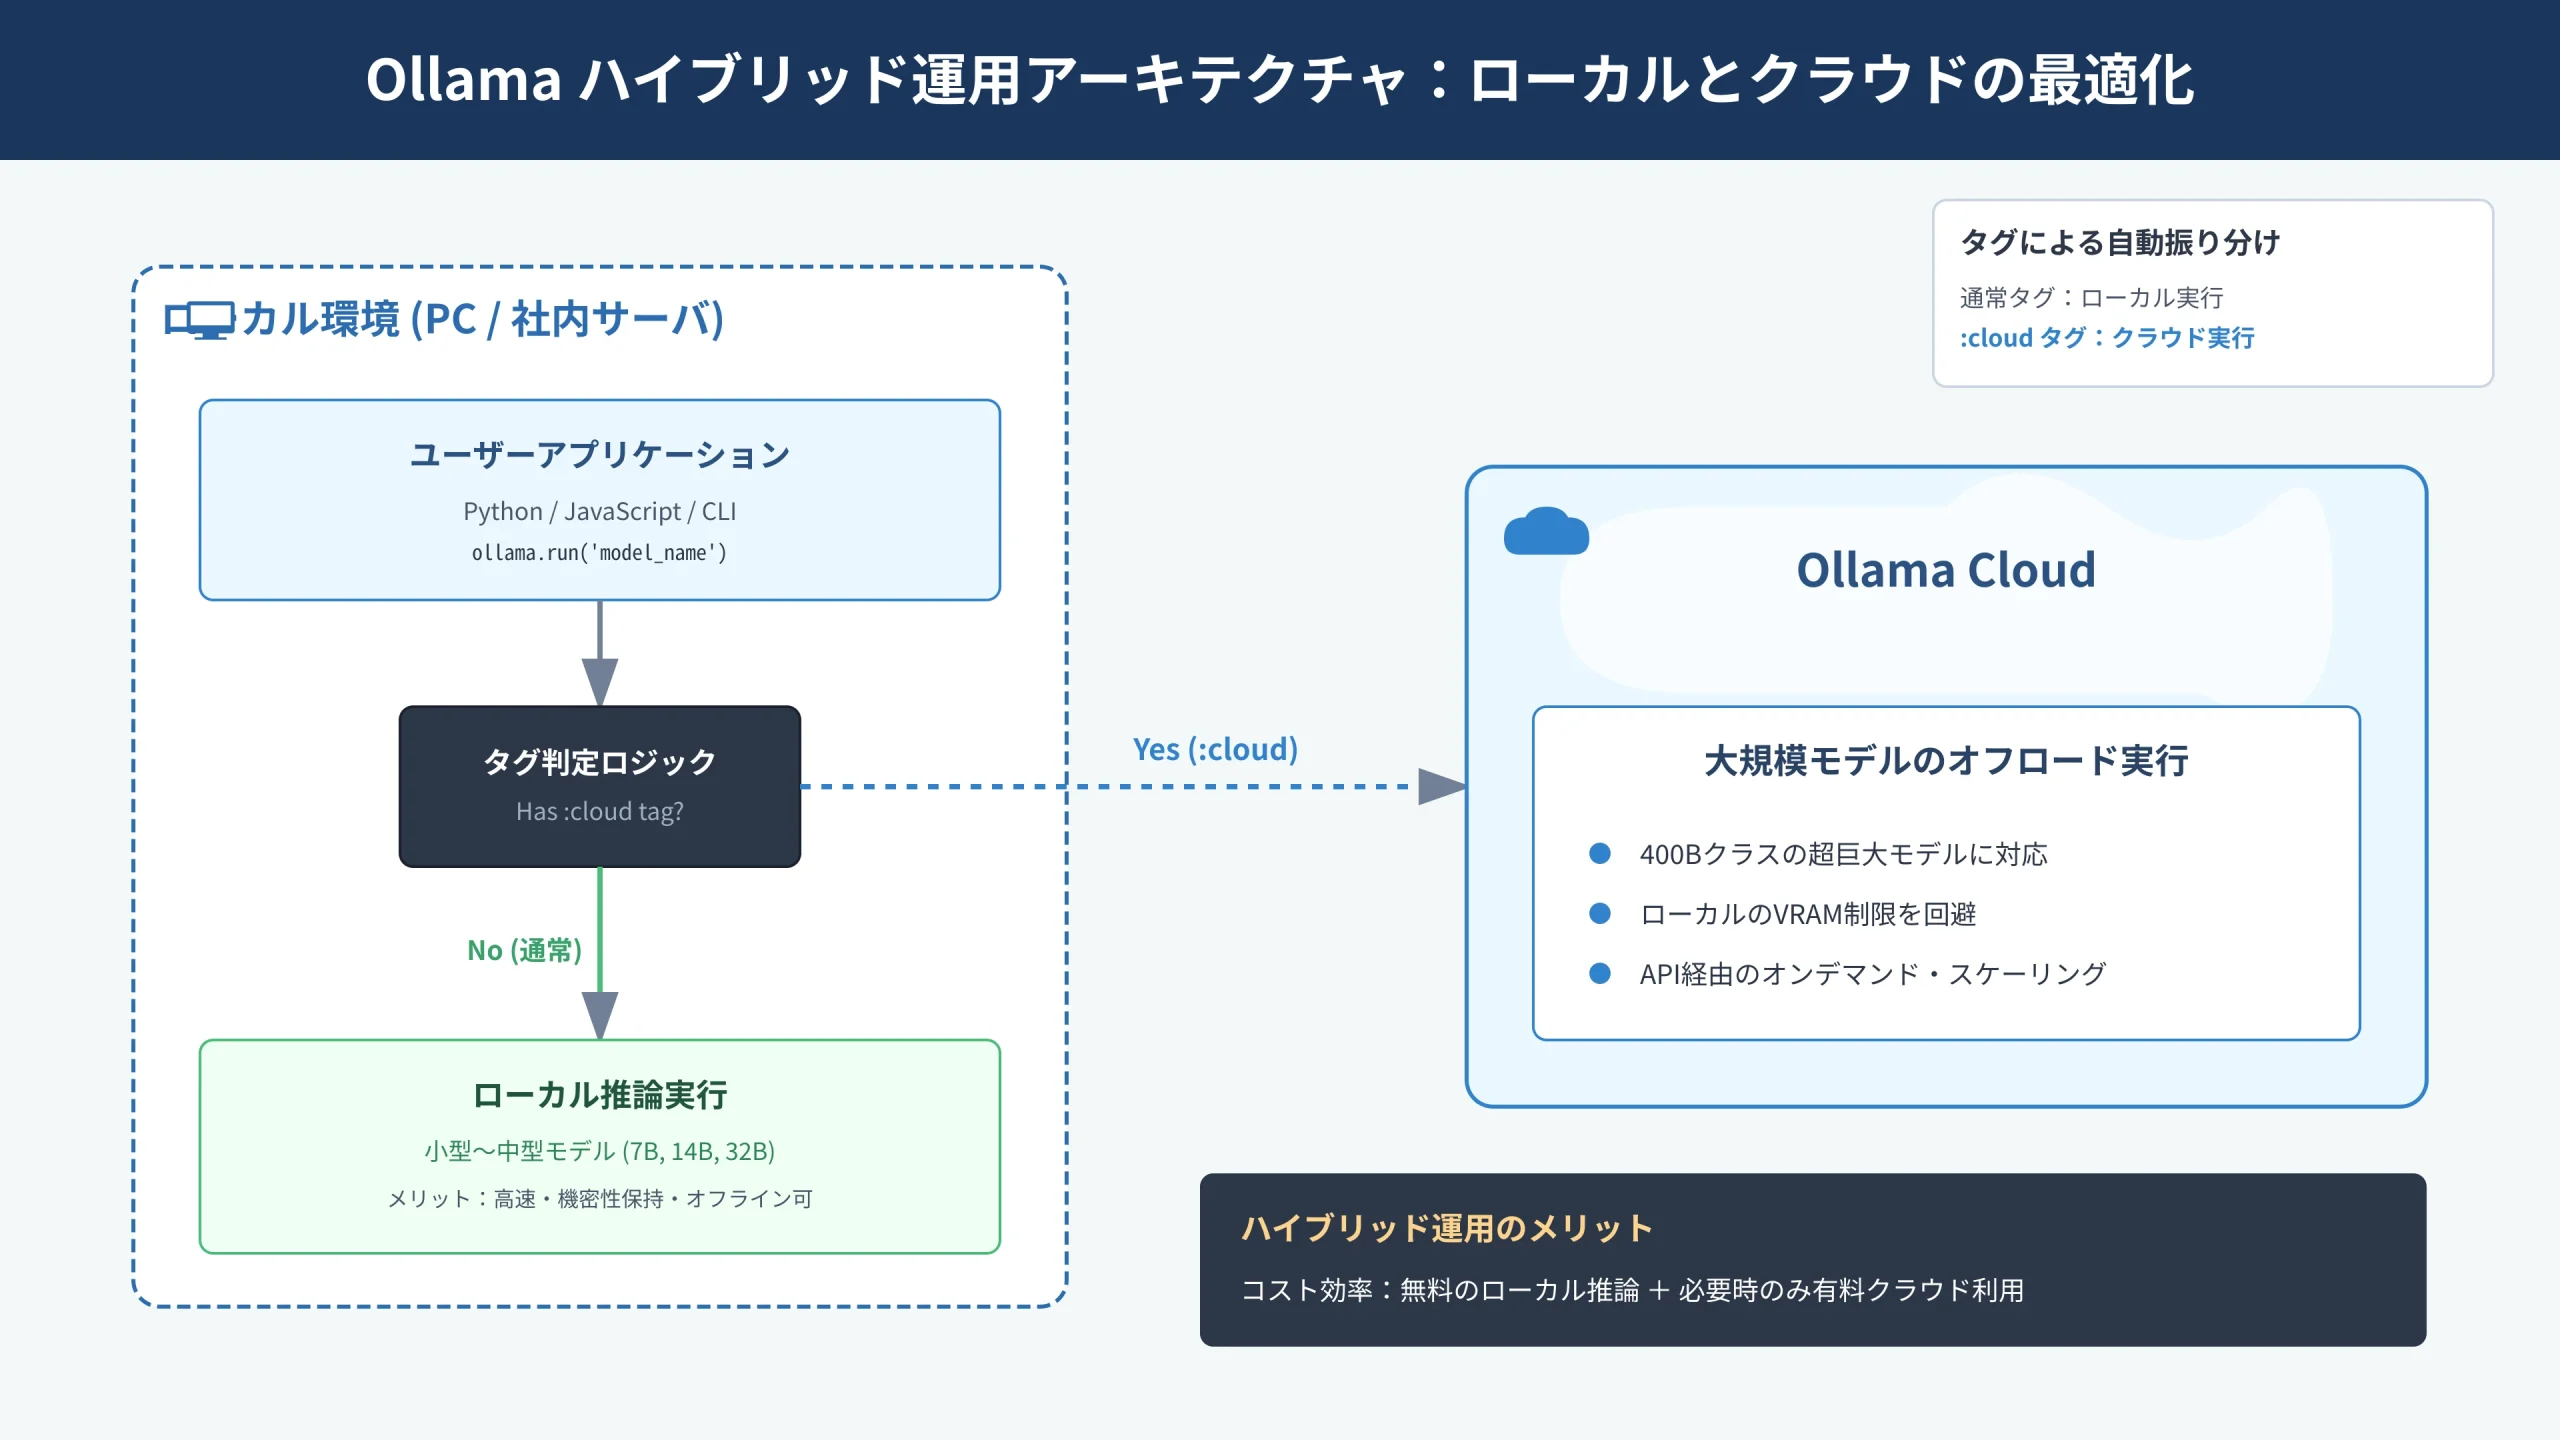
機密性の高い日常業務データはローカルでpullした7B/8Bモデルで処理し、極めて高度な推論が必要な局面のみクラウド側へフォールバックさせることで、セキュリティと計算能力の両立が実現します。
完全オフライン(エアギャップ)環境へのモデル移行とセキュリティ担保
インターネットから物理的に隔離された官公庁・金融・医療などのエアギャップ環境では、外部への直接的なollama pullが実行できません。
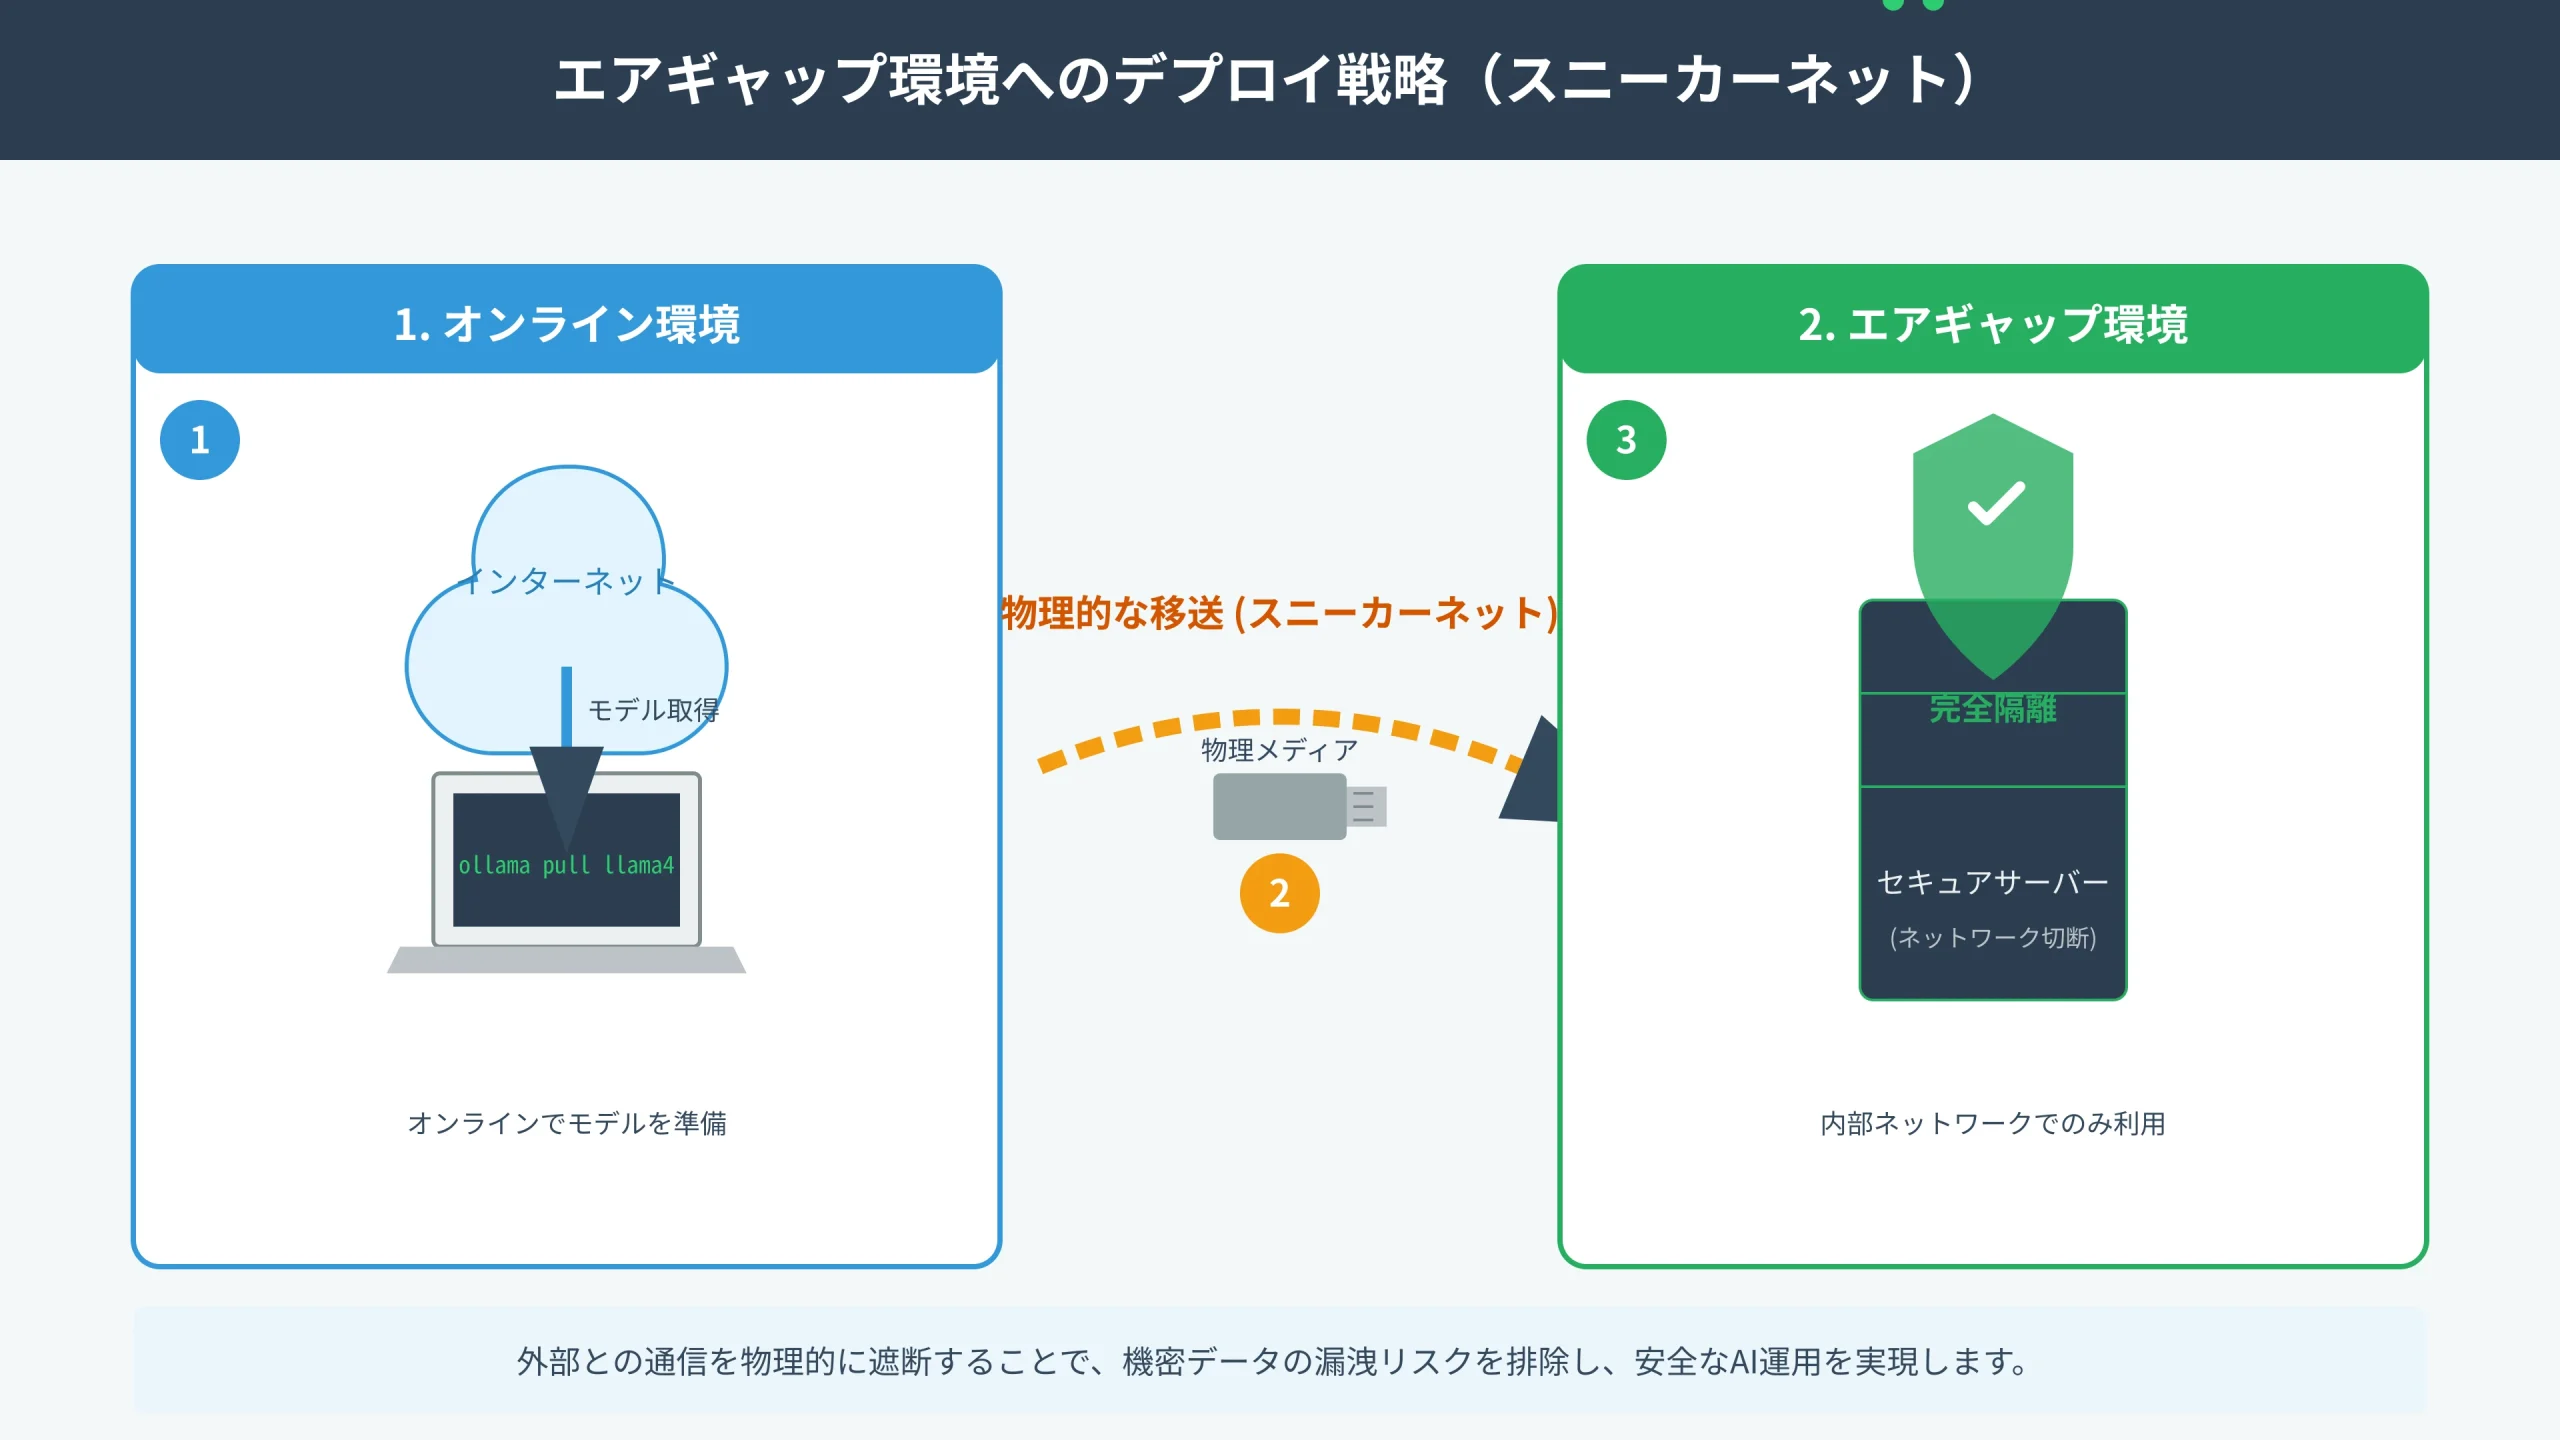
このようなケースでは、外部接続可能な端末で事前にモデルをpullした上で、~/.ollama/modelsディレクトリ配下のマニフェストおよびBlobsを暗号化USB等の安全な記録媒体で搬入します。
配置後にollama listでモデルが認識されれば、完全なオフライン状態を維持したまま最高水準のローカルAI基盤を稼働させることができます。
まとめ
Ollamaのモデル取得を司るollama pullコマンドは、ローカルLLMを安全・迅速にプロビジョニングし、快適なAI活用を支える基幹操作です。
レイヤー構造やレジューム機能の仕組みを理解し、マシンスペックに応じた最新モデル(Llama 4、DeepSeek-R1、Qwen 2.5等)の適切なタグ指定、そしてプロキシや保存先ドライブの設定をマスターすることで、いかなる開発環境でもストレスのないローカルAI運用が可能になります。
まずは気になる最新モデルをターミナルからpullして、手元で動く最先端AIの驚異的なパワーを今すぐ体験してみましょう!
【成果持ち帰り型3週間】
研修だけで終わらせない!「自社専用AI」定着パッケージ
「社員がAIを使えない」「自社商材に合わない」を解決。講師がその場で実務用にカスタマイズ。月額10万円〜。
自社に最適なローカルAI環境を構築し、セキュアで高効率な業務DXを実現していきましょう。
社内規程・技術文書・実験データを安全に検索できる「自社専用RAG」を構築しませんか?
数千万円の丸投げ開発やブラックボックス化を回避。PMP®保有PMが月額20万円の伴走アドバイザリーで要所設計・権限管理を支援します。