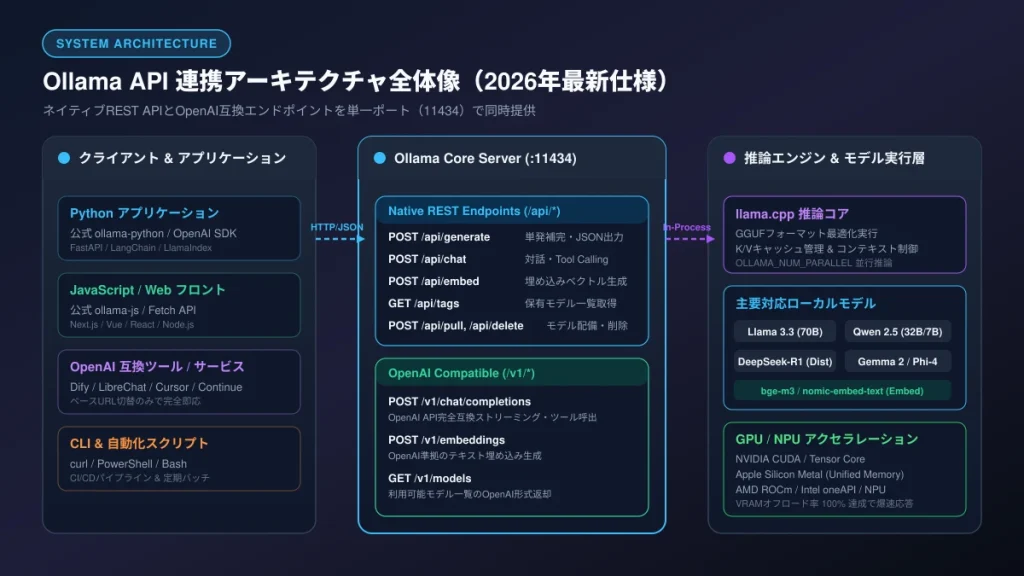
オープンソースの大規模言語モデル(LLM)を誰でも手軽にローカル実行できる革命的ツールとして、世界中で圧倒的なシェアを誇る「Ollama」。2024年から2026年にかけて、オープンモデルの世界では「DeepSeek-R1」「Qwen 2.5」「Llama 3.3」といった第4世代の超高性能モデルが次々と登場し、かつての「ローカルLLMはクラウドSaaSに比べて知能が劣る」という常識は完全に覆されました。
現在、Ollama公式ライブラリには数千を超えるモデルが登録されており、ビジネス文書の日本語要約から、難関アルゴリズムの思考型推論(o1風推論)、自律コーディング、画像認識(マルチモーダル)、社内文書検索(RAG用のEmbedding)に至るまで、あらゆるAIタスクがローカルPC単体で完結します。しかし、あまりにもモデルの選択肢が増えた結果、多くの開発者や情シス担当者から「自分のPCスペック(メモリ・VRAM)で快適に動くモデルはどれか?」「日本語実務に最も適したモデルはどれか?」「ダウンロードしたモデルのストレージ管理や削除はどうやるのか?」といった切実な疑問が寄せられています。
本記事では、2026年最新のOllamaエコシステムを完全網羅し、モデルの内部構造(GGUF・量子化・保存場所)から、用途別のおすすめ最強モデル比較、ハードウェアスペックに応じた失敗しないモデル選定マトリクス、実務で必須のCLIコマンド(pull, run, ps, stop, rm)、さらにはModelfileによる独自モデル自作やOpen WebUI・Dify連携までを徹底解説します。手持ちのPCリソースを極限まで引き出し、最高峰のローカルAI環境を構築しましょう。
Ollamaのモデルアーキテクチャと動作の仕組み:GGUF・量子化・保存場所
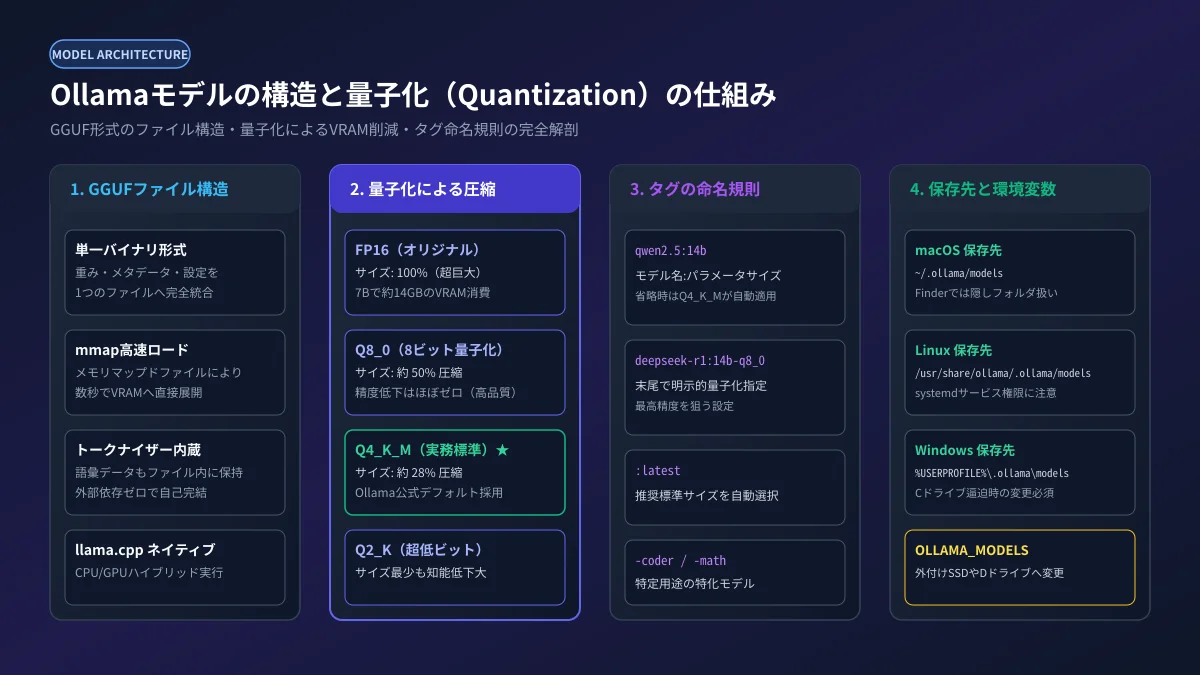
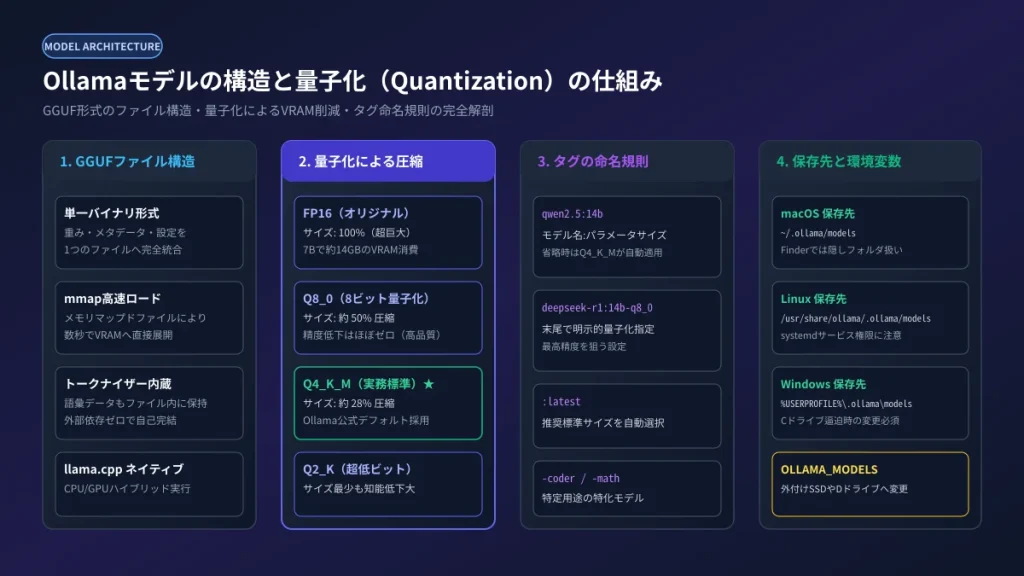
Ollamaでモデルを効率的に運用するためには、まず「モデルファイルがどのような形式で保存され、どのようにVRAM(ビデオメモリ)へロードされて動作しているのか」という基盤アーキテクチャを理解しておくことが不可欠です。Ollamaの高速動作と手軽さの秘密は、標準フォーマットである「GGUF」と高度な「量子化(Quantization)」技術にあります。
- GGUF形式とモデル重みパラメータ(B表記)の基礎知識
- 量子化方式(Q4_K_M・Q5_K_M・Q8_0)による精度と速度のトレードオフ
- タグとバージョンの読み方(サイズ・Instruct・量子化識別子)
- OS別のモデル保存場所確認とストレージ容量管理・ドライブ変更テクニック
GGUF形式とモデル重みパラメータ(B表記)の基礎知識
Ollamaのバックエンドには、オープンソースで極めて高い評価を受けるC++製推論エンジン「llama.cpp」が組み込まれています。そして、llama.cppおよびOllamaで統一的に採用されているモデルファイル形式が「GGUF(GPT-Generated Unified Format)」です。
GGUFが登場する以前は、モデルの重みファイル(SafetensorsやPyTorch bin)と、トークナイザー設定(JSON)、ハイパーパラメータ設定がバラバラの複数ファイルに分かれており、環境構築のたびにPythonの依存ライブラリやPyTorchのバージョン不整合に悩まされていました。GGUFはこれらを「単一のバイナリファイル」へと完全に統合した革新的なフォーマットです。
GGUFの最大の強みは、OSの仮想メモリ機能である「mmap(メモリマップドファイル)」をネイティブ活用できる点です。数十GBに及ぶ巨大なモデルファイルであっても、ディスクから直接GPUのVRAMやCPUのRAMへゼロコピーで瞬時に展開できるため、モデル切り替え時のロード時間が数秒〜十数秒という驚異的なスピードで完了します。
また、モデル名によく付いている「7B」「14B」「70B」といった表記の「B」は「Billion(10億)」を表し、モデルが持つ学習パラメータの総数を意味します。例えば「14B」であれば「140億個のパラメータ(ニューロンの結合の強さ)」を持っています。一般にパラメータ数が多いほど高度な知能と論理的推論力を発揮しますが、その分だけ必要となるメモリ量と計算リソースが増大します。
量子化方式(Q4_K_M・Q5_K_M・Q8_0)による精度と速度のトレードオフ
学習直後のオリジナルモデルは、通常「FP16(16ビット浮動小数点数)」という高精度な数値形式で重みが保持されています。しかし、FP16のまま動かそうとすると、7Bモデルですら約14GB〜16GB、70Bモデルでは140GB以上のVRAMが必要となり、一般のPCでは到底動作させることができません。
そこで用いられるのが、数値の桁数を削減してメモリ消費量を劇的に圧縮する「量子化(Quantization)」です。
| 量子化方式 | 1パラメータあたりのビット数 | FP16比のサイズ | 精度劣化の度合い | 実務での推奨度と特徴 |
|---|---|---|---|---|
| FP16(非量子化) | 16 bit | 100%(基準) | 劣化ゼロ(最高) | 研究・学習用。一般ローカル推論ではVRAM消費が大きすぎて不向き。 |
| Q8_0 | 8 bit | 約 50% | ほぼ知覚不能(極小) | 最高品質を求め、かつ十分なVRAM余力があるハイエンド環境向け。 |
| Q5_K_M | 5 bit(混合) | 約 35% | 極めて小さい | Q4よりもわずかに賢くしたい場合の絶妙な上位選択肢。 |
| Q4_K_M ★ | 4 bit(混合) | 約 28% | わずか(実用上十分) | Ollamaの公式デフォルト標準。速度・知能・VRAMの黄金比。 |
| Q2_K / IQ2 | 2 bit相当 | 約 15% | 無視できない劣化あり | 極限までメモリが足りない環境以外では非推奨。 |
Ollamaで ollama pull qwen2.5:14b や ollama run llama3.3 と指定した際にデフォルトでダウンロードされるのは、最もバランスの取れた「Q4_K_M」です。これは単純な4ビット化ではなく、重要なアテンション層には高ビットを割り当て、影響の少ない層を低ビットにする「K-quant」と呼ばれる高度な混合量子化技術を採用しています。その結果、知能の劣化をわずか数パーセントに抑えながら、VRAM消費量をオリジナルの約4分の1へと削減しています。
タグとバージョンの読み方(サイズ・Instruct・量子化識別子)
Ollamaのモデルライブラリでは、Dockerコンテナのイメージ名と非常によく似た「タグ記法」が採用されています。
# 基本構文
<モデル名>:<パラメータサイズ>-<特化タイプ>-<量子化方式>
例えば、以下のようなタグが存在します。
qwen2.5:latest(またはqwen2.5): パラメータサイズを省略した場合、公式が推奨する標準サイズ(通常7B)のQ4_K_M量子化版がダウンロードされます。qwen2.5:14b: Qwen 2.5の14Bモデル(Q4_K_M)を指定。qwen2.5:14b-instruct-q8_0: 14Bの対話指示チューニング版に対し、明示的に最高精度のQ8_0量子化を指定。deepseek-r1:14b: DeepSeek-R1の推論アルゴリズムをQwen 14Bに蒸留した思考特化モデル。qwen2.5-coder:14b: プログラミングコード生成・補完に特化した専門モデル。
タグの指定ミスで想定外の巨大モデル(70Bなど)をダウンロードしてディスクやVRAMを圧迫しないよう、タグ名に含まれる「パラメータ数」と「量子化識別子」を常に意識する習慣をつけましょう。
OS別のモデル保存場所確認とストレージ容量管理・ドライブ変更テクニック
Ollamaで複数のモデルをダウンロードしていると、「いつの間にかCドライブの空き容量がゼロになっていた」というトラブルが日常茶飯事となります。14Bモデルは1つで約9GB、70Bモデルは1つで40GB以上のディスク容量を消費するためです。
OSごとのデフォルトのモデル保存パスは以下の通りです。
- macOS:
~/.ollama/models(ホームディレクトリ配下の隠しフォルダ) - Linux:
/usr/share/ollama/.ollama/models(systemdサービス実行時)または~/.ollama/models - Windows:
C:\Users\<ユーザー名>\.ollama\models
メインドライブ(CドライブやMacの内蔵SSD)の容量を節約し、外付けSSDや大容量のDドライブにモデル保存先を変更したい場合は、環境変数 OLLAMA_MODELS を設定します。
# Linux / macOS の一時的な変更例
export OLLAMA_MODELS="/Volumes/ExternalSSD/ollama_models"
ollama serve

# Windows(システム環境変数の追加)
# 変数名: OLLAMA_MODELS
# 変数値: D:\ollama_models
Windowsの場合は「システム環境変数の編集」から OLLAMA_MODELS を追加し、タスクバーの通知領域にあるOllamaアイコンを右クリックして「Quit Ollama」で完全に終了させてから再起動します。これだけで、以降のすべてのモデルダウンロードがDドライブ側へ保存されるようになります。
【用途別】2026年最新Ollamaおすすめモデル一覧と比較マトリクス
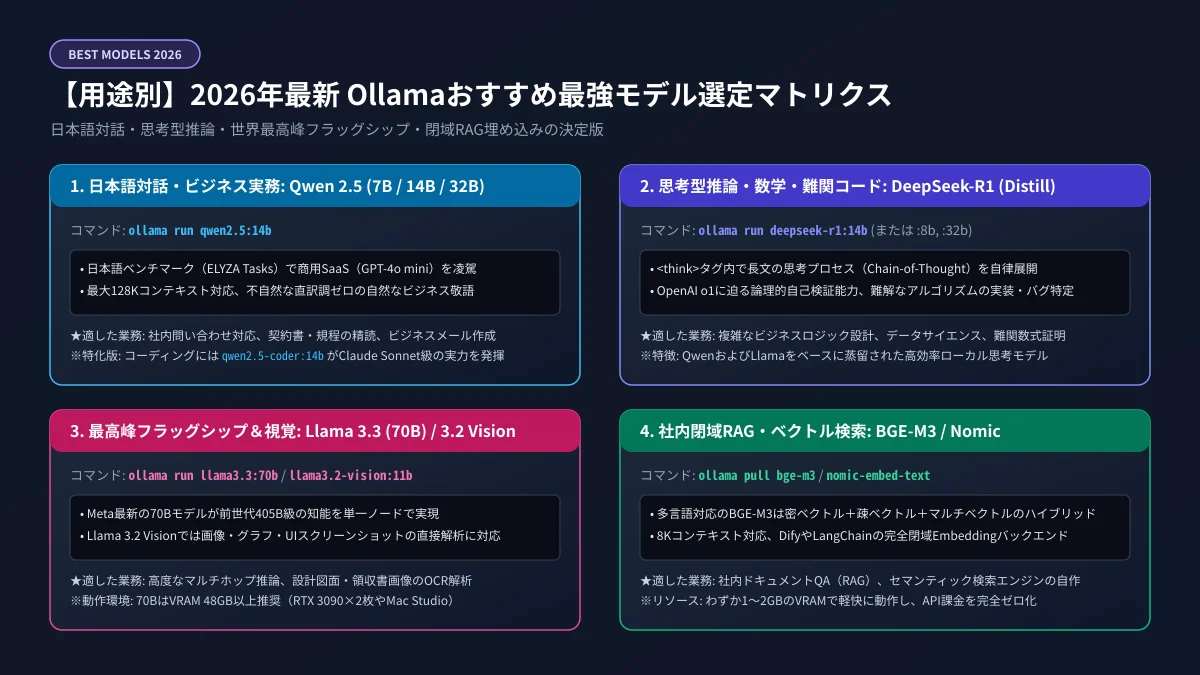
2026年現在、Ollamaで利用可能なモデルの選択肢は非常に充実しています。しかし、「どのモデルも万能」というわけではありません。日本語の自然さ、推論・数学の論理性、コーディング能力、多言語フラッグシップ、社内検索用のベクトル化など、業務の目的に応じて最適なモデルを使い分けることが成功の鍵となります。
- 日本語対話・ビジネス文書の絶対王者「Qwen 2.5(7B/14B/32B)」
- 驚異の思考型推論・コーディング特化「DeepSeek-R1(蒸留モデル)」
- 世界最高峰の多言語フラッグシップ「Llama 3.3(70B)」と画像認識「Llama 3.2 Vision」
- 閉域RAG・社内文書検索に必須の埋め込みモデル「bge-m3 / nomic-embed-text」
日本語対話・ビジネス文書の絶対王者「Qwen 2.5(7B/14B/32B)」
日本のビジネス実務において、まず最初に導入すべき鉄板の絶対王者がAlibaba Cloudの「Qwen 2.5」シリーズです。
# 最もおすすめの14Bモデル
ollama run qwen2.5:14b

# コーディング特化版
ollama run qwen2.5-coder:14b
18兆トークンもの多言語高品質データで事前学習されており、日本の評価ベンチマーク「ELYZA Tasks 100」において、14Bや32Bモデルが商用のGPT-4o miniを凌駕するスコアを記録しています。従来のオープンモデルにありがちだった「不自然な直訳日本語」「中国語簡体字の混入」が徹底的に排除されており、敬語や謙譲語、日本の商習慣に則ったビジネスメール作成、複雑な契約条項の要約において、商用クラウドSaaSと遜色のない極めて自然なテキストを出力します。
さらに、コーディング特化の「Qwen 2.5-Coder」は、HumanEvalにおいてClaude 3.5 Sonnetに迫る数値をマークしており、VS Codeのローカルコーディング支援(Continue連携)のバックエンドとして世界中でデファクトスタンダードとなっています。Qwen 2.5の詳細なスペックやModelfileチューニングについては、関連記事『Ollama×Qwen 2.5完全攻略ガイド』で余すところなく解説しています。
驚異の思考型推論・コーディング特化「DeepSeek-R1(蒸留モデル)」
2025年初頭から世界を震撼させたのが、中国DeepSeek社が開発した強化学習ベースの思考型推論モデル「DeepSeek-R1」です。Ollamaでは、671Bのフルサイズだけでなく、QwenやLlamaのアーキテクチャにその思考アルゴリズムを蒸留した軽量モデル群(1.5B, 7B, 8B, 14B, 32B, 70B)が提供されています。
# 実務で扱いやすい14B思考モデル
ollama run deepseek-r1:14b

# エントリー環境向けの8Bモデル(Llamaベース)
ollama run deepseek-r1:8b
DeepSeek-R1の最大の特徴は、ユーザーからの質問に対し、回答を出力する前に <think> ... </think> というタグの中で長文の「思考プロセス(Chain-of-Thought)」を自律的に展開する点です。自らの推論の矛盾を自問自答しながら検証し、間違った前提を自ら修正してから最終結論を導き出します。
この仕組みにより、数学の難問、複雑な業務ルールの論理パズル、難解なバグの原因究明、データサイエンスの仮説検証において、OpenAI o1に肉薄する圧倒的な問題解決能力を発揮します。「じっくり考えさせて精度の高い回答を得たい」という知的タスクにおいて、無類の強さを誇ります。
世界最高峰の多言語フラッグシップ「Llama 3.3(70B)」と画像認識「Llama 3.2 Vision」
オープンソースLLMの生態系を牽引するMeta社のフラッグシップモデルが「Llama 3.3(70B)」です。
# 最高峰70Bフラッグシップ
ollama run llama3.3:70b

# 画像認識マルチモーダルモデル
ollama run llama3.2-vision:11b
Llama 3.3(70B)は、前世代の超巨大モデルであるLlama 3.1(405B)に匹敵する知能を、わずか70Bのパラメータサイズへと凝縮することに成功したMetaの最高傑作です。多言語推論、指示追従性、数学、ツール呼び出し(Function Calling)のすべての領域でオープンモデルの最高峰に位置します。
また、「Llama 3.2 Vision(11B / 90B)」を導入すると、Ollama上でテキストだけでなく画像の直接読み込みが可能になります。ターミナル上で画像ファイルのパスを指定するか、API経由でBase64エンコードした画像データを送信することで、グラフの数値読み取り、手書き図面の文字起こし、UIモックアップからのHTMLコード生成などを完全ローカルで安全に実行できます。
閉域RAG・社内文書検索に必須の埋め込みモデル「bge-m3 / nomic-embed-text」
社内Wikiやマニュアル、過去の議事録を検索して回答を生成する「RAG(検索拡張生成)」システムを構築する場合、チャット用のLLMだけでなく、テキストをベクトル(数値配列)に変換する「Embedding(埋め込み)モデル」が不可欠です。
# 多言語ハイブリッド検索の最高峰
ollama pull bge-m3

# 英語・軽量ドキュメント向け標準
ollama pull nomic-embed-text
特に北京智源人工知能研究院(BAAI)が開発した「BGE-M3」は、100以上の言語に対応し、最大8192トークンの長文コンテキスト長をサポートする世界最強クラスの多言語埋め込みモデルです。「密ベクトル(Dense)」「疎ベクトル(Sparse / BM25類似)」「マルチベクトル(ColBERT)」の3つの検索手法を1つのモデルで同時に扱えるハイブリッド機能を備えています。
Difyなどの外部プラットフォームと連携する際、Ollama上の bge-m3 をEmbeddingプロバイダーとして指定することで、社内機密文書を一切外部のクラウドAPIに送信することなく、高精度な社内ナレッジ検索基盤を完全無料で構築できます。Difyとの具体的な連携手順については、関連記事『Dify×Ollama完全攻略ガイド』をご参照ください。
【PCスペック・VRAM別】失敗しないOllamaモデル選定基準とサイジング
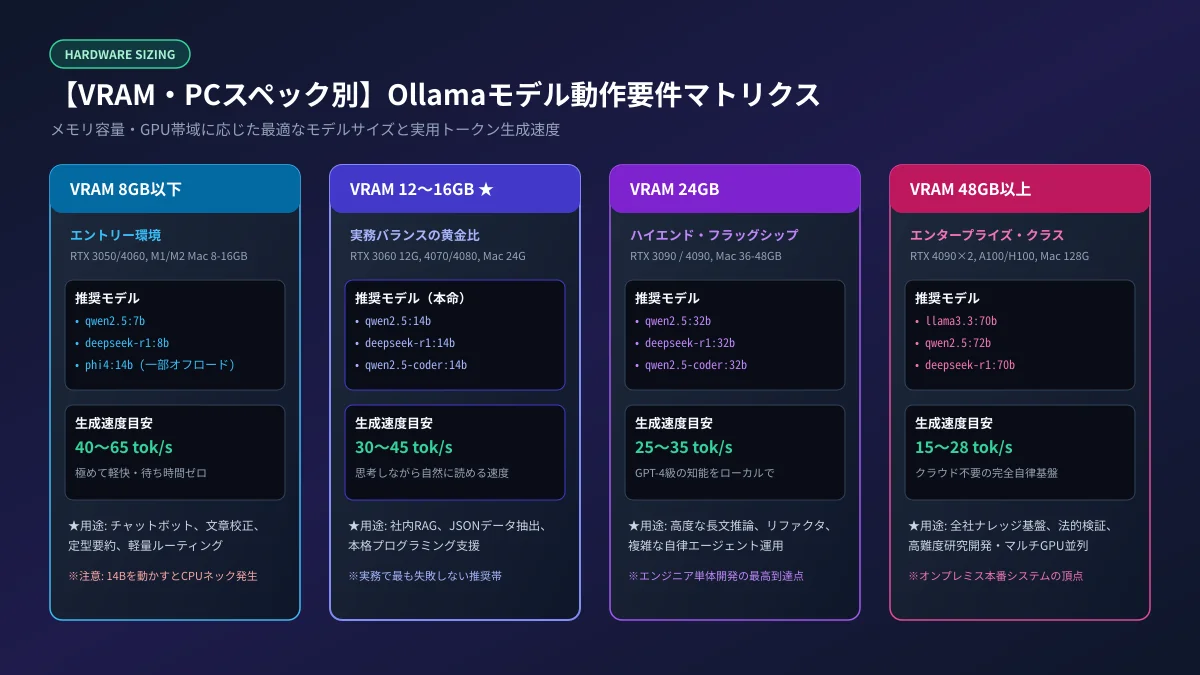
ローカルLLMを動かす際、最も重要なハードウェア資源は「GPUのVRAM(ビデオメモリ)」です。VRAMの容量が足りないと、推論処理がメインメモリ(CPU RAM)へ押し出され、生成速度が毎秒1〜3文字程度まで劇的に落ち込んでしまいます。手持ちのマシンスペックに合わせて、最適なモデルサイズを正確に見極める基準を解説します。
- VRAM 8GB以下(日常ノートPC/エントリーGPU):軽快に動く0.5B〜7Bクラス
- VRAM 12GB〜16GB(実務開発PC/ミドルGPU):最強バランスの14Bクラス
- VRAM 24GB(ハイエンドRTX 4090/M3 Mac):GPT-4級の頭脳を持つ32Bクラス
- VRAM 48GB以上(マルチGPU/Mac Studio):エンタープライズを支える70B〜72Bクラス
VRAM 8GB以下(日常ノートPC/エントリーGPU):軽快に動く0.5B〜7Bクラス
一般的なオフィス用ノートPC、エントリーゲーミングPC(GeForce RTX 3050, RTX 4060 8GB等)、あるいはメモリ8GB〜16GBのM1/M2/M3 MacBook Airなどの環境では、0.5B〜7B/8Bクラスのモデルが主戦場となります。
| モデル名 | パラメータ | ファイルサイズ | 必要VRAM目安 | 生成速度目安 | 得意なタスク |
|---|---|---|---|---|---|
qwen2.5:0.5b |
0.5B | 約 398 MB | 約 1.0 GB | 80〜120 tok/s | JSON正規化, ルーティング |
qwen2.5:3b |
3B | 約 1.9 GB | 約 2.5 GB | 50〜70 tok/s | 短文要約, 簡易メール作成 |
qwen2.5:7b |
7B | 約 4.7 GB | 約 5.5 GB | 40〜60 tok/s | 一般的な日本語対話, 文章校正 |
deepseek-r1:8b |
8B | 約 4.9 GB | 約 6.0 GB | 35〜50 tok/s | 軽量な論理推論, コードデバッグ |
特に「Qwen 2.5:7b」はファイルサイズが約4.7GBであり、8GBのVRAM内に全レイヤーを余裕を持って常駐させることができます。生成速度も毎秒40〜60トークンと非常に高速であり、待ち時間のストレスなく軽快な対話が楽しめます。
このクラスで注意すべき点は、「長文コンテキスト(num_ctx)を広げすぎないこと」です。コンテキスト長を16K以上に拡大すると、KVキャッシュ(文脈保持メモリ)が数GBのVRAMを追加消費し、8GBの容量を超えてCPUフォールバックが発生する恐れがあります。
VRAM 12GB〜16GB(実務開発PC/ミドルGPU):最強バランスの14Bクラス
エンジニアの開発環境やクリエイター向けPCで最も普及している「VRAM 12GB〜16GB(RTX 3060 12GB, RTX 4070 12GB, RTX 4070 Ti SUPER 16GB, RTX 4080 16GB、および統一メモリ24GBのApple Silicon Mac)」では、14Bクラスが圧倒的な実力を発揮します。
「Qwen 2.5:14b」や「DeepSeek-R1:14b」のQ4_K_Mファイルサイズは約9.0GBです。推論時のコンテキストメモリ(KVキャッシュ)を含めても約11GB〜13GBのVRAMでフル動作するため、12GB〜16GBのGPUであれば、全レイヤーをGPUメモリ上に完全配置したまま毎秒30〜45トークンの高速レスポンスを維持できます。
14Bモデルは、7Bモデルと比較して「複雑な論理展開」「複数条件の厳格な順守」「高度なPythonコードの記述」「社内RAGでの文脈把握」の精度が劇的に向上します。実務で社内利用に耐えうるAIアプリケーションを構築する場合、この14Bクラスが最も推奨されるベストバランスの選択肢です。
VRAM 24GB(ハイエンドRTX 4090/M3 Mac):GPT-4級の頭脳を持つ32Bクラス
個人のハイエンド開発機やAIワークステーションの標準である「VRAM 24GB(GeForce RTX 3090, RTX 4090, RTX A5000、または36GB〜48GBのApple Silicon Mac)」を保有している場合、ターゲットは「32Bクラス(Qwen 2.5:32b, DeepSeek-R1:32b)」となります。
32Bモデル(Q4_K_M)のサイズは約19.8GBです。KVキャッシュを考慮すると約22GB〜23GBのVRAMを消費し、24GBグラフィックボードの限界スペックをフル活用します。RTX 4090であれば毎秒25〜35トークンという極めて実用的な速度で推論が完了します。
この32Bクラスの知能は驚異的であり、一世代前の商用フラッグシップ(初期のGPT-4やClaude 3 Opus)に匹敵します。特に「Qwen 2.5-Coder:32b」を用いたアーキテクチャ設計やリファクタリング、あるいは「DeepSeek-R1:32b」による難関アルゴリズムの自動導出は圧巻のクオリティを誇ります。
VRAM 48GB以上(マルチGPU/Mac Studio):エンタープライズを支える70B〜72Bクラス
企業の社内GPUサーバー、データセンター、またはMac Studio(64GB/128GB/192GB)やマルチGPUマシン(RTX 3090/4090を2〜4枚搭載)を保有している環境では、オープンモデルの最高峰である「70B〜72Bクラス(Llama 3.3:70b, Qwen 2.5:72b, DeepSeek-R1:70b)」がフル稼働します。
70Bモデル(Q4_K_M)のファイルサイズは約43GB〜47GBであり、安定して長文コンテキスト(16K〜32Kトークン)を処理するには最低でも50GB〜60GB以上のVRAM空間が推奨されます。OllamaはマルチGPU(テンソル並列)に標準対応しているため、複数のグラフィックボードを搭載したマシンであれば、特別な設定なしで自動的にVRAMへモデルを均等分割ロードして高速推論を行います。
70Bクラスは、商用SaaSの最上位モデルと肩を並べる卓越した言語能力と自己検証力を誇り、全社規模のナレッジマネジメントや機密法務文書の自動精査基盤として本領を発揮します。
実務で必須のOllamaモデル管理コマンドとライフサイクル運用
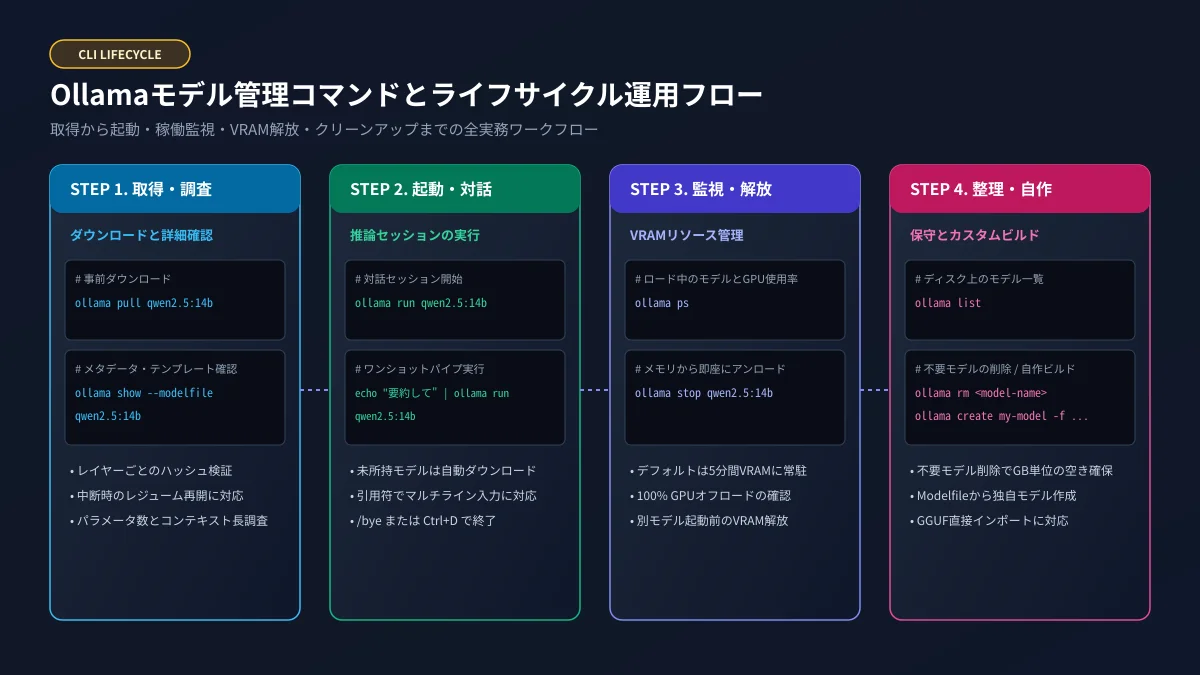
Ollamaの真の魅力は、Dockerのような直感的なCLIコマンド体系で、モデルのダウンロードから対話セッション、メモリ管理、不要モデルの削除までを一元管理できる点にあります。日々の運用で必ず使用する主要コマンドとその実務テクニックを解説します。
- モデルのダウンロードと詳細メタデータ確認(ollama pull / show)
- 対話セッションの起動とマルチライン入力・ショートカット(ollama run)
- VRAMメモリの即時解放と稼働中モデル監視(ollama ps / stop)
- ディスク容量の節約と不要モデルの安全な一括削除(ollama list / rm)
モデルのダウンロードと詳細メタデータ確認(ollama pull / show)
事前にモデルをダウンロードしておきたい場合は、ollama pull コマンドを使用します。
# Qwen 2.5 14Bモデルを事前にダウンロード
ollama pull qwen2.5:14b
Ollamaのダウンロード機能は、複数のレイヤー(ハッシュ値)に分割して並列転送を行うため、万が一ネットワークが途中で切断されても、再度同じコマンドを実行すれば未ダウンロードのレイヤーからレジューム再開されます。
また、ダウンロードしたモデルの内部構造やシステムプロンプト、コンテキスト長、ライセンス情報を確認したい場合は、ollama show コマンドを活用します。
# モデルのパラメータ数やアーキテクチャ詳細を表示
ollama show qwen2.5:14b

# モデルに埋め込まれているModelfile設定(テンプレート・システムプロンプト)を表示
ollama show --modelfile qwen2.5:14b
ollama show --modelfile を実行することで、公式がどのようなプロンプトテンプレート(ChatML構文など)やパラメータ(temperature, stopトークン)を設定しているかを丸裸にすることができ、後述するカスタムモデル自作の参考資料として役立ちます。コマンドの全体系については、関連記事『Ollamaコマンド完全網羅ガイド』で詳細に解説しています。
対話セッションの起動とマルチライン入力・ショートカット(ollama run)
モデルとの対話を開始する基本コマンドが ollama run です。ローカルにモデルが存在しない場合は、自動的にダウンロードが行われた上でセッションが立ち上がります。
# 対話セッションを起動
ollama run qwen2.5:14b
>>> 日本の代表的な伝統芸能について簡潔に説明してください。
ターミナル上での対話において、エンジニアが知っておくべき便利なテクニックがいくつかあります。
- マルチライン(複数行)入力: 三重引用符
"""を入力してEnterを押すと、複数行入力モードに入ります。長いコードや文章を貼り付けた後、再度"""を入力してEnterを押すことで一括送信できます。 - 対話セッションの終了:
/byeと入力してEnterキーを押すか、Ctrl + Dを押すことでセッションを終了できます。 - ワンショット実行(パイプ連携): 対話モードに入らず、標準入力からテキストを渡して結果だけを標準出力に受け取ることも可能です。
# ファイル内容を渡して要約させるワンライナー
cat error_log.txt | ollama run qwen2.5:14b "このエラーログの原因と対処法を箇条書きで示してください"
VRAMメモリの即時解放と稼働中モデル監視(ollama ps / stop)
「一度起動したモデルがGPUメモリに居座り続け、別の作業(ゲームや別のモデルの起動)ができない」という問題に直面した際は、ollama ps と ollama stop を使用します。
Ollamaはレスポンス速度を高めるため、一度実行されたモデルをデフォルトで5分間VRAM上に常駐(キャッシュ)させます。現在どのモデルがどれだけのVRAMを消費しているかを確認するには、以下のコマンドを実行します。
ollama ps
出力例:
NAME            ID              SIZE      PROCESSOR    UNTIL
qwen2.5:14b     843d90f1388b    9.0 GB    100% GPU     4 minutes from now
ここで PROCESSOR 欄が 100% GPU であれば、全レイヤーがGPUメモリ上で高速動作していることを示します。モデルを今すぐVRAMからアンロードしてメモリを完全に解放したい場合は、ollama stop コマンドを実行します。
# 指定モデルをVRAMから即座にアンロード
ollama stop qwen2.5:14b
このコマンドを実行した瞬間に、占有されていた数GB〜十数GBのVRAMが即座にOSへ返還されます。
ディスク容量の節約と不要モデルの安全な一括削除(ollama list / rm)
現在ローカルディスク上に保存されているモデルの一覧と、それぞれのディスク占有容量を確認するには、ollama list コマンドを使用します。
ollama list
出力例:
NAME                    ID              SIZE      MODIFIED
qwen2.5:14b             843d90f1388b    9.0 GB    2 hours ago
deepseek-r1:14b         ea03c80cf5a7    9.0 GB    1 day ago
llama3.3:70b            a6dd4724a872    43 GB     3 days ago
bge-m3:latest           82121e4c2598    1.2 GB    1 week ago
不要になったモデルや、過去にテスト目的でダウンロードした巨大モデルを削除したい場合は、ollama rm コマンドを実行します。
# 不要なモデルをディスクから完全に削除
ollama rm llama3.3:70b
Ollamaはコンテンツアドレス方式(Content-addressable storage)でレイヤーを管理しているため、同一ベースモデルから派生した複数のカスタムモデルがある場合でも、他のモデルが使用している共有レイヤーは誤って削除されない安全設計となっています。
モデルの自作カスタマイズ(Modelfile)と外部GUI・API連携実務
公式モデルをそのまま動かすだけでなく、自社業務に特化したプロンプトを焼き込んだ「独自モデル」の作成や、Hugging Faceからの最新GGUFインポート、そしてWebブラウザUI(Open WebUI)や外部アプリケーション(Dify / Python)との実務連携を行うことで、Ollamaの活用範囲は無限に広がります。
- Modelfileを用いた自社特化型プロンプトと独自モデルビルド(ollama create)
- Hugging Face上の数万種類のGGUFモデルを直接Ollamaへ取り込む手順
- ターミナル不要!Open WebUIと連携したChatGPT風社内チャット環境の構築
- OpenAI互換エンドポイントによるDify・Python・自律エージェント連携
Modelfileを用いた自社特化型プロンプトと独自モデルビルド(ollama create)
Ollamaの最も強力な機能の一つが、Dockerライクな設定ファイル「Modelfile」を用いて、独自のシステムプロンプトや推論パラメータを固定した自社専用モデルをビルドできる点です。
例えば、「常に日本のビジネスマナーを守り、結論から述べる社内専用アシスタント」を作りたい場合、以下のようなテキストファイル Modelfile を作成します。
# ベースモデルにQwen 2.5 14Bを指定
FROM qwen2.5:14b

# コンテキスト長を16Kトークンに拡張し、温度を低めに設定
PARAMETER num_ctx 16384
PARAMETER temperature 0.3
PARAMETER top_p 0.85

# 自社専用のシステムプロンプトを注入
PARAMETER stop "<|im_end|>"
SYSTEM \"\"\"
あなたは株式会社サンプルの社内AIアシスタントです。
以下のルールを厳格に遵守してください。
1. 日本語の敬語を正しく使い、結論ファースト(PREP法)で回答してください。
2. 根拠のない推測は含めず、不確実な場合は「情報が不足しています」と明記してください。
3. コードを提示する際は型ヒントとエラー処理を必ず記述してください。
\"\"\"
このファイルを元に、以下のコマンドを実行するだけで自作モデルがビルドされます。
# 自作モデルをビルド
# 書式: ollama create <新モデル名> -f ./Modelfile
ollama create my-biz-qwen:14b -f ./Modelfile

# ビルドした自社専用モデルを起動
ollama run my-biz-qwen:14b
毎回長いシステムプロンプトを入力する必要がなくなり、チームメンバー全員がワンコマンドで同一品質のAIアシスタントをローカル利用できるようになります。Modelfileの高度な構文やテンプレート設計については、関連記事『ollama createとModelfile徹底解説』で詳しく解説しています。
Hugging Face上の数万種類のGGUFモデルを直接Ollamaへ取り込む手順
Ollama公式ライブラリにまだ登録されていない最新モデルや、個人開発者がHugging Face上で公開しているファインチューニング済みGGUFモデルも、Ollamaへ直接インポートして実行することができます。
手順は驚くほど簡単です。Hugging FaceのモデルリポジトリからダウンロードしたいGGUFファイルを指定し、直接実行します。
# Hugging Faceから直接指定して実行する例
# 書式: ollama run hf.co/<ユーザー名>/<リポジトリ名>:<ファイル名>
ollama run hf.co/bartowski/Qwen2.5-Coder-32B-Instruct-GGUF:Q4_K_M
また、すでにローカルディスクにダウンロード済みの .gguf ファイルがある場合は、以下のように1行のModelfileを作成してインポートします。
# Modelfile
FROM /path/to/downloaded-model.gguf
# ローカルのGGUFからOllamaモデルを生成
ollama create custom-model -f ./Modelfile
この機能により、世界中のAIコミュニティが日夜生み出す最新の実験的モデルを、公開直後に手元のOllama環境へシームレスに取り込むことが可能となります。
ターミナル不要!Open WebUIと連携したChatGPT風社内チャット環境の構築
「黒い画面(ターミナル)での対話ではなく、ChatGPTのような洗練されたWebブラウザ画面で使いたい」という非エンジニアや一般社員向けには、オープンソースの最高峰Web UIである「Open WebUI」との連携が最適です。
Dockerがインストールされている環境であれば、以下のコマンド1行でOpen WebUIが立ち上がります。
# Open WebUIをDockerで起動し、ホストのOllamaに接続
docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway \
  -v open-webui:/app/backend/data \
  --name open-webui --restart always \
  ghcr.io/open-webui/open-webui:main
ブラウザで http://localhost:3000 を開くだけで、Ollamaに保存されているすべてのモデル(Qwen 2.5, DeepSeek-R1等)がプルダウンメニューに自動表示されます。チャット履歴の管理、ドキュメントのアップロード(簡易RAG)、プロンプトテンプレートの保存、複数ユーザーの権限管理など、商用サービスに匹敵するフル機能を完全ローカル・無料で実現できます。
OpenAI互換エンドポイントによるDify・Python・自律エージェント連携
Ollamaは、バックグラウンドで標準的に OpenAI互換のREST APIサーバー(ポート11434)として常駐しています。これにより、既存のOpenAI向けに書かれたプログラムやアプリケーションを、コードを書き換えることなくローカルLLMへ差し替えることができます。
from openai import OpenAI

# ローカルOllamaの互換エンドポイントを指定
client = OpenAI(
    base_url="http://localhost:11434/v1",
    api_key="ollama"  # ダミーキー
)

response = client.chat.completions.create(
    model="qwen2.5:14b",
    messages=[
        {"role": "system", "content": "あなたは優秀な社内アナリストです。"},
        {"role": "user", "content": "四半期売上データの異常値を検知するチェックリストを作成してください。"}
    ],
    temperature=0.3
)

print(response.choices[0].message.content)
さらに、ノーコードAI開発基盤である「Dify」や、自律型AIエージェント標準の「Model Context Protocol(MCP)」と接続することで、社内データベースやローカルファイルシステムと連携した高度な自律エージェントを構築できます。MCPの設定方法については、関連記事『mcp.json徹底解説』も併せてご覧ください。

まとめ
本記事では、2026年現在のオープンソースLLM実行基盤における絶対的標準「Ollama」のモデル選びと運用技術をテーマに、GGUFや量子化のアーキテクチャから、用途別最強モデル(Qwen 2.5, DeepSeek-R1, Llama 3.3, BGE-M3)、VRAMスペックに応じたサイジング基準、実務CLIコマンド、Modelfile自作、そしてGUIやAPI連携に至るまでを網羅的に解説しました。
クラウド型生成AIのAPIコスト高騰やセキュリティ規程の制約に悩む企業にとって、手元のハードウェアリソースを最大限に活かして自律運用できるOllamaは、まさに自社主権のAI基盤を確立するための最強の武器です。
まずはワンコマンド ollama run qwen2.5:7b や 14b から手元のPCで動かしてみて、その流暢な日本語とスピードを体感してください。そして、自社専用のModelfile作成や社内閉域RAGへとステップを進め、安心安全で超高効率な次世代のAI活用環境を確立していきましょう。
ローカルLLM導入・自社特化型AI環境の構築でお悩みですか?
「社内規程や重要データをクラウドに送信せず、完全ローカル・セキュアなAI環境を構築したい」「Qwen 2.5やDeepSeek-R1の自社業務特化ファインチューニングや社内閉域RAGを最短で本番導入したい」とお考えの企業様へ。要件定義からハードウェア選定、Modelfile最適化、社内システム連携まで、専門エンジニアがワンストップで伴走支援いたします。
社内規程・技術文書・実験データを安全に検索できる「自社専用RAG」を構築しませんか?
数千万円の丸投げ開発やブラックボックス化を回避。PMP®保有PMが月額20万円の伴走アドバイザリーで要所設計・権限管理を支援します。